Кросс-валидация (cross-validation) — это метод оценки качества модели машинного обучения, при котором исходные данные несколько раз делят на обучающую и проверочную части. На каждом этапе модель обучается на одной части выборки, а ее качество измеряют на другой. Затем результаты объединяют, чтобы получить более обоснованную оценку работы алгоритма.
Метод помогает сравнивать модели, подбирать гиперпараметры и проверять, насколько устойчиво алгоритм работает на разных данных. Здесь используется перекрестная проверка, когда обучающая выборка небольшая и результат одного случайного разбиения может оказаться ненадежным.
При этом кросс-валидация не гарантирует высокую точность и не исключает переобучение автоматически. Результат зависит от способа разделения данных, выбранной метрики и правильности эксперимента.
Зачем нужна кросс-валидация
В машинном обучении недостаточно проверить, насколько хорошо алгоритм предсказывает ответы на примерах, которые уже использовал при обучении. Модель может запомнить особенности обучающей выборки, но допускать много ошибок на новых наблюдениях. Это одна из причин переобучения.
Для оценки способности модели стоит разделить датасет на обучающую и тестовую выборки. Например, в датасете 1000 записей о клиентах. Если случайно отвести 200 записей на проверку, в тестовую часть могут попасть преимущественно простые случаи. При другом разбиении там окажутся клиенты с нетипичным поведением, и качество модели снизится.
Кросс-валидация позволяет проверить алгоритм на нескольких разбиениях и увидеть, насколько меняются результаты.
Метод применяется, чтобы:
- Оценить качество модели. Понять, насколько хорошо алгоритм справляется с задачей за пределами обучающих данных.
- Сравнить алгоритмы. Проверить, какая модель лучше решает одну и ту же задачу при одинаковых условиях эксперимента.
- Подобрать гиперпараметры. Найти подходящие значения глубины дерева, силы регуляризации, числа соседей и других настроек.
- Оценить стабильность. Выяснить, насколько сильно результат зависит от состава выборки.
- Работать с небольшими датасетами. Использовать наблюдения для обучения и проверки в разных итерациях, не выделяя отдельную валидационную часть для каждого эксперимента.
Как работает кросс-валидация простыми словами
Рассмотрим задачу прогнозирования стоимости квартиры. Есть 1000 объектов с характеристиками: площадь, район, этаж, состояние жилья и цена.
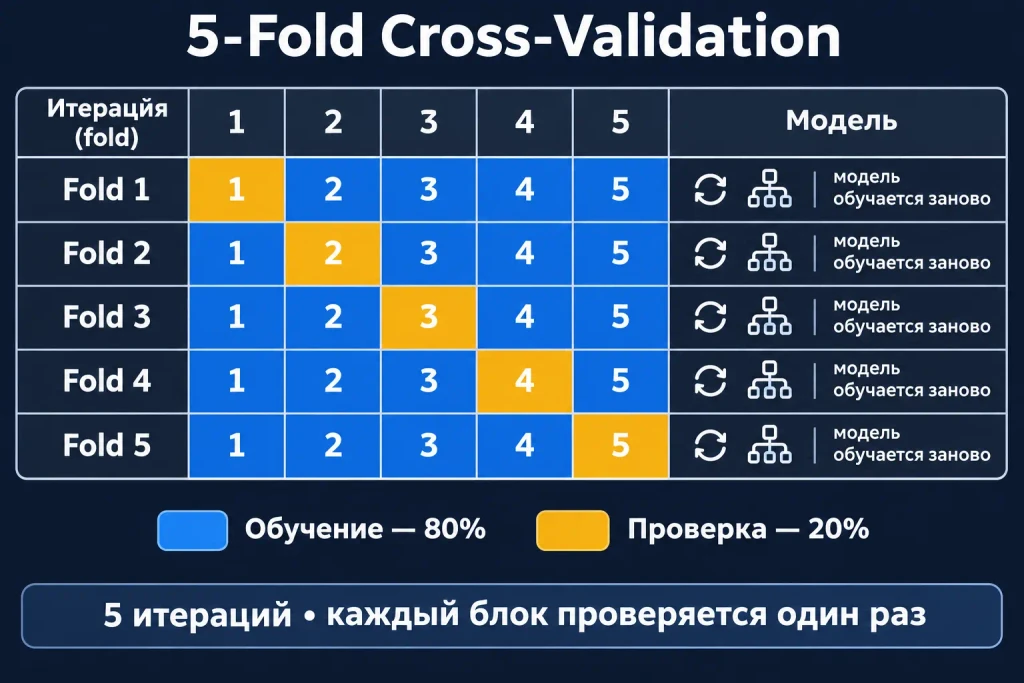
Для проверки используем четырехблочную кросс-валидацию — 4-fold cross-validation.
Процедура состоит из нескольких шагов:
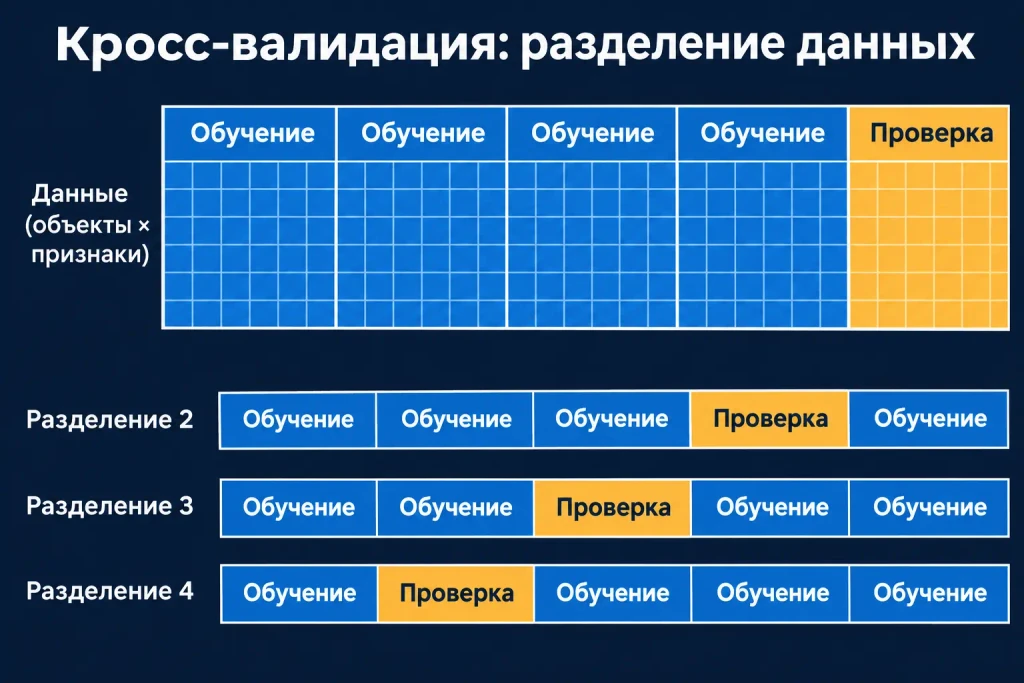
- Данные делят на четыре примерно равные части — фолда (fold).
- На первой итерации модель обучают на блоках 2, 3 и 4, а качество проверяют на блоке 1.
- На второй итерации проверочным становится блок 2. Модель заново обучают на блоках 1, 3 и 4.
- Аналогично выполняют оставшиеся итерации.
- Четыре значения метрики объединяют, например рассчитывают среднее и стандартное отклонение.
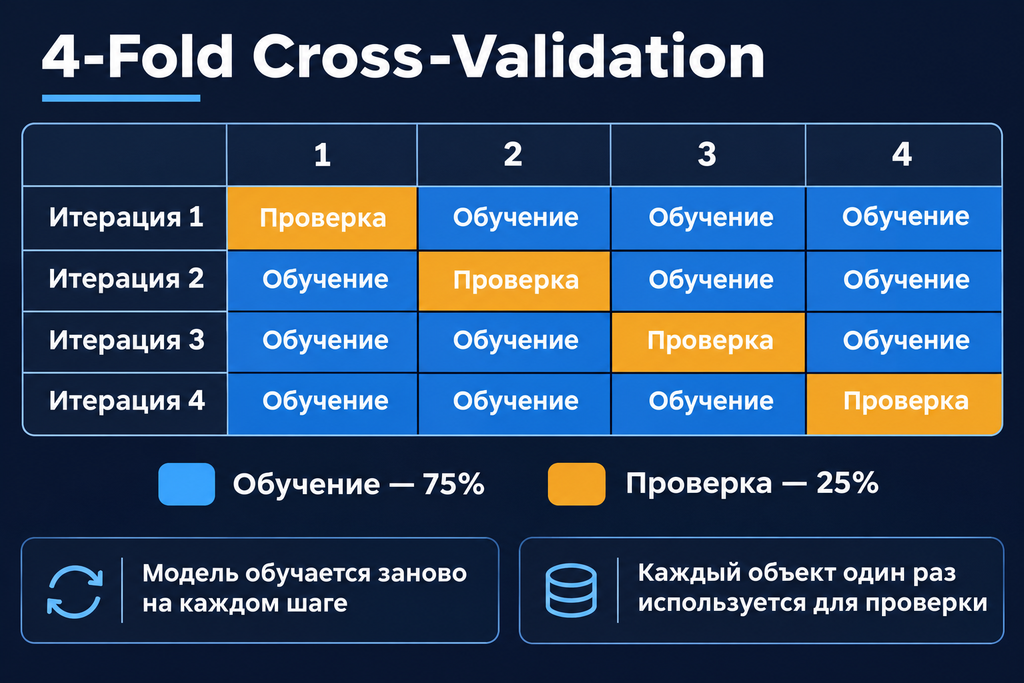
В результате каждое наблюдение один раз используется для проверки и три раза — для обучения. Это справедливо для обычного KFold без повторов, если выборка делится на четыре блока.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
На каждой итерации обучается новая модель. Нельзя просто продолжить обучение предыдущей на следующем блоке, если задача состоит в стандартной оценке с независимыми обучающими процедурами.
Что такое K-fold и сколько фолдов выбирать
K-fold — наиболее распространенный метод кросс-валидации. Название означает разделение выборки на k частей, где k — заданное число фолдов.
Например, при 5-fold данные делят на пять блоков. На каждой итерации модель обучается на 80% наблюдений и проверяется на оставшихся 20%. При 10-fold на каждом этапе для обучения используют около 90% данных.
Чем больше фолдов, тем больше запусков обучения потребуется. Но их увеличение не всегда улучшает оценку.
| Число фолдов | Особенности |
| 3 | Меньше вычислений, но модель обучается на меньшей доле данных |
| 5 | Практичный вариант для многих стандартных задач |
| 10 | Позволяет использовать для обучения большую часть выборки на каждой итерации |
| N (LOO) | Каждая запись становится отдельным проверочным блоком |
Для начала обычно достаточно 5-fold. Десять фолдов могут быть полезны при небольших и средних выборках, если позволяют ресурсы.
Leave-One-Out (LOO) — частный случай K-fold, при котором число фолдов равно числу наблюдений. Если в выборке 500 строк, придется обучить 500 моделей.
У LOO есть недостаток: вычислительная стоимость и высокая вариативность оценки в некоторых задачах. Поэтому использовать его по умолчанию не стоит. Чаще выбирают 5- или 10-кратную проверку.
Основные виды кросс-валидации
Обычный K-fold подходит не для всех наборов данных. Если в выборке есть дисбаланс классов, повторяющиеся объекты, группы или временная зависимость, необходимо учитывать структуру данных.
1. K-Fold
Стандартный вариант. Наблюдения делят на k частей, после чего поочередно используют их для проверки. При необходимости перед разбиением данные перемешивают.
Подходит для многих задач регрессии и классификации, если наблюдения достаточно независимы и одинаково распределены.
2. Stratified K-Fold (стратифицированная кросс-валидация)
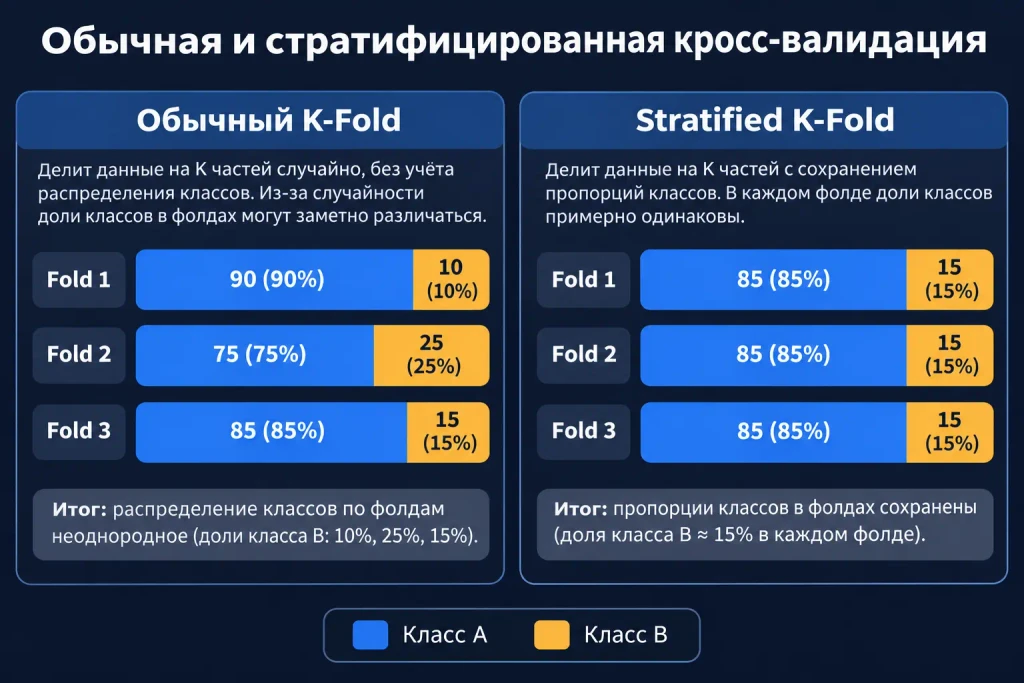
Этот метод сохраняет примерно одинаковое соотношение классов в каждом фолде.
Предположим, в датасете 90% обычных транзакций и 10% мошеннических. При случайном разбиении некоторые проверочные блоки могут содержать слишком мало мошеннических операций. Из-за этого оценка качества классификатора станет нестабильной.
Стратификация помогает избежать такой ситуации, если объем каждого класса позволяет сформировать корректные блоки. Она полезна для задач обнаружения мошенничества, фильтрации спама и диагностики по данным с дисбалансом классов.
3. Group K-Fold (групповая кросс-валидация)
Используется, когда несколько записей относятся к одному объекту или субъекту. Например, датасет содержит фотографии разных людей, записи пациентов или несколько операций одного клиента.
Если случайно распределить такие наблюдения между обучением и проверкой, модель может узнать характеристики конкретного человека или клиента. Результат окажется лучше, чем при работе с новыми объектами.
Group K-Fold распределяет группы целиком: наблюдения одной группы не должны одновременно находиться в обучающей и проверочной частях одного разбиения.
4. Time Series Split (разбиение для временных рядов)
Применяется при прогнозировании спроса, цен, нагрузки серверов и других показателей, зависящих от времени.
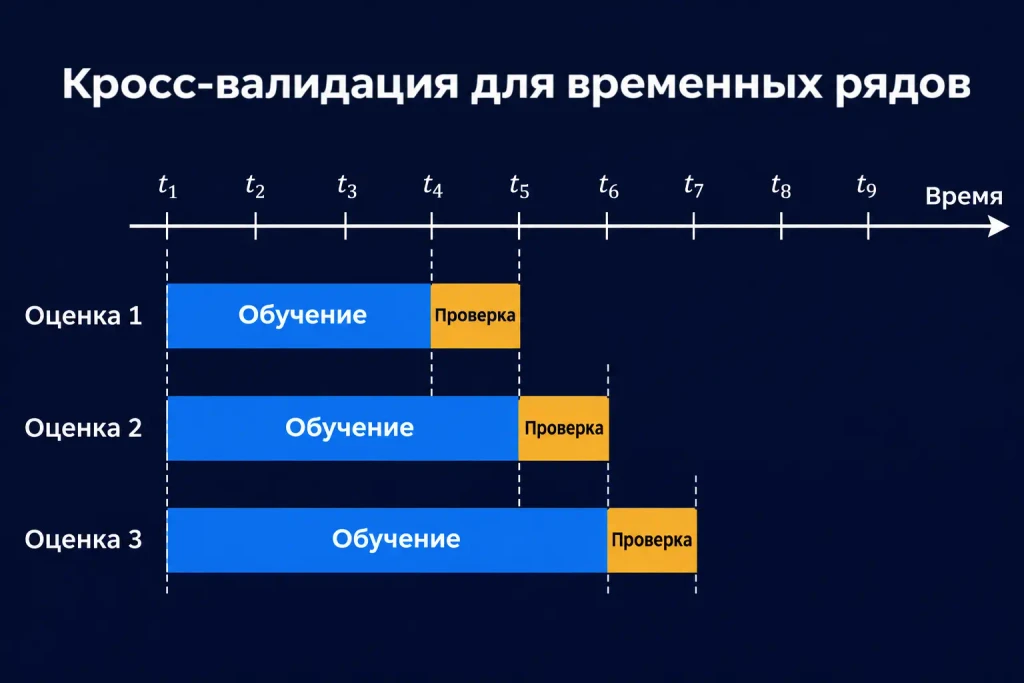
Обычный K-fold может привести к утечке информации из будущего. Например, модель обучается на декабрьских наблюдениях, а проверяется на октябрьских. Для прогноза будущего такая оценка некорректна.
Временная кросс-валидация строится с учетом хронологии: модель обучают на прошлых данных, а проверяют на более поздних. В зависимости от задачи обучающее окно может постепенно расширяться или оставаться фиксированным.
5. Repeated K-Fold (повторная кросс-валидация)
Разбиение выполняют несколько раз с разными вариантами распределения наблюдений. Это позволяет изучить, насколько сильно оценка зависит от конкретного разбиения.
Повторение увеличивает вычислительную нагрузку и не делает результаты независимыми. Обучающие и проверочные наборы между итерациями могут пересекаться.
Выбирать способ разбиения следует исходя из того, на каких данных модель будет работать после внедрения. Временные и групповые зависимости важнее удобства стандартного K-fold.
Как выполнить кросс-валидацию в Python
Для работы с кросс-валидацией удобно использовать библиотеку scikit-learn. Ниже пример для задачи классификации.
from sklearn.datasets import load_iris
from sklearn.model_selection import (
    StratifiedKFold,
    cross_val_score
)
from sklearn.ensemble import RandomForestClassifier

X, y = load_iris(return_X_y=True)

model = RandomForestClassifier(
    n_estimators=100,
    random_state=42
)

cv = StratifiedKFold(
    n_splits=5,
    shuffle=True,
    random_state=42
)

scores = cross_val_score(
    model,
    X,
    y,
    cv=cv,
    scoring="accuracy"
)

print("Результаты:", scores)
print("Среднее:", scores.mean())
print("Стандартное отклонение:", scores.std())
В этом примере:
- StratifiedKFold создает пять фолдов с сохранением пропорций классов;
- shuffle=True включает перемешивание;
- random_state позволяет воспроизвести разбиение;
- cross_val_score обучает модель и рассчитывает метрику для каждого фолда;
- scoring=»accuracy» задает критерий оценки.
Для других задач можно выбрать f1, roc_auc, precision, recall, neg_mean_absolute_error и другие метрики. Для регрессии часто используют MAE, RMSE и R².
Курс «Python Ninja» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Пример показывает оценку модели на одном наборе данных. Если требуется окончательная проверка качества, перед подбором параметров необходимо выделить отдельную тестовую выборку.
Ошибки при кросс-валидации и как их избежать
Даже правильно реализованная перекрестная проверка может дать недостоверный результат, если допущены ошибки в подготовке данных или организации эксперимента.
Утечка данных. Одна из распространенных проблем. Например, разработчик сначала нормализует весь датасет, рассчитывает средние значения и стандартные отклонения, а затем выполняет кросс-валидацию. В таком случае информация из проверочных фолдов влияет на подготовку обучающих данных.
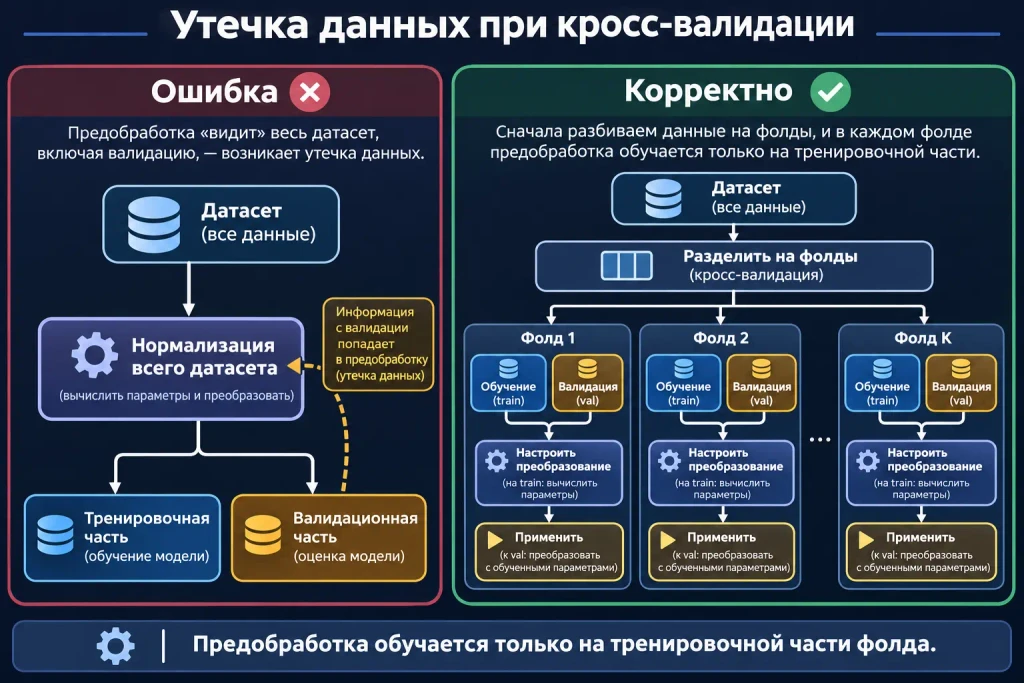
Решение — выполнять предобработку внутри каждого фолда. Для этого в scikit-learn используют Pipeline, который объединяет преобразования и модель в единый процесс. Импутация пропусков, масштабирование, отбор признаков и другие обучаемые преобразования должны настраиваться только на тренировочной части соответствующего разбиения.
Подбор параметров на тестовой выборке. Если многократно сравнивать модели на одном тесте и выбирать победителя, итоговая оценка становится оптимистичной. Для настройки используют кросс-валидацию, а тест оставляют для финальной проверки.
Игнорирование зависимостей между наблюдениями. Несколько кадров одного видео, фотографии одного человека или измерения одного устройства могут оказаться в разных фолдах. Модель получит возможность использовать сходство между обучающими и проверочными примерами. Для таких данных нужны групповые или другие специальные схемы разделения.
Неподходящая метрика. Accuracy может вводить в заблуждение при сильном дисбалансе. Например, если 99% операций нормальные, классификатор, всегда предсказывающий норму, покажет 99% accuracy, но не обнаружит ни одного мошенничества. В таком случае стоит дополнительно оценивать precision, recall, F1 и PR-AUC.
Слишком маленькое число наблюдений редкого класса. Если мошеннических операций всего несколько, разделение на множество фолдов может оказаться некорректным. Необходимо учитывать количество объектов каждого класса и выбирать схему с учетом ограничений данных.
Чем кросс-валидация отличается от обычной проверки
Обычная проверка hold-out предполагает одно разделение на обучающую и проверочную части. Кросс-валидация включает несколько итераций с разными проверочными блоками.
У обоих подходов есть свои преимущества.
Hold-out проще, быстрее и подходит для больших датасетов. Если данных достаточно много, одно качественное разбиение может дать вполне надежную оценку.
Кросс-валидация позволяет использовать разные части обучающего набора для проверки. Это удобно при небольшом объеме данных, сравнении алгоритмов и подборе гиперпараметров.
При этом кросс-валидация требует больше вычислений. Если обучение большой нейросети занимает несколько часов, пять фолдов могут увеличить время эксперимента в несколько раз. Кроме того, кросс-валидация не заменяет независимую проверку на новых данных.
Для сложных экспериментов применяют вложенную кросс-валидацию (nested cross-validation). Внутренний цикл используют для подбора гиперпараметров, внешний — для оценки качества всего процесса выбора. Такой подход снижает смещение оценки при настройке, хотя тоже требует дополнительных вычислений.
Когда кросс-валидация не нужна
Метод полезен не во всех ситуациях. От него можно отказаться или заменить другой схемой, если:
- датасет очень большой и репрезентативный, а вычислительные ресурсы ограничены;
- данные представляют временной ряд, для которого нужна проверка на будущих периодах;
- наблюдения имеют сложную групповую структуру;
- требуется оценить качество модели на конкретном независимом наборе данных;
- обучение модели слишком дорогое, а предварительная оценка уже получена на подходящей выборке.
В некоторых задачах вместо обычной кросс-валидации используют отдельный временной тест, групповое разбиение или последовательную проверку. Выбор зависит от сценария применения модели.
Заключение
Кросс-валидация — один из основных методов оценки качества моделей в машинном обучении. Она позволяет проверить алгоритм на нескольких разбиениях данных, сравнить результаты и выявить зависимость качества от состава выборки.
Для большинства стандартных задач разумной отправной точкой будет 5-fold cross-validation. При дисбалансе классов стоит рассмотреть стратификацию, при наличии повторяющихся субъектов — групповую проверку, а для временных рядов — разбиение с учетом хронологии.
Главное — не воспринимать среднюю метрику как гарантию качества. Надежная оценка начинается с корректной подготовки данных, отсутствия утечек и выбора схемы проверки, которая соответствует реальным условиям работы модели.
FAQ
Оцените не только среднюю метрику, но и разброс результатов между фолдами. Проверьте, соответствует ли выборка реальным данным, нет ли утечек и сохраняется ли качество при другом разбиении. Для ответственных задач полезно провести дополнительную проверку на независимом датасете.
Да, если изменение признаков влияет на модель или ее качество. Новые признаки могут улучшить предсказания, но также привести к переобучению.
Метрика должна соответствовать цели задачи. Для сбалансированной классификации может подойти accuracy, для несбалансированных классов — F1, precision, recall или PR-AUC. В регрессии часто используют MAE и RMSE.