Голосовой помощник принимает речь, обрабатывает запрос и отвечает вслух. Для первой версии достаточно готового распознавания и нескольких заданных команд — обучать собственную нейросеть не потребуется. Разберём устройство такого помощника, покажем учебный пример на Python и объясним, что понадобится для свободного диалога с ИИ. В качестве примера возьмём небольшого ассистента, который объясняет маркетинговые термины.
Из чего состоит голосовой помощник
Голосовой помощник — это программа, с которой пользователь взаимодействует с помощью речи. Она может отвечать на вопросы, находить сведения или выполнять подключённые действия. Набор возможностей определяет разработчик: наличие голосового интерфейса само по себе не даёт программе доступа к документам, сообщениям и рабочим сервисам.
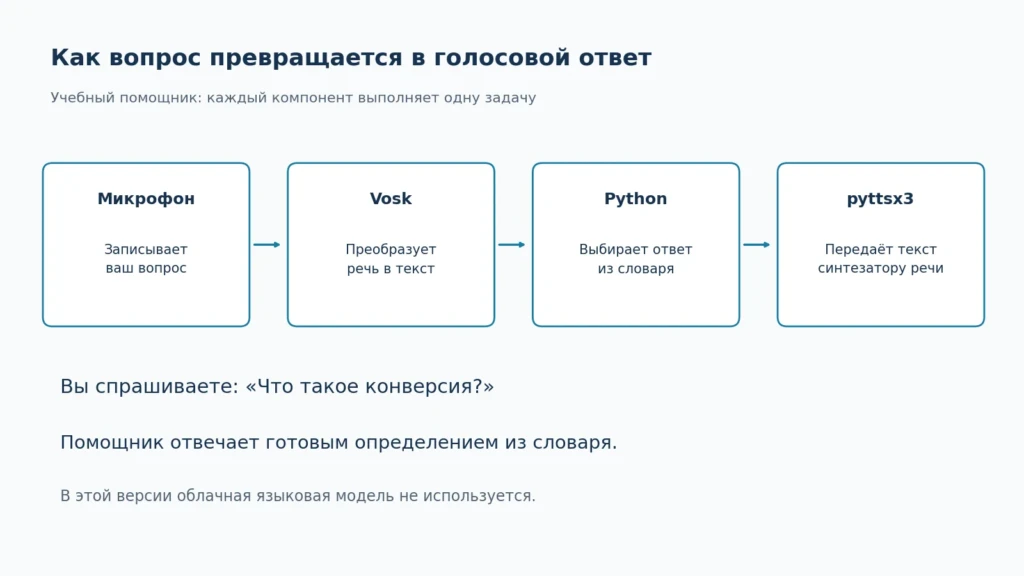
Для первого проекта удобно разделить работу помощника на четыре этапа:
- Микрофон записывает вопрос.
- Распознавание преобразует речь в текст.
- Программа выбирает или создаёт ответ.
- Синтезатор речи произносит подготовленный текст.
Такую последовательность называют каскадной архитектурой. Её удобно проверять по частям: если вместо нужного объяснения звучит другой ответ, можно посмотреть распознанный текст и определить, на каком этапе появилась ошибка.
Например, вы спрашиваете: «Что такое конверсия?». Распознавание возвращает текст вопроса, обработчик находит соответствующее объяснение, а синтезатор озвучивает его. На третьем этапе может работать обычный словарь с готовыми ответами или языковая модель — нейросеть, которая обрабатывает текстовые запросы.
Ещё есть подход, когда модели принимают аудио и возвращают аудиоответ без отдельно управляемой текстовой цепочки. Для первого знакомства каскадная схема нагляднее: её компоненты можно проверять и заменять независимо.
С чего начать создание собственного помощника
Начните с одной задачи, результат которой можете проверить самостоятельно. Например, справочный помощник для начинающего маркетолога отвечает на несколько вопросов из небольшого словаря. Ему не нужны клиентские данные и доступ к рекламным кабинетам, поэтому эксперимент не затрагивает рабочие аккаунты.
Для первой версии зафиксируем понятные ограничения: запись запускается по команде пользователя, длится пять секунд, после чего программа показывает распознанный текст и отвечает вслух. Если вопроса нет в словаре, помощник сообщает об этом. Свободного разговора и поиска по интернету пока не будет.
Проверять такую версию лучше на коротких русских фразах. Сначала произнесите «привет», затем — «что такое конверсия». Профессиональные сокращения вроде CTR оставьте для следующих тестов: так будет проще отличить ошибку распознавания термина от ошибки в обработчике команд.
Можно ли создать голосового помощника без программирования
Создать голосового помощника без программирования можно с помощью визуальных конструкторов голосовых агентов. В них настраивают инструкции, голос и связи с другими сервисами. Например, существуют сценарии, объединяющие голосовых агентов ElevenLabs и автоматизации n8n; набор доступных функций зависит от выбранных инструментов.
Настройка помощника в готовом сервисе и разработка отдельного приложения дают разную степень контроля. В конструкторе вы работаете с доступными блоками и ограничениями платформы. При самостоятельной разработке нужно организовать запись, обработку запроса и озвучивание, зато можно менять каждый компонент.
В обоих случаях полезно сначала проверить задачу в текстовом режиме. Для справочного помощника подготовьте несколько определений и инструкцию:
Отвечайте на вопросы о маркетинговых терминах по переданному справочнику. Используйте русский язык и укладывайтесь в два-три предложения. Если определения нет в справочнике, сообщайте об этом. Не придумывайте показатели рекламных кампаний и сведения о клиентах.
Инструкция описывает желаемое поведение, но результат нужно проверять на вопросах. Начните с практики постановки запросов к нейросетям: работа с исходными данными и уточнение задания пригодятся и при настройке ассистента.
До подключения голоса задайте помощнику знакомый вопрос, переформулируйте его и спросите о термине, которого нет в справочнике. Так вы проверите, использует ли он переданные определения и сообщает ли об отсутствии данных.
Курс «Практикум по нейросетям» в Академии IT DMS
Цифровой сертификат после итогового теста.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Как сделать голосового помощника на Python
Для учебной версии используем три библиотеки: sounddevice записывает звук с микрофона, Vosk распознаёт речь, а pyttsx3 озвучивает ответ через системный синтезатор. Распознавание с микрофона с помощью sounddevice показано в официальном примере Vosk, а pyttsx3 поддерживает локальное озвучивание.
Ниже — пример для Windows с установленным Python и доступным русским голосом синтеза речи. Он запускает запись после нажатия Enter, обрабатывает одну фразу и затем ждёт следующей команды. Аудио не сохраняется в файл, облачные сервисы не вызываются.
Подготовьте библиотеки и модель
Создайте папку проекта и откройте в ней PowerShell. Чтобы библиотеки этого проекта не смешивались с другими, создайте виртуальное окружение — отдельный набор Python и установленных пакетов:
python -m venv .venvУстановите зависимости через Python этого окружения:
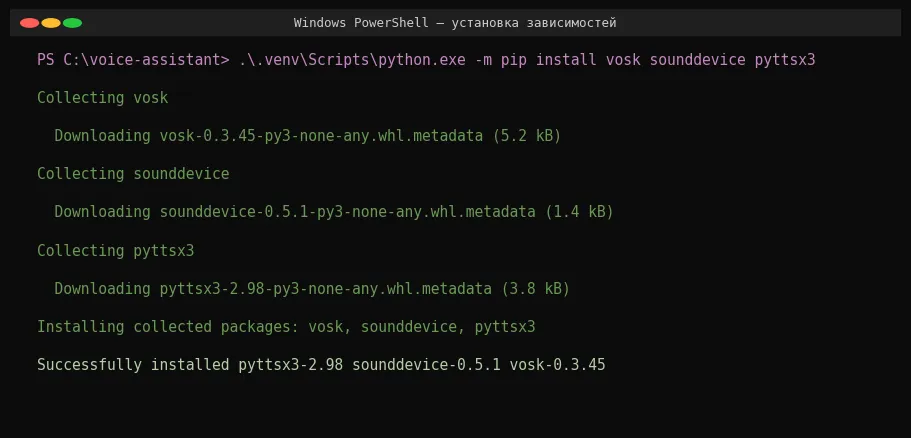
Активировать окружение отдельной командой не требуется. Такой способ также позволяет обойтись без изменения политики запуска PowerShell-скриптов.
Из официального каталога Vosk скачайте русскую модель vosk-model-small-ru-0.22. Это небольшая модель для локального распознавания; в каталоге указан размер 45 МБ. Распакуйте архив и переименуйте полученную папку в model. Внутри неё должны находиться каталоги самой модели, включая am и conf.
Рядом создайте файл assistant.py. Структура проекта получится такой:
voice-assistant/

├── .venv/

├── model/

│   ├── am/

│   ├── conf/

│   └── ...

└── assistant.py
Перед запуском проверьте, что в Windows выбран нужный микрофон и приложениям рабочего стола разрешено его использовать. Для первого теста достаточно встроенного микрофона или гарнитуры и тихого помещения.
Пример ниже записывает пять секунд звука после нажатия Enter. Затем Vosk преобразует запись в текст, программа ищет соответствующий ответ в словаре и передаёт его синтезатору речи. Частота записи берётся из параметров выбранного по умолчанию микрофона — такой подход используется и в официальном примере Vosk.
import json

import re

from pathlib import Path

import sounddevice as sd

import pyttsx3

from vosk import Model, KaldiRecognizer

BASE = Path(__file__).resolve().parent

def make_answer(text):

    text = re.sub(r"[^\w\s]", " ", text.lower())

    text = " ".join(text.split())

    answers = {

        "привет": "Здравствуйте! Спросите, что такое конверсия.",

        "что такое конверсия": (

            "Конверсия показывает, какая доля пользователей "

            "выполнила выбранное целевое действие."

        ),

        "объясни конверсию": (

            "Конверсия показывает, какая доля пользователей "

            "выполнила выбранное целевое действие."

        ),

    }

    return answers.get(text, "Для этого вопроса пока нет ответа.")

def main():

    model = Model(str(BASE / "model"))

    rate = int(sd.query_devices(kind="input")["default_samplerate"])

    engine = pyttsx3.init()

    voices = engine.getProperty("voices")

    for index, voice in enumerate(voices):

        print(index, voice.name, voice.id)

    choice = input("Номер русского голоса из списка: ").strip()

    engine.setProperty("voice", voices[int(choice)].id)

    while True:

        command = input(

            "Enter — запись на 5 секунд; q — выход: "

        ).strip()

        if command.lower() == "q":

            break

        print("Говорите...")

        audio = sd.rec(

            int(5 * rate),

            samplerate=rate,

            channels=1,

            dtype="int16",

        )

        sd.wait()

        recognizer = KaldiRecognizer(model, rate)

        fragments = []

        if recognizer.AcceptWaveform(audio.tobytes()):

            fragments.append(

                json.loads(recognizer.Result()).get("text", "")

            )

        fragments.append(

            json.loads(recognizer.FinalResult()).get("text", "")

        )

        text = " ".join(part for part in fragments if part).strip()

        print("Распознано:", text or "[пусто]")

        if not text:

            continue

        answer = make_answer(text)

        print("Ответ:", answer)

        engine.say(answer)

        engine.runAndWait()

if __name__ == "__main__":

    main()
Запустите файл из папки проекта:
.\.venv\Scripts\python.exe assistant.pyПрограмма выведет список системных голосов. Найдите русский и введите его номер из первого столбца. pyttsx3 использует установленные в системе голоса, поэтому список на разных компьютерах различается; если русского голоса нет, сначала установите подходящий голос для системного синтезатора.
После выбора голоса нажмите Enter, дождитесь надписи «Говорите…» и произнесите «привет». Когда запись закончится, программа покажет распознанную фразу и выбранный ответ. Для выхода введите q вместо запуска следующей записи.
Как понять результат
При успешном распознавании слова «привет» в терминале должны появиться строки такого содержания:
Распознано: приветОтвет: Здравствуйте! Спросите, что такое конверсия.Это ожидаемый результат, а не отчёт о запуске на вашем компьютере. Если ответ отображается, но не звучит, проверяйте выбранный голос и устройство воспроизведения. Если распознан другой текст, сначала проверьте микрофон, громкость речи и язык модели.
Затем задайте вопрос «что такое конверсия». В этой версии ответ выбирается по точному совпадению текста после удаления пунктуации и лишних пробелов. Формулировка «объясни конверсию» тоже добавлена в словарь, а на «расскажи про конверсию» готового ответа пока нет.
Такой обработчик подходит для небольшого набора команд. Добавляя новую фразу, вы расширяете словарь, но не обучаете нейросеть. Для свободных формулировок понадобится более гибкая обработка запросов.
Как подключить искусственный интеллект
Чтобы помощник отвечал на разные формулировки вопросов, вместо словаря можно подключить языковую модель. Схема сохранится: распознавание возвращает текст, модель готовит ответ, синтезатор произносит его. Это один из стандартных способов добавить голос к текстовому ИИ-приложению.platform.openai+1
В нашем примере заменить нужно функцию make_answer(). Сейчас она выбирает готовую строку. В версии с ИИ она должна передать вопрос модели вместе с инструкцией и справочником, получить текст ответа и вернуть его программе.
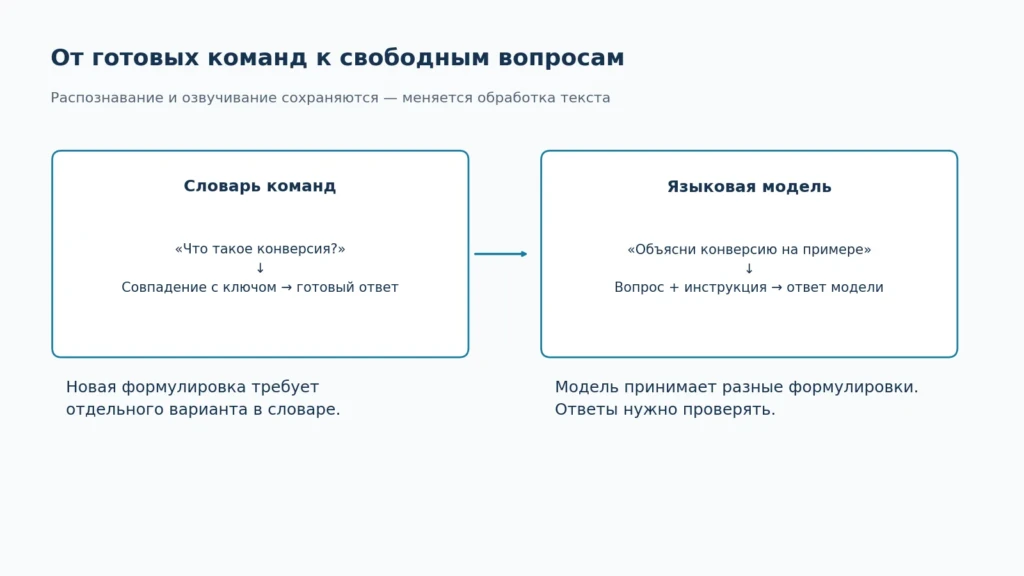
До подключения к голосовой цепочке проверьте этот обмен отдельно. Помощник должен правильно объяснять знакомые термины, принимать разные формулировки и сообщать, если нужного определения нет. Иначе к ошибкам генерации добавятся ошибки распознавания, и искать причину станет труднее.
Для облачной модели понадобится API — интерфейс, через который программа отправляет запросы сервису. Ключ доступа храните вне публичного кода и не публикуйте его вместе с проектом. Перед передачей рабочих документов проверьте условия обработки данных и разрешение компании на использование внешнего сервиса.
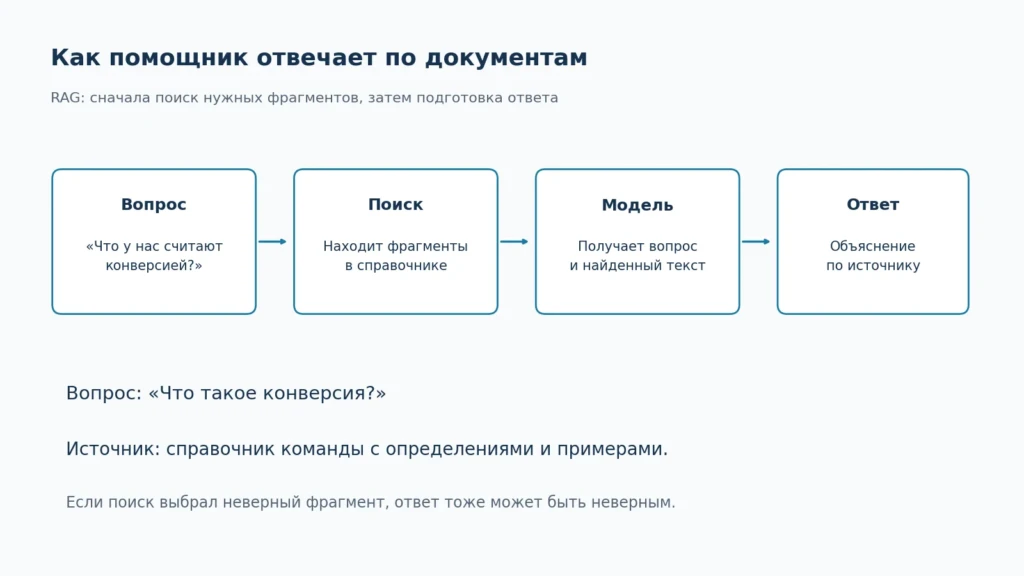
Если справочник вырастет до набора документов, можно добавить RAG — поиск подходящих фрагментов перед подготовкой ответа. Например, помощник сначала найдёт определение в базе знаний команды и только потом сформулирует объяснение. Такой подход требует отдельной проверки поиска: если выбран неподходящий фрагмент, ответ тоже может оказаться неверным.
Как добавить действия и работу с документами
Для выполнения действий помощнику нужны отдельные функции и права доступа. Например, после объяснения термина он может подготовить черновик заметки, а после вашего подтверждения — сохранить её в выбранный сервис. Языковая модель обрабатывает запрос, но обращение к сервису выполняет приложение через подключённый инструмент.
Начните с подготовки черновика без автоматической отправки. Сначала вы увидите, правильно ли помощник понял запрос и какой текст собирается сохранить. Затем можно добавить подтверждение и само действие.
Для нашей справочной версии последовательность развития выглядит так:
- Ответы на несколько вопросов из словаря.
- Обработка разных формулировок через языковую модель.
- Поиск определений в документах команды.
- Подготовка заметки с объяснением.
- Сохранение заметки после подтверждения.
Каждый этап добавляет одну возможность, которую можно проверить отдельно. Не подключайте одновременно базу знаний, несколько внешних сервисов и автоматическую отправку: при ошибке будет сложнее определить её источник.
Для дальнейшей разработки понадобятся основы Python, работа с API и обработка ошибок. Если помощник будет искать сведения в документах и обращаться к внешним сервисам, дополнительно потребуется разобраться в RAG, подключении инструментов и ограничении прав доступа.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Что проверять, если помощник не работает
Проверяйте цепочку с самого начала: устройство записи, распознанный текст, выбор ответа и озвучивание. В каскадной архитектуре эти результаты доступны отдельно, поэтому не нужно менять все компоненты сразу.
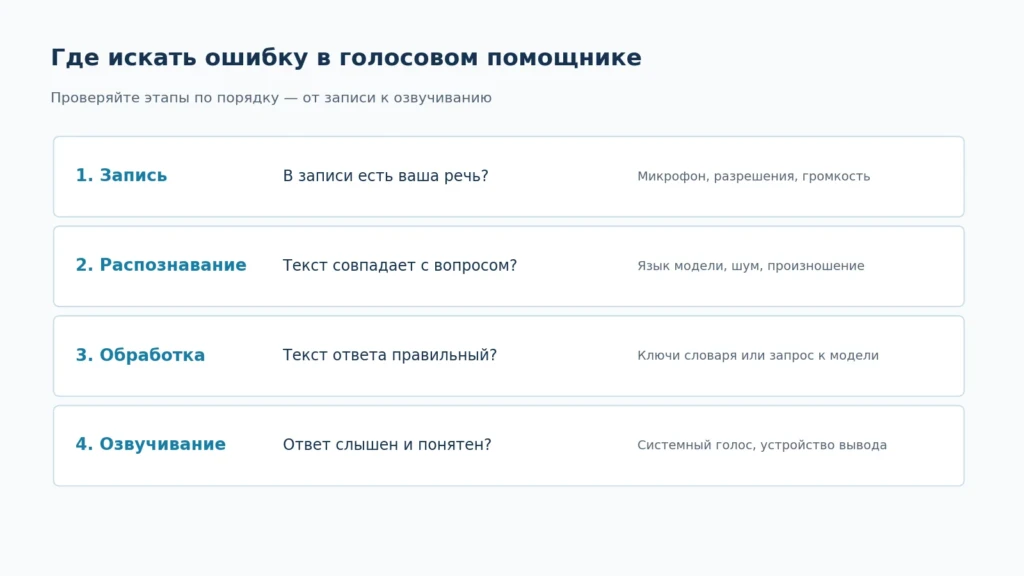
Путь к модели и параметры устройства важны для распознавания, а состав системных голосов — для озвучивания. Эти компоненты настраиваются отдельно: установка русской модели Vosk не добавляет русский голос в pyttsx3.
Перед расширением помощника проверьте три ситуации: знакомую команду, другую формулировку вопроса и неизвестный запрос. У первой версии должен быть понятен не только успешный ответ, но и отказ обработать неподдерживаемую фразу. После этого можно переходить к языковой модели и работе с документами.
FAQ
Нет. Для первой версии достаточно готового распознавания речи, обработчика команд и синтезатора голоса. Для свободного диалога можно подключить готовую языковую модель.
Учебную локальную версию можно собрать на Vosk, sounddevice и pyttsx3 без оплаты облачного API. Понадобятся компьютер с микрофоном, модель распознавания и подходящий системный голос.
Да, если все этапы выполняются локально. Пример из статьи не использует облачные сервисы; интернет нужен для первоначального скачивания библиотек и модели.
Нет. Для небольшой модели Vosk и системного синтеза речи отдельная видеокарта не требуется. Если позже вы решите запускать локальную языковую модель, требования нужно оценить отдельно.
В учебном примере ответы выбираются по точному совпадению текста после удаления пунктуации и лишних пробелов. Добавьте нужную формулировку в словарь или замените этот обработчик более гибким.