Эмбеддинг в нейросети (embedding) — это числовое представление слова, предложения, изображения или другого объекта в виде вектора. Его вычисляет модель, которая преобразует исходные данные в последовательность чисел, пригодную для дальнейшей обработки алгоритмами машинного обучения.
Представим географическую карту, на которой каждому городу соответствуют координаты. По ним можно вычислить расстояние между городами. В пространстве эмбеддингов вместо географических координат используются числовые векторы, а расстояние или угол между ними помогают оценивать сходство объектов.
Зачем нейросети представлять данные числами
Нейронная сеть выполняет вычисления над числовыми данными. Текст, изображения и звук необходимо предварительно преобразовать в математическое представление, с которым работают слои модели.
Самый простой способ закодировать слова — присвоить каждому уникальный номер. Но номер сам по себе ничего не говорит о значении слова. Например, код 125 у слова «кошка» и код 126 у слова «собака» не означают, что эти понятия семантически близки.
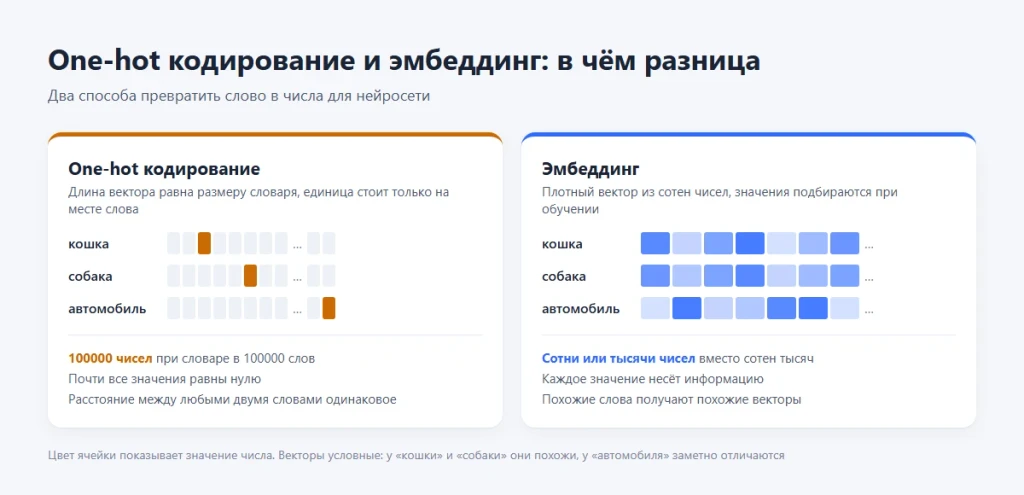
Другой вариант — one-hot кодирование. Каждому слову соответствует вектор длиной со словарь, в котором одна позиция равна единице, остальные — нулю. Если словарь содержит 100 000 слов, для каждого объекта потребуется вектор из 100 000 элементов.
У такого представления три недостатка. Во-первых, оно разреженное: почти все значения равны нулю. Во-вторых, вектор получается очень большим. В-третьих, все разные слова имеют одинаковое расстояние друг от друга, поэтому само кодирование не отражает смысловую близость.
Эмбеддинги решают эту задачу с помощью плотного представления. Вместо сотен тысяч позиций используются десятки, сотни или тысячи чисел. Веса модели обучаются так, чтобы векторы сохраняли полезные для конкретной задачи закономерности.
Как текст превращается в вектор
Конкретная реализация зависит от архитектуры модели: одни модели формируют представления отдельных токенов, другие дополнительно вычисляют единый вектор всего текста.
От токенизации к числовому представлению
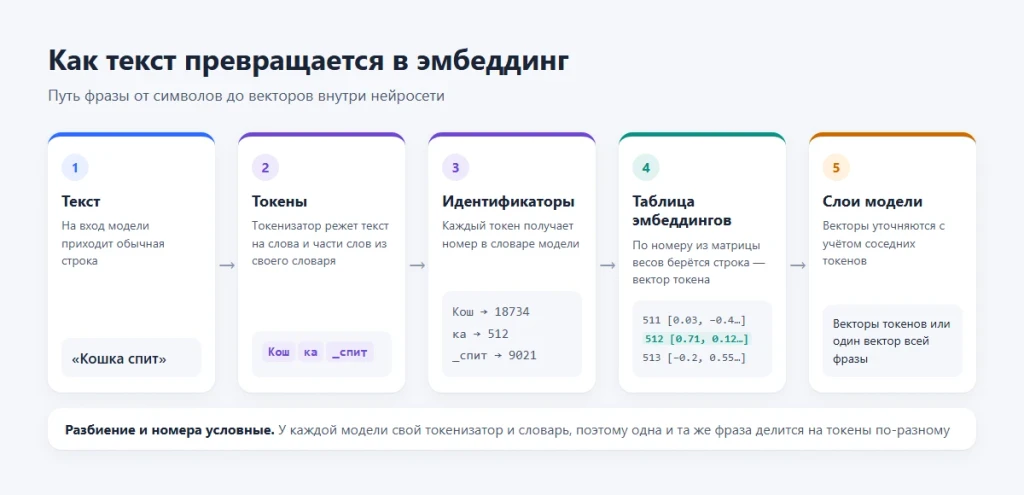
Сначала токенизатор (tokenizer) разбивает текст на токены. Токеном может быть целое слово, часть слова, знак препинания или другой элемент, предусмотренный словарём модели.
Например, фраза «Кошка спит» может быть преобразована в два токена, а редкое слово — в несколько частей. Каждый токен получает числовой идентификатор.
Далее происходит обращение к таблице эмбеддингов (embedding matrix). Это матрица обучаемых весов, в которой каждой записи словаря соответствует вектор. Для токена извлекается строка матрицы, после чего модель обрабатывает полученное представление.
В упрощённом виде процесс выглядит так:
- Текст поступает на токенизацию.
- Токены преобразуются в идентификаторы.
- По идентификаторам извлекаются векторы из таблицы эмбеддингов.
- Нейросеть обрабатывает эти представления и, если требуется, формирует единый вектор текста.
Для контекстных моделей исходные векторы токенов изменяются в ходе обработки с учётом окружающих элементов. Поэтому итоговое представление слова зависит от предложения.
Пример с короткими векторами
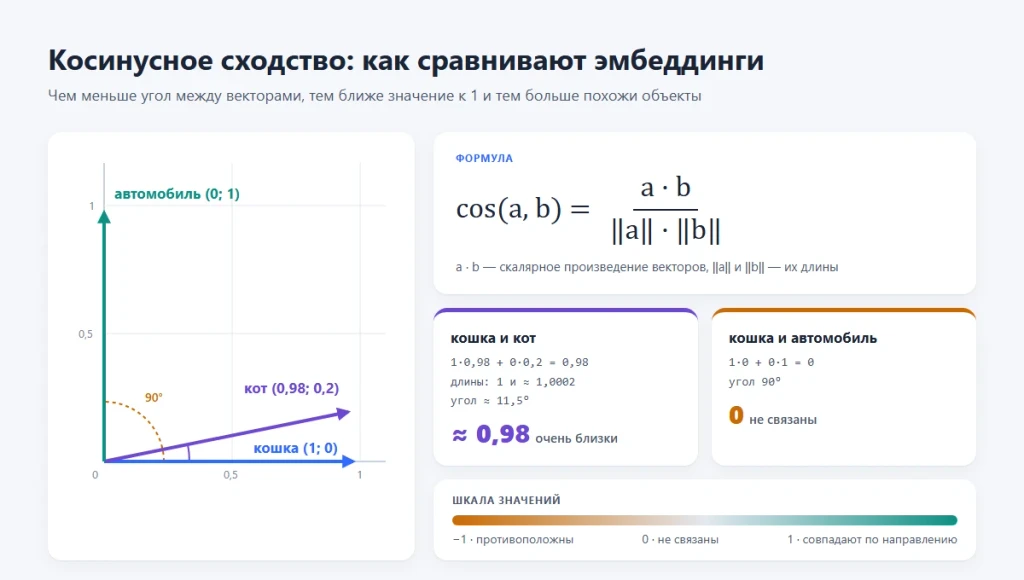
Допустим, модель присваивает словам двумерные векторы:
| Слово | Вектор |
| кошка | (1; 0) |
| кот | (0,98; 0,20) |
| автомобиль | (0; 1) |
Чтобы сравнить два вектора, можно использовать косинусное сходство.
cos(A, B) = (A · B) / (‖A‖ × ‖B‖)
Результат находится в диапазоне от −1 до 1 для ненулевых векторов. Чем ближе значение к 1, тем меньше угол между направлениями.
Для «кошки» и «кота» косинусное сходство составляет примерно 0,98. Для «кошки» и «автомобиля» оно равно 0. В рамках этой условной модели первые два слова семантически ближе.
Высокое сходство может отражать синонимию, общую тематику или типичный контекст употребления. Антонимы тоже получают близкие векторы, если часто встречаются в похожих предложениях.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Как менялись эмбеддинги и почему контекст имеет значение
Первые популярные методы построения векторных представлений слов опирались на статистику употребления. Позже появились архитектуры, способные формировать разные представления одного слова в зависимости от окружения.
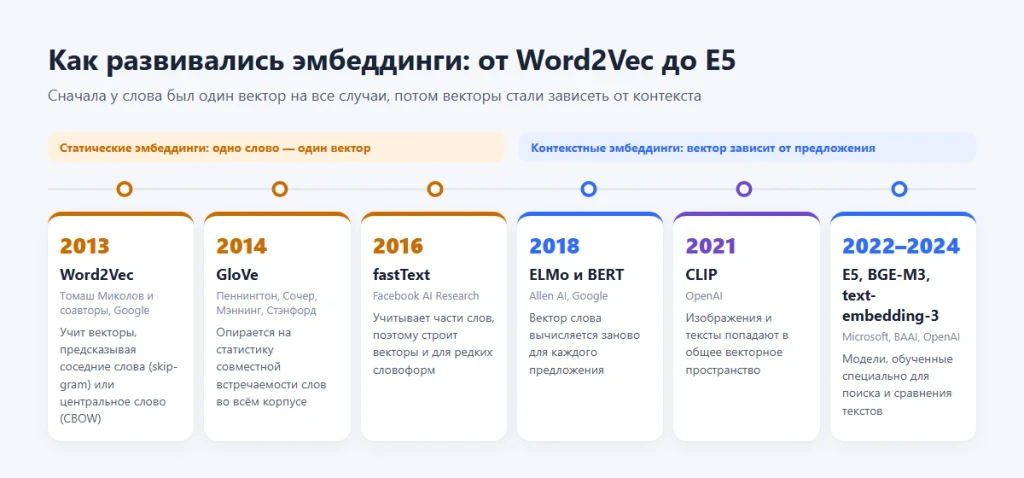
От Word2Vec до современных моделей
В 2013 году Томаш Миколов и соавторы представили Word2Vec. Метод обучает векторы слов на основе их окружения: например, модель может предсказывать соседние слова по центральному или восстанавливать центральное по контексту.
В 2014 году появился GloVe (Global Vectors for Word Representation), разработанный Джеффри Пеннингтоном, Ричардом Сочером и Кристофером Мэннингом. При обучении он использует глобальную статистику совместной встречаемости слов в корпусе.
В 2016 году исследователи Facebook AI Research представили fastText. Метод учитывает символьные n-граммы, то есть фрагменты слов, поэтому строит векторы даже для редких слов и форм, которых не было в обучающем корпусе.
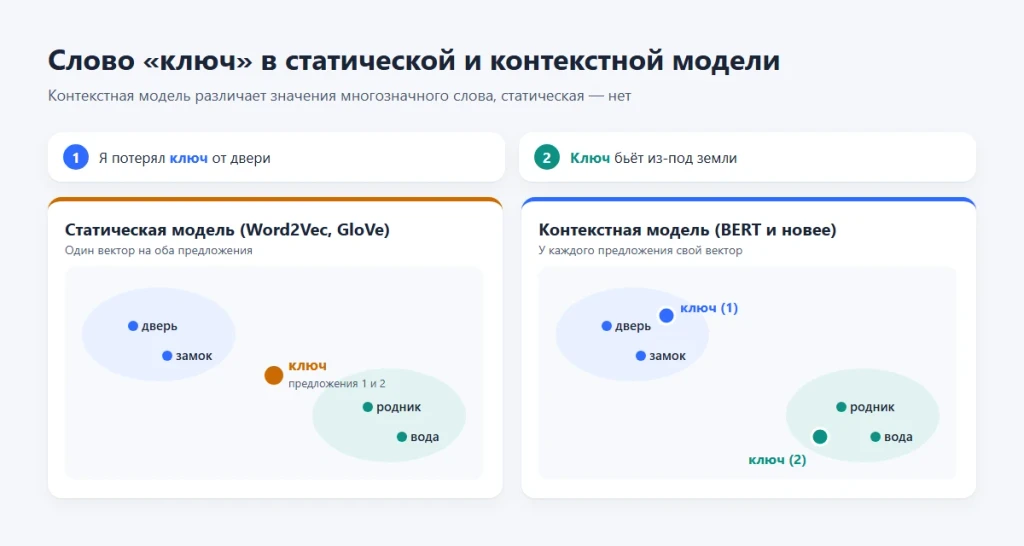
Общая особенность этих подходов — статические эмбеддинги. Одному слову соответствует один вектор независимо от конкретного предложения.
Контекстные представления
Следующий этап развития связан с контекстными моделями. В 2018 году появились ELMo и BERT: они используют контекст при вычислении представлений токенов. В BERT скрытое представление слова формируется с учётом других элементов последовательности через механизм внимания.
Возьмём слово «ключ». В предложении «Я потерял ключ от двери» оно относится к предмету для замка. В предложении «Ключ бьёт из-под земли» речь идёт об источнике воды. Статическая модель выдаст слову «ключ» один и тот же вектор в обоих предложениях, а контекстная сформирует два разных.
Для поиска это важно: по запросу «замена ключа зажигания» система не должна выдавать статьи о родниках.
Современные embedding-модели обучают под определённые задачи: поиск, сопоставление предложений, классификацию или работу с несколькими языками. Например, семейство E5 включает multilingual-варианты, предназначенные для многоязычных задач, в том числе для работы с русскоязычными данными.
Что означает размерность эмбеддинга
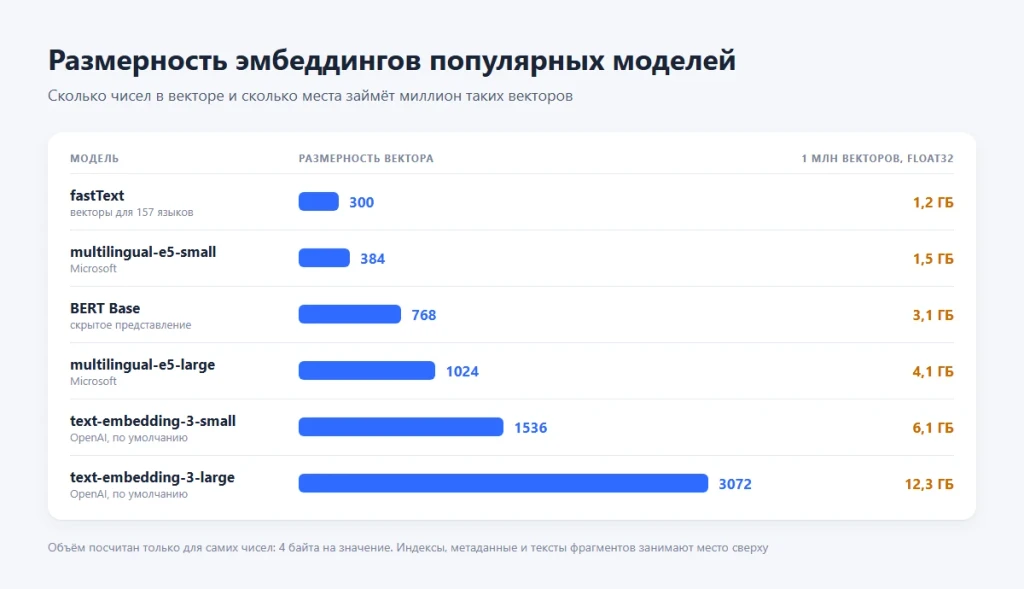
Размерность — количество чисел в векторе. Если представление имеет вид (0,15; −0,32; 0,71), его размерность равна трём.
У реальных моделей размерности существенно больше. Например:
| Модель | Размерность |
| fastText, многоязычные векторы | 300 |
| BERT Base, hidden size | 768 |
| multilingual-e5-small | 384 |
| multilingual-e5-large | 1024 |
| text-embedding-3-small | 1536 |
| text-embedding-3-large | 3072 |
Для fastText, BERT и E5 приведены характеристики соответствующих вариантов моделей, а не универсальные значения для всех их модификаций. У BERT размерность 768 относится к скрытым представлениям базовой конфигурации. У текстовых моделей OpenAI значения соответствуют длине выходного вектора по умолчанию.
Больше измерений не означает автоматически лучшее качество. Увеличение размерности может повысить выразительность представления, но одновременно увеличивает расход памяти, объём вычислений и стоимость хранения.
Кроме того, размерность сама по себе не объясняет, что означает отдельная координата. В большинстве моделей нельзя утверждать, что конкретное число отвечает исключительно за цвет, профессию или эмоциональную окраску.
При выборе модели нужно учитывать качество поиска на собственных данных, скорость вычисления, требования к памяти, языки и допустимую стоимость.
Эмбеддинги изображений, аудио и мультимодальных данных
Векторы строят и для изображений. Визуальная модель вычисляет признаки объектов, сцен и композиции.
Например, CLIP обучает совместное представление изображений и текста. Модель сопоставляет визуальные данные с текстовыми описаниями, благодаря чему можно искать картинки по запросу вроде «человек едет на велосипеде по лесу».
В мультимодальных системах изображения и текст могут проецироваться в общее пространство представлений. Это позволяет оценивать соответствие изображения описанию или находить подходящие материалы по текстовому запросу.
Аудио также можно представлять векторно. В зависимости от задачи модель извлекает признаки речи, звуковых событий, музыкального содержания или говорящего. Такие представления используют для поиска аудиофрагментов, группировки записей и распознавания речи.
Но эмбеддинги разных типов данных необязательно совместимы. Вектор из одной модели нельзя напрямую сравнивать с вектором другой, даже если совпадает размерность. Для осмысленного сравнения необходимо совместное обучение, согласованное пространство или специальный механизм преобразования.
Где используют эмбеддинги на практике
В ИИ-системах эмбеддинги нужны везде, где объекты сравнивают по смыслу.
Основные сценарии применения:
- Семантический поиск. Система находит документы по смыслу запроса, даже если в них используются другие слова.
- RAG. Перед генерацией ответа извлекаются фрагменты документов, связанные с вопросом пользователя.
- Рекомендации. Можно сопоставлять интересы пользователя с описаниями товаров, фильмов или публикаций.
- Классификация и кластеризация. Векторы используют как признаки для присвоения категорий и группировки похожих объектов.
- Поиск дубликатов. Сходство представлений помогает находить повторяющиеся или почти одинаковые материалы.
В семантическом поиске пользователь может написать «как восстановить доступ к аккаунту», а документ содержать формулировку «процедура возврата доступа к учётной записи». Если модель обучали на похожих парах запросов и документов, векторы этих фраз окажутся рядом.
Векторный поиск не гарантирует нахождение правильного ответа. Например, запросы с отрицанием, точными артикулами, датами и числовыми условиями требуют дополнительных механизмов поиска и проверки.
Как эмбеддинги работают в RAG
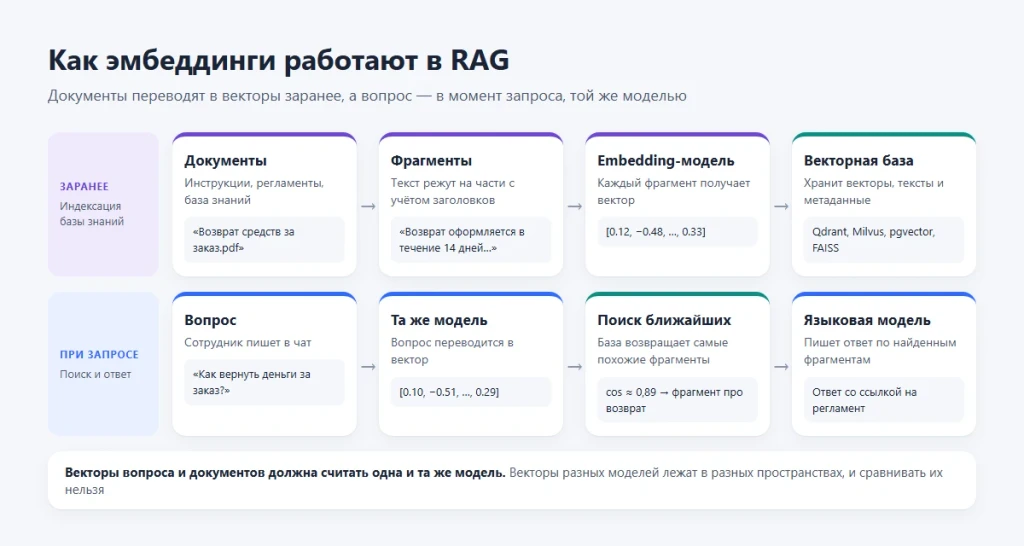
RAG (Retrieval-Augmented Generation) объединяет поиск по внешним материалам и генерацию ответа языковой моделью. Эмбеддинги здесь нужны для поиска релевантных фрагментов.
Пример для базы внутренних инструкций компании. Сотрудник спрашивает: «Как вернуть деньги за заказ?»
- Подготовка базы. Документы разбивают на фрагменты с учётом структуры, заголовков и длины. Слишком крупные части усложняют извлечение точной информации, а слишком мелкие могут потерять контекст.
- Индексация. Для каждого фрагмента вычисляют вектор с помощью embedding-модели. Вместе с ним сохраняют текст, идентификатор документа и метаданные.
- Обработка вопроса. Запрос пользователя преобразуют в вектор той же моделью, совместимой с индексом.
- Поиск. Система находит ближайшие векторы и получает соответствующие фрагменты. При необходимости используются фильтры, полнотекстовый поиск и повторное ранжирование (reranking).
- Генерация. Найденные материалы передаются языковой модели вместе с вопросом. Ответ формируется на основе доступного контекста.
Проектировать такие системы, включая векторный поиск и RAG, учат на курсе инженера генеративного ИИ.
Сильная embedding-модель не спасёт RAG, если документы плохо разбиты на фрагменты, нужной информации в базе нет или извлечение настроено неверно.
Что такое векторная база данных
Векторная база данных хранит векторные эмбеддинги объектов и ищет среди них похожие. Помимо векторов, она может хранить идентификаторы, метаданные и связанные документы.
Для ускорения поиска применяют индексы ближайших соседей (ANN, approximate nearest neighbors). Они сокращают число сравнений, но могут возвращать приближённый результат, поэтому качество индекса нужно проверять.
Для работы с эмбеддингами используют разные решения:
- FAISS — библиотека для поиска сходных векторов и работы с индексами, разработанная исследователями Meta. Это библиотека, а не СУБД. Хранение данных и API к ней дописывают отдельно.
- Qdrant — векторная база с поддержкой фильтрации по метаданным и поиска по сходству.
- Milvus — система для хранения и поиска больших коллекций векторов.
- pgvector — расширение PostgreSQL, добавляющее типы векторных данных и операции поиска.
Если данные уже хранятся в PostgreSQL, расширение pgvector может упростить инфраструктуру. Для отдельного поискового сервиса могут подойти Qdrant или Milvus, а FAISS удобен для самостоятельных поисковых компонентов и экспериментов.
Ограничения и проблемы эмбеддингов
Векторное представление зависит от обучающих данных. Если в корпусе преобладают определённые тематики, жанры или группы авторов, модель может хуже обрабатывать другие области. Смещения исходных данных переходят в результаты поиска и классификации.
Качество также различается между языками. Многоязычная модель может хорошо работать с английским, но хуже справляться с русскими падежами, профессиональными терминами или смешанными языковыми запросами.
Отдельная проблема — стоимость хранения. Один вектор размерностью 1536 при хранении значений в формате float32 занимает 6144 байта, то есть 6 КиБ без учёта служебных данных. Для миллиона таких векторов потребуется около 6,14 ГБ только под сами числа.
Если размерность равна 3072, объём удваивается. Дополнительно потребуются место под индексы, метаданные, исходные тексты и резервные копии. Квантование и сокращение размерности помогают экономить ресурсы, но способны снизить качество поиска.
Есть и методологическое ограничение: сходство векторов не равно истинности утверждений. Два противоречащих друг другу текста могут иметь высокое косинусное сходство. Для юридических, финансовых и технических данных необходимо проверять содержание найденных фрагментов.
FAQ
Это числовой вектор, который представляет слово в пространстве признаков модели. В статических моделях одному слову соответствует одно представление, а контекстные модели могут вычислять разные векторы в зависимости от предложения.
Да, это корректное упрощённое объяснение. Точнее, речь идёт о преобразовании объекта в числовой вектор, который кодирует признаки, полезные для определённых задач.
Токен — единица текста, которой соответствует идентификатор в словаре модели. Эмбеддинг — числовое представление токена или более крупного фрагмента текста, обычно в виде плотного вектора.
Обычно используют косинусное сходство, скалярное произведение или евклидово расстояние. Выбор зависит от модели, нормализации векторов и настроек поиска.
Да, существуют русскоязычные и многоязычные модели, в том числе fastText и multilingual E5.