KeyError — распространенная ошибка в Python, которая возникает при обращении к несуществующему ключу словаря или другого объекта, работающего по принципу сопоставления ключей и значений. Интерпретатор не может найти запрошенный элемент и прерывает выполнение программы, если исключение не обработано.
Чаще всего проблема связана с неправильным названием ключа, отсутствующим значением, лишними пробелами или изменением структуры данных. При работе с библиотекой pandas аналогичная ошибка появляется, когда программа обращается к столбцу DataFrame или метке индекса, которой нет в таблице.
Чтобы исправить KeyError, нужно определить, какой именно ключ отсутствует, проверить фактическую структуру данных и выбрать подходящий способ обращения к элементу. В одних случаях достаточно исправить название, в других — использовать метод get(), проверить наличие ключа через in или обработать исключение.
Что означает ошибка KeyError в Python
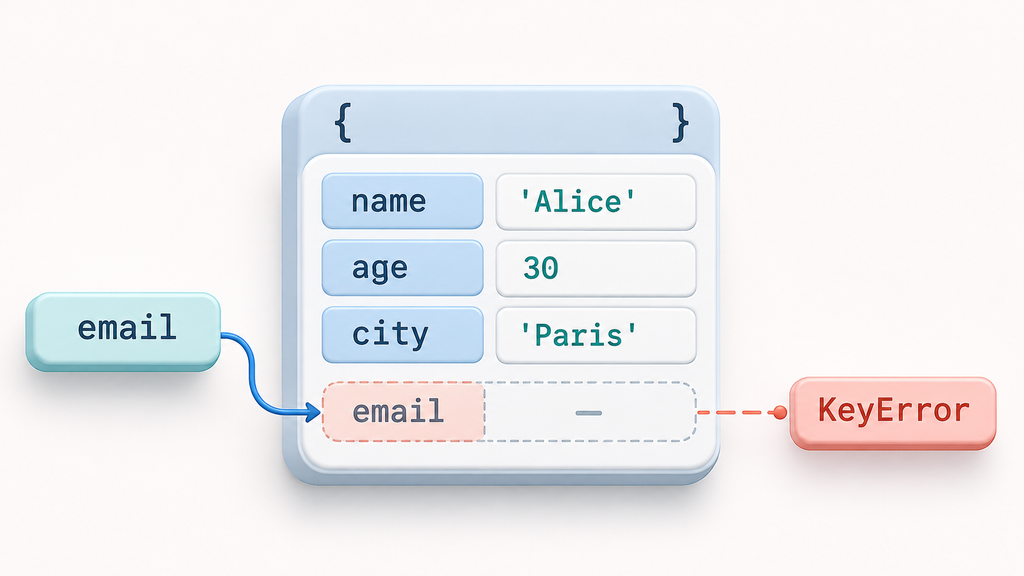
KeyError (ошибка ключа) — встроенное исключение Python, которое возникает при попытке получить значение по ключу, отсутствующему в отображении (mapping). Самый распространенный пример — обращение к элементу словаря через квадратные скобки.
Рассмотрим простой код:
user = {
    "name": "Алексей",
    "age": 25,
    "city": "Москва"
}

print(user["email"])
В словаре user нет ключа email. Поэтому Python не может вернуть соответствующее значение и сообщает об ошибке:
KeyError: 'email'Это не синтаксическая ошибка и не проблема установки Python. Интерпретатор успешно выполняет код до момента обращения к отсутствующему элементу.
Исключение KeyError относится к классу LookupError, который также является родительским для IndexError. Однако эти ошибки обозначают разные ситуации:
- KeyError — программа не нашла указанный ключ в отображении;
- IndexError — программа обратилась к несуществующей позиции последовательности, например к элементу списка за пределами его длины.
Почему возникает KeyError: основные причины
Python сообщает о том, что нужного ключа нет, но не определяет, почему он отсутствует. Это зависит от того, как сформированы данные и каким образом программа обращается к ним.
1. Неправильное название ключа
Самая частая причина — опечатка или несовпадение названий.
product = {
    "title": "Ноутбук",
    "price": 75000
}

print(product["prise"])
Вместо price программист указал prise. Для Python это два разных ключа, поэтому возникает KeyError.
Исправленный вариант:
print(product["price"])2. Различия в регистре символов
Ключи в словарях Python чувствительны к регистру. Значения name, Name и NAME считаются разными.
data = {"Name": "Анна"}

print(data["name"])
Чтобы устранить ошибку, нужно использовать точное название ключа:
print(data["Name"])3. Лишние пробелы и невидимые символы
При загрузке информации из CSV, JSON и других источников названия полей могут содержать пробелы, табуляцию или другие символы.
Например, в словаре может находиться ключ «email «, а программа обращается к «email».
Проверить фактические названия можно так:
data = {"email ": "user@example.com"}

print(list(data.keys()))
Если проблема связана с пробелами, их можно удалить:
data = {
    key.strip(): value
    for key, value in data.items()
}
4. Отсутствующее значение во входных данных
Программа может рассчитывать на наличие определенного поля, но фактически получать неполный объект. Такое случается при обработке API-ответов, пользовательских форм и записей из базы данных.
Например, один объект содержит phone, а другой — только name. Если программа обращается к user[«phone»] без проверки, во втором случае появится исключение.
5. Изменение структуры словаря
Ошибка возникает и тогда, когда ключ удалили или заменили в процессе выполнения программы.
settings = {
    "theme": "dark",
    "language": "ru"
}

del settings["theme"]

print(settings["theme"])
После удаления элемента обращение к нему невозможно. Нужно проверить, где именно изменяется структура данных и не используется ли ключ после удаления.
Курс «Python Ninja» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Как исправить ошибку KeyError в Python
1. Проверить существующие ключи словаря
Для начала выведите все ключи с помощью метода keys():
user = {
    "name": "Алексей",
    "age": 25,
    "city": "Москва"
}

print(user.keys())
Результат:
dict_keys(['name', 'age', 'city'])Так можно увидеть реальные названия полей и сравнить их с теми, которые используются в программе.
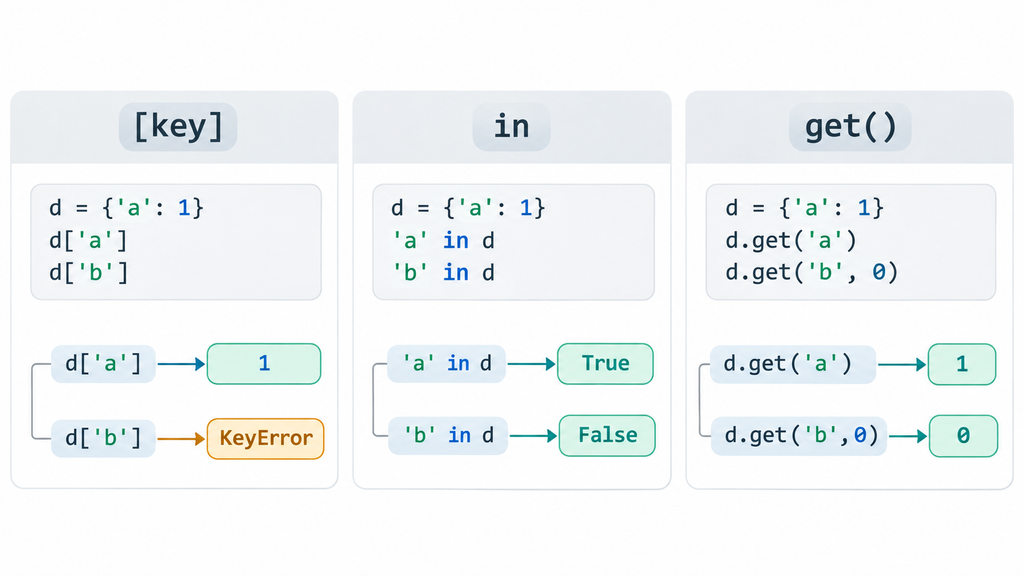
Для проверки конкретного элемента применяется оператор in:
if "email" in user:
    print(user["email"])
else:
    print("Ключ email отсутствует")
Этот способ подходит, когда программа должна выполнять разные действия в зависимости от наличия данных.
2. Использовать метод get()
Метод get() позволяет получить значение без возникновения KeyError, если запрашиваемого ключа нет. Вместо исключения Python возвращает None или указанное значение по умолчанию.
user = {
    "name": "Алексей",
    "age": 25
}

email = user.get("email")

print(email)
Результат:
NoneМожно указать значение, которое будет использоваться при отсутствии ключа:
email = user.get("email", "Не указан")print(email)В этом случае программа выведет Не указан.
Метод get() полезен при обработке JSON-ответов, настроек и необязательных полей. Например, если API не всегда возвращает номер телефона, программа продолжит работу без ошибки.
Учитывайте, что get() не отличает отсутствующий ключ от существующего ключа со значением None. Если это различие имеет значение, лучше использовать проверку через in.
3. Применить setdefault()
Метод setdefault() возвращает значение и добавляет отсутствующий ключ в словарь с заданным значением.
settings = {
    "language": "ru"
}

theme = settings.setdefault("theme", "light")

print(theme)
print(settings)
Результат:
light
{'language': 'ru', 'theme': 'light'}
Если ключ уже существует, его значение останется прежним. Если элемента нет, Python создаст новую запись.
4. Обработать исключение через try-except
Если отсутствие ключа является ожидаемой ситуацией, можно использовать конструкцию try-except. Она позволяет определить действия, которые программа выполнит при возникновении ошибки.
user = {
    "name": "Алексей",
    "age": 25
}

try:
    print(user["email"])
except KeyError as error:
    print(f"Отсутствует ключ: {error}")
Программа перехватит исключение и выведет сообщение вместо остановки выполнения.
При этом важно указывать именно KeyError, а не перехватывать все исключения через общий except Exception. Широкая обработка может скрыть другие неисправности, не связанные с отсутствующим ключом.
Если значение обязательно для дальнейшей работы, лучше не подменять его произвольными данными. В таком случае программа должна сообщить о нарушении структуры входного объекта и остановить соответствующую операцию.
Ошибка KeyError в pandas: почему возникает и как исправить
Библиотека pandas используется для обработки таблиц, анализа данных и работы с файлами CSV и Excel. В ней исключение KeyError часто возникает при обращении к столбцу DataFrame, которого нет в таблице.
Например:
import pandas as pd

df = pd.DataFrame({
    "name": ["Анна", "Иван"],
    "age": [24, 30]
})

print(df["email"])
В таблице есть столбцы name и age, но отсутствует email. Поэтому pandas возвращает:
KeyError: 'email'Проверить названия столбцов DataFrame
Первое, что нужно сделать, — вывести список столбцов:
print(df.columns.tolist())Если названия отличаются от ожидаемых, исправьте обращение к ним. Например, вместо df[«Name»] может потребоваться df[«name»].
Для проверки наличия столбца можно использовать оператор in:
if "email" in df.columns:
    print(df["email"])
else:
    print("Столбец email отсутствует")
Удалить лишние пробелы в названиях столбцов
При чтении CSV-файлов названия полей иногда содержат пробелы. В результате обращение к столбцу по привычному имени вызывает ошибку.
Например, в файле заголовок может выглядеть как email, а в коде используется email.
Чтобы исправить ситуацию, можно очистить все названия:
df.columns = df.columns.str.strip()После этого pandas удалит пробелы в начале и конце названий столбцов.
Если лишние пробелы присутствуют непосредственно в CSV-файле, при загрузке можно использовать параметр skipinitialspace:
df = pd.read_csv("data.csv", skipinitialspace=True)Он позволяет пропускать пробелы после разделителя полей.
Проверить обращение через loc и iloc
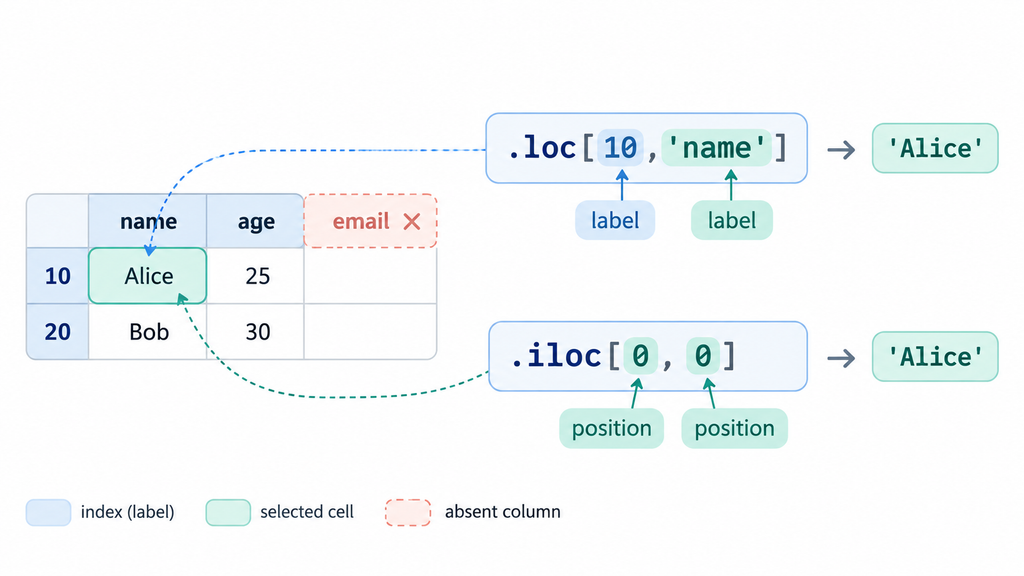
В pandas есть два основных способа выбора строк и столбцов:
- .loc — обращение по меткам индекса и названиям столбцов;
- .iloc — выбор по числовым позициям.
Например:
import pandas as pd

df = pd.DataFrame({
    "name": ["Анна", "Иван"],
    "age": [24, 30]
}, index=[10, 20])

print(df.loc[10, "name"])
print(df.iloc[0, 0])
Оба выражения вернут Анна, но используют разные способы адресации.
Распространенная ошибка — применять .loc так, будто он выбирает строку по порядковому номеру:
df.loc[0]В нашем примере индекс содержит метки 10 и 20, поэтому метки 0 нет. Возникнет KeyError.
Правильный вариант:
df.iloc[0]Он вернет первую строку независимо от значения ее индекса.
Если же требуется выбрать строку именно по метке, нужно использовать .loc и передавать существующее значение индекса.
pandas 3.1.1 documentation+1
Проверить индекс и названия после загрузки данных
Иногда проблема возникает не из-за названия столбца, а из-за меток строк. Это особенно актуально после фильтрации, объединения таблиц и удаления записей.
Посмотреть текущий индекс можно командой:
print(df.index.tolist())Если требуется проверить наличие определенной метки:
if 10 in df.index:
    print(df.loc[10])
else:
    print("Запись с индексом 10 не найдена")
Если нужно заново пронумеровать строки после фильтрации, можно использовать reset_index():
df = df.reset_index(drop=True)Метод создаст новый последовательный индекс, начиная с нуля. Старый индекс будет отброшен благодаря параметру drop=True.
Безопасно получить столбец через get()
У DataFrame также есть метод get(). Он позволяет обратиться к столбцу и задать значение по умолчанию, если такого поля нет.
email = df.get("email")print(email)Если столбец отсутствует, метод вернет None, а не вызовет KeyError.
Можно передать альтернативное значение:
email = df.get("email", "Нет данных")Этот способ удобен для необязательных столбцов, но не заменяет проверку структуры таблицы, если конкретное поле обязательно для расчетов.
pandas 3.1.1 documentation+1
Как найти причину KeyError: диагностика ошибки
Если исправление очевидной опечатки не помогло, нужно изучить сообщение об ошибке и проследить путь выполнения программы.
При диагностике полезно выполнить несколько действий:
- Посмотреть traceback. В трассировке Python указывает строку, на которой возникло исключение. Начинать проверку следует с нее, а затем изучить вызовы функций, которые привели к проблемному обращению.
- Вывести запрашиваемый ключ. Иногда название формируется динамически из переменной, поэтому ошибка может зависеть от входных данных.
- Посмотреть доступные ключи. Для словаря подойдет dict.keys(), для DataFrame — df.columns, для Series — series.index.
- Проверить тип данных. Убедитесь, что программа действительно работает со словарем, таблицей или другим ожидаемым объектом.
- Проверить изменения структуры. Найдите места, где элементы добавляются, переименовываются или удаляются.
Для получения дополнительной информации об исключении можно обратиться к атрибуту args:
try:
    print({"name": "Анна"}["email"])
except KeyError as error:
    print("Тип:", type(error).__name__)
    print("Отсутствующий ключ:", error.args[0])
Такой подход полезен при отладке больших программ, где один и тот же фрагмент кода обрабатывает множество разных объектов.
Частые ошибки при исправлении KeyError
Попытка быстро устранить исключение не всегда решает исходную проблему. Некоторые приемы позволяют продолжить выполнение программы, но приводят к неправильным результатам.
Использование get() для обязательных полей. Если программа рассчитывает стоимость заказа, но не получает цену товара, подстановка нуля может исказить итоговые данные. Для обязательных значений лучше проверять наличие ключа и сообщать о некорректном объекте.
Удаление исключения без анализа причины. Конструкция except KeyError: pass скрывает проблему. Программа продолжает работу, хотя необходимые данные могут отсутствовать.
Автоматическое добавление всех недостающих ключей. Метод setdefault() полезен не во всех ситуациях. Если отсутствующий элемент свидетельствует об ошибке загрузки или нарушении структуры данных, его автоматическое создание только затруднит диагностику.
Путаница между индексом и позицией. В pandas .loc работает с метками, а .iloc — с числовыми позициями. Замена одного метода другим без проверки логики выборки может привести к обработке не той строки.
Как предотвратить появление ошибки KeyError
Полностью исключить такие ситуации невозможно, особенно если программа получает данные из внешних источников. Однако можно сделать код устойчивее к изменениям входной информации.
Рекомендуется придерживаться нескольких правил:
- Проверять структуру JSON и других входных объектов перед обработкой.
- Использовать единые названия ключей во всех частях программы.
- Удалять лишние пробелы из названий полей при загрузке таблиц.
- Разделять обязательные и необязательные значения.
- Проверять наличие столбцов перед выполнением операций в pandas.
- Добавлять обработку ожидаемых исключений в местах, где отсутствие ключа допустимо.
- Использовать тесты для проверки неполных и некорректных входных данных.
В крупных проектах полезно описывать ожидаемую структуру объектов с помощью типизации и инструментов валидации. Например, TypedDict позволяет задать ожидаемые ключи словаря, а библиотеки Pydantic и Marshmallow помогают проверять входные данные по заданной схеме. При этом сама по себе аннотация типов не гарантирует, что во время выполнения все необходимые ключи действительно присутствуют.
Заключение
KeyError — базовая проблема, с которой сталкиваются начинающие разработчики при изучении словарей, структур данных и обработки таблиц. Для уверенной работы с Python важно понимать принципы обработки исключений, устройство коллекций, работу с файлами и сторонними библиотеками.
На курсе Python в DMS-IT можно изучить основы языка и закрепить навыки программирования на практике. Это подходящий вариант для тех, кто хочет системно разобраться в работе с переменными, функциями, структурами данных и другими инструментами Python.
FAQ
KeyError возникает при обращении к отсутствующему ключу. TypeError сообщает о недопустимой операции или несовместимых типах данных. AttributeError появляется, когда у объекта нет запрашиваемого атрибута или метода.
Да. После преобразования JSON в словарь Python обращение к отсутствующему полю через квадратные скобки вызывает KeyError. Если структура ответа заранее неизвестна, лучше проверять наличие обязательных полей или использовать get().
В тестах можно использовать pytest.raises(KeyError), чтобы проверить, что обращение к отсутствующему ключу действительно вызывает ожидаемое исключение.
Сначала проверьте заголовки после загрузки через df.columns.tolist(). Причиной могут быть лишние пробелы, неправильный разделитель, кодировка или отличающиеся названия полей. Для удаления пробелов используйте df.columns = df.columns.str.strip().