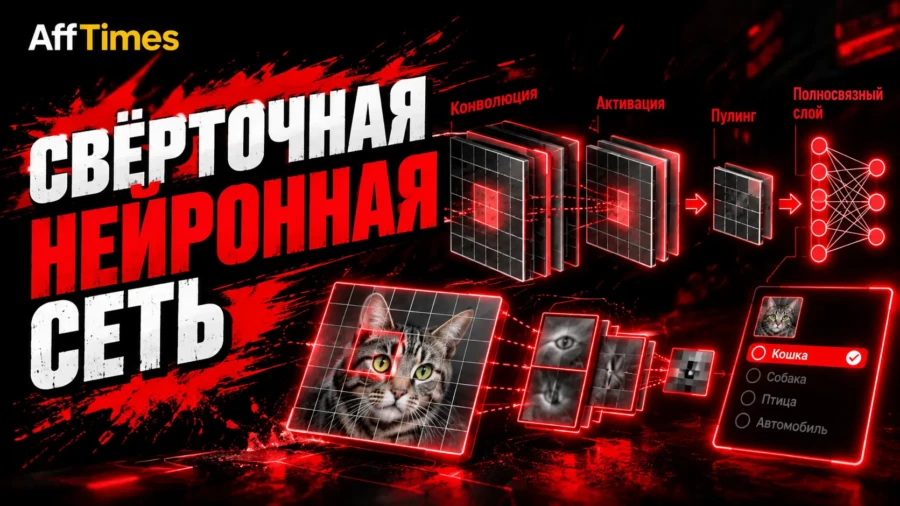
Сверточная нейронная сеть (Convolutional Neural Network, CNN, произносится «си-эн-эн») — модель, которая обрабатывает изображения с учетом того, что соседние пиксели связаны между собой. По-английски ее также называют ConvNet. Если объяснять, что такое сверточная сеть простыми словами, это последовательность операций, которая вычисляет локальные признаки изображения, объединяет их и использует результат для классификации, детекции или другой задачи.
Зачем изображениям нужна особая архитектура
Полносвязная сеть (multilayer perceptron, MLP) получает плоский вектор, где каждый вход связан с каждым нейроном следующего слоя. У изображения такой способ представления быстро становится дорогим: цветная картинка размером 1000 × 1000 содержит 3 миллиона значений. Один полносвязный слой всего с 1000 выходами потребовал бы 3 миллиарда весов, не считая смещений.
Кроме затрат памяти и вычислений, MLP не учитывает близость пикселей. В сверточной сети небольшие фильтры применяются к множеству участков одним и тем же набором весов. Такая повторно используемая матрица параметров помогает находить локальную структуру в разных частях кадра и существенно сокращает число обучаемых весов.
Из каких слоев состоит архитектура CNN
Свертка и карта признаков
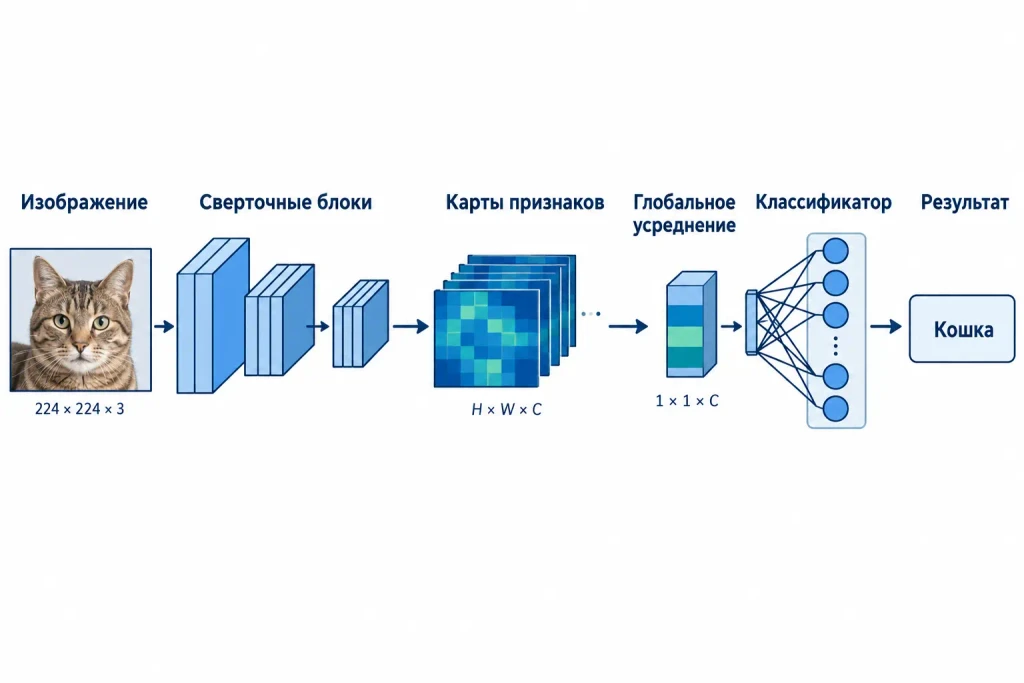
Сверточный слой (convolutional layer, в PyTorch Conv2d) применяет ядро (kernel, filter) ко входному тензору. Ядро перемещается по ширине и высоте, а в каждой позиции перемножает свои веса с соответствующим окном входа и суммирует результаты. Для цветного изображения окно охватывает все входные каналы. У каждого выходного фильтра есть свои веса и обычно смещение. На практике свертка в популярных библиотеках обычно вычисляется как корреляция, то есть веса ядра не переворачиваются.
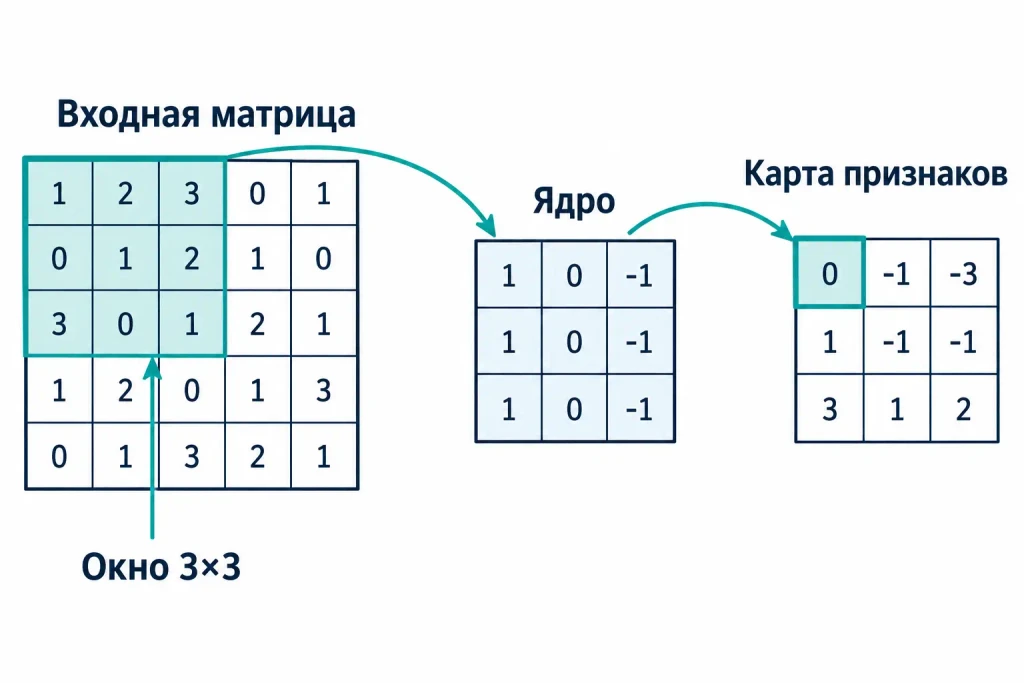
Каждый фильтр создает отдельный канал карты признаков (feature map). Число выходных каналов задается количеством фильтров. Веса ядра общие для всех пространственных позиций: фильтр, примененный к левому краю изображения, использует те же параметры, что и в центре.
Активация, пулинг и классификатор
После свертки часто применяется ReLU: ReLU(x) = max(0, x). Она обнуляет отрицательные значения и добавляет нелинейность, благодаря которой последовательность слоев может описывать более сложные функции. ReLU не меняет размерность тензора.
Слой подвыборки (pooling layer) уменьшает ширину и высоту карт признаков. MaxPooling берет максимум в каждом окне, AveragePooling — среднее. Снижение пространственного разрешения сокращает вычисления и делает отклик менее чувствительным к небольшому сдвигу признака. Однако пулинг сам по себе не обеспечивает полной трансляционной инвариантности, особенно при крупных сдвигах.
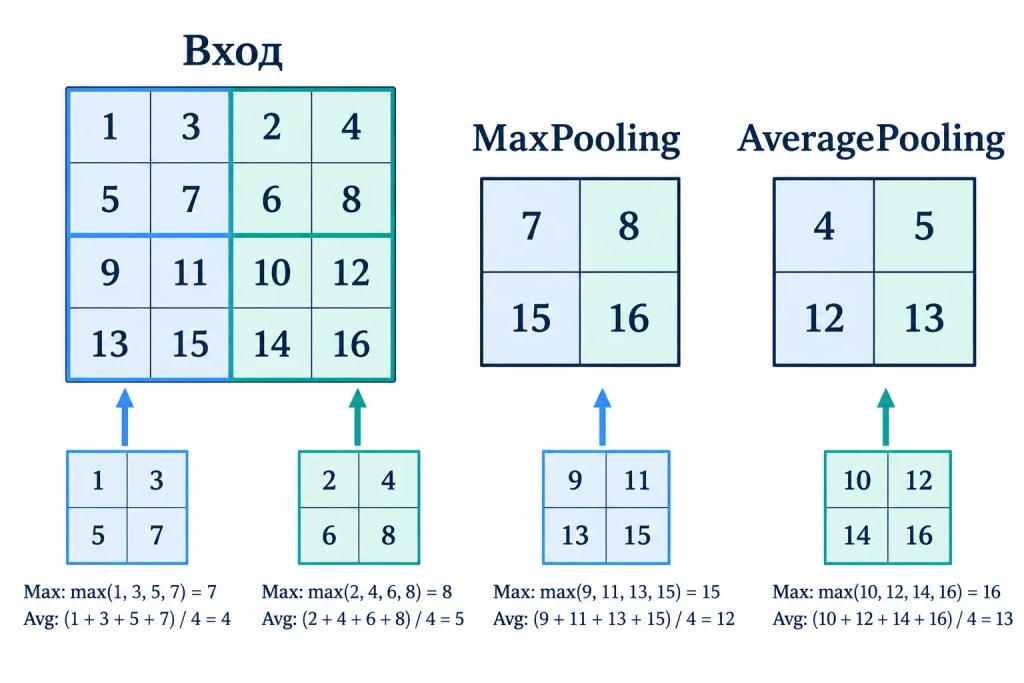
Во многих современных моделях часть операций пулинга заменяют свертками с шагом больше единицы (strided convolutions), те одновременно уменьшают разрешение и обучают параметры преобразования. Для классификации в конце часто используют глобальное усреднение по пространственным координатам, затем полносвязный слой (fully connected, Linear), который выдает оценки классов.
| Слой | Основные параметры | Обучаемые параметры |
| Conv2d | in_channels, out_channels, kernel_size, stride, padding | out_channels × (in_channels × kH × kW + 1), если включено смещение |
| MaxPool2d | kernel_size, stride, padding | Нет |
| Linear | in_features, out_features | in_features × out_features + out_features, если включено смещение |
В первой строке таблицы kH и kW — высота и ширина ядра. Например, свертка из 3 входных каналов в 16 выходных с ядрами 3 × 3 и смещениями имеет 16 × (3 × 3 × 3 + 1) = 448 параметров. У пулинга параметры окна фиксированы, поэтому он не учится по данным.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Как рассчитать размер карты признаков
Размерность тензора обычно записывают как N × C × H × W в PyTorch: размер пакета, каналы, высота и ширина. В TensorFlow распространен формат N × H × W × C. Для одного пространственного измерения формула выхода свертки или пулинга такова:
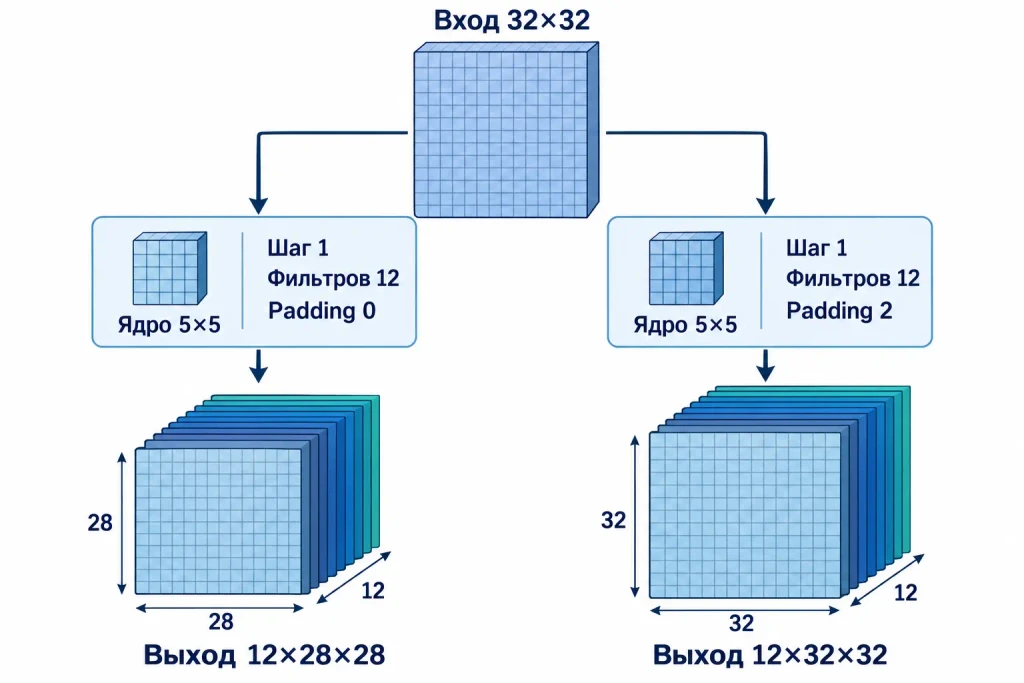
H_out = floor((H_in + 2P - D × (K - 1) - 1) / S + 1)
Здесь H_in — входной размер, K — размер ядра, S — шаг (stride), P — симметричный отступ (padding), D — дилатация (dilation). Для обычной свертки D = 1. Если параметры одинаковы по обеим осям, формула применяется и к ширине, и к высоте.
Практический пример: вход имеет размер 32 × 32, ядро — 5 × 5, шаг равен 1, отступ равен 0. Тогда H_out = floor((32 − 5) / 1 + 1) = 28, и ширина также будет 28. Если сверточный слой имеет 12 фильтров, выходной тензор одного изображения будет иметь размер 12 × 28 × 28. При padding=2 размер сохранился бы равным 32 × 32.
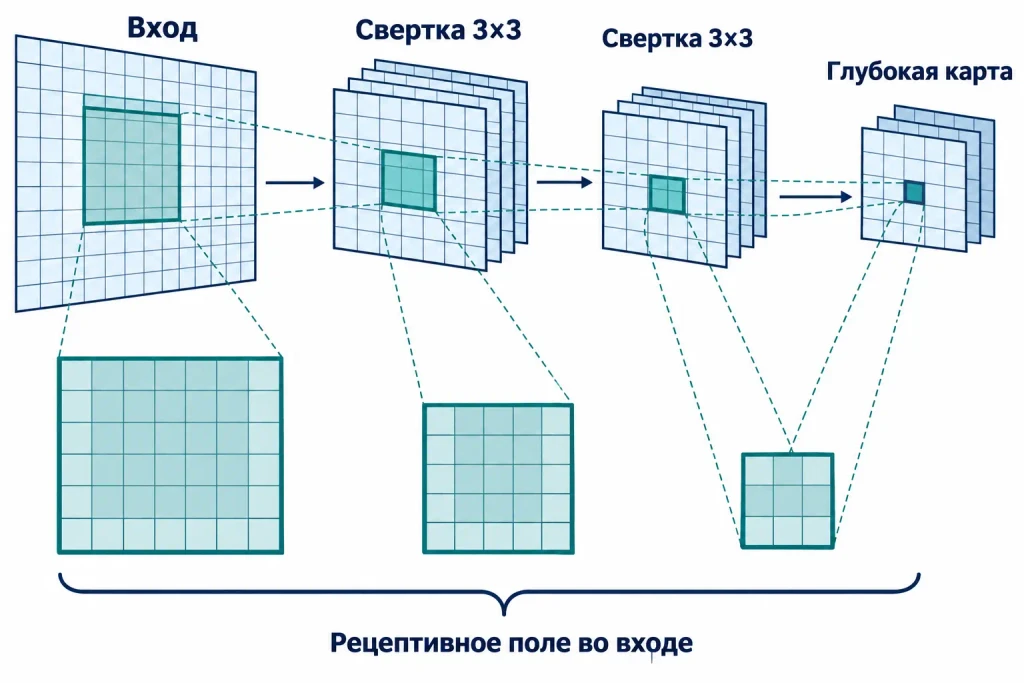
Рецептивное поле (receptive field) — участок исходного изображения, который влияет на конкретную позицию карты признаков. По мере прохождения через слои оно растет: последующие признаки зависят от все более широких областей входа. Рост зависит от размера ядер, шагов и дилатации. Он не равен просто числу слоев.
Как менялись классические архитектуры
Эволюция CNN связана с изменением вычислительных возможностей и приемов построения глубоких моделей. В таблице ориентировочные числа параметров для распространенных вариантов.
| Архитектура | Параметры, примерно | Основная идея |
| LeNet-5 | 60 тыс. | Раннее сочетание сверток, подвыборки и классификатора для распознавания рукописных цифр |
| AlexNet | 61 млн | Глубокая CNN для ImageNet; ReLU и обучение на GPU помогли масштабировать эксперимент |
| VGG-16 | 138 млн | Последовательное применение небольших ядер 3 × 3 |
| ResNet-50 | 25,6 млн | Остаточные связи облегчают обучение глубоких сетей |
| MobileNetV1 | 4,2 млн | Разделение пространственной и канальной сверток для мобильного инференса |
LeNet-5 показала базовую схему сверток и подвыборки для изображений. AlexNet в работе 2012 года использовала ReLU и GPU для обучения на крупном наборе ImageNet. В VGG-16 несколько слоев с ядрами 3 × 3 обеспечивают нелинейные преобразования между операциями и позволяют наращивать глубину с относительно небольшими ядрами. Цена такого решения — крупное число параметров, особенно в классификаторе.
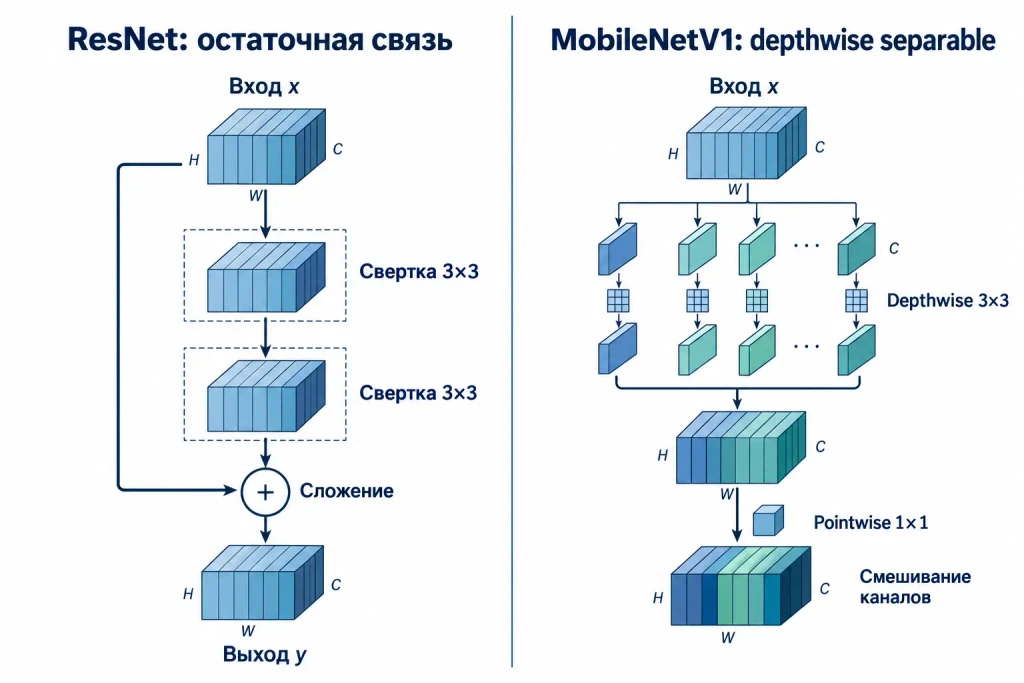
В ResNet блоки передают вход дальше по skip connection, складывая его с результатом преобразований. Это дает градиенту более прямой путь через сеть и помогает обучать глубокие архитектуры. ResNet-50 содержит около 25,6 млн параметров в распространенной конфигурации для ImageNet.
В MobileNetV1 обычная свертка заменяется depthwise separable convolution: depthwise-свертка отдельно обрабатывает пространственную структуру каждого канала, а pointwise-свертка 1 × 1 смешивает каналы. Это снижает число операций и параметров. На практике свертки 1 × 1 также используют в bottleneck-блоках, чтобы временно уменьшить число каналов перед дорогой пространственной операцией.
Как обучают CNN и готовят к запуску
При обучении ИИ-инженером модель получает изображения и целевые метки. Прямой проход рассчитывает предсказание, функция потерь сравнивает его с меткой, а обратное распространение ошибки вычисляет градиенты по весам. Оптимизатор обновляет параметры в направлении, которое уменьшает потери. Цикл повторяется по пакетам данных и эпохам. Качество проверяют на отложенной выборке.
Для борьбы с переобучением применяют несколько приемов:
- Аугментация данных (data augmentation): случайные отражения, обрезки, изменения яркости и масштаба расширяют разнообразие обучающих примеров.
- Dropout во время обучения случайно отключает часть активаций, снижая зависимость от отдельных путей в сети.
- Batch Normalization нормализует промежуточные активации по мини-пакету и имеет обучаемые масштаб и сдвиг. На практике она часто делает обучение стабильнее, но ускорение сходимости зависит от модели, размера пакета и режима обучения.
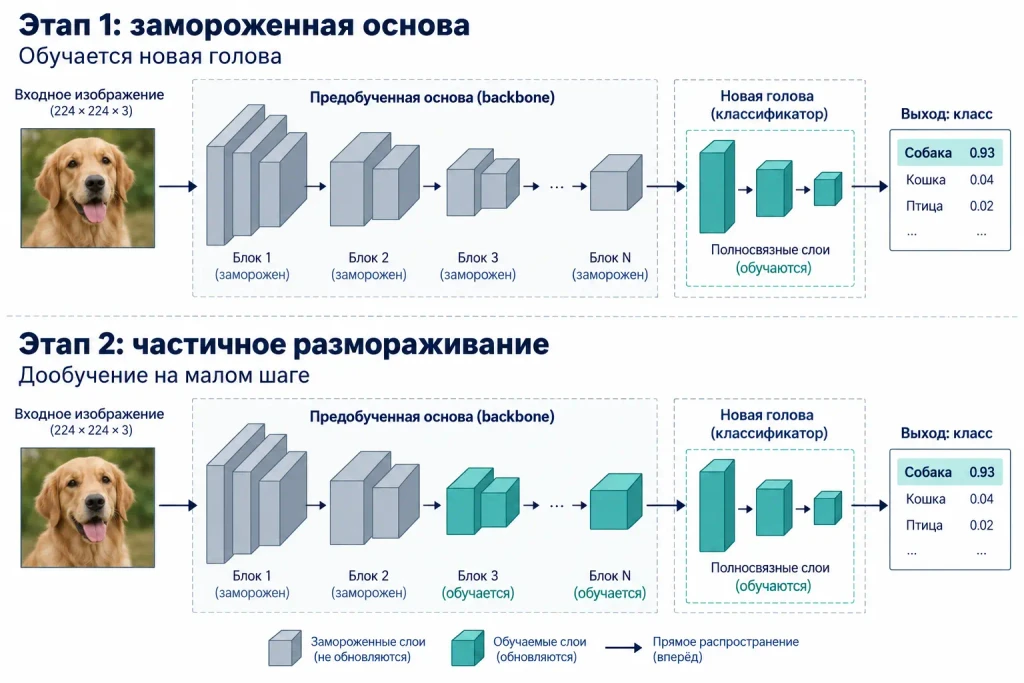
С нуля CNN обучают, когда доступны большие размеченные данные или задача заметно отличается от исходной. В остальных случаях часто применяют transfer learning (перенос обучения): берут веса модели, предварительно обученной на ImageNet, заменяют классификационную голову и дообучают. На первом этапе можно заморозить сверточные слои, чтобы обновлялись только новые параметры, затем разморозить часть слоев и выполнить тонкую настройку на меньшем шаге обучения. Если новый домен сильно отличается от ImageNet, полная заморозка может ограничить качество.
Ограничения сверточных сетей и новые направления
Локальность свертки задает полезный априорный принцип, но глобальные отношения между удаленными частями изображения требуют глубокой обработки или дополнительных механизмов. CNN чувствительны к изменениям масштаба, ракурса и распределения данных, если обучение не охватило такие случаи. Capsule Networks предлагали явно представлять тип признака и его позу, однако не стали стандартной заменой сверточным архитектурам.
Vision Transformers (ViT) применяют механизм внимания к последовательности фрагментов изображения. Они стали важной альтернативой CNN в задачах компьютерного зрения, особенно при наличии достаточных данных и вычислений. На практике сравнивают конкретные модели и условия: задержку, память, точность и целевое устройство.
FAQ
Нет. Одномерные свертки используют для аудио, временных рядов и последовательностей, а трехмерные — например, для видео. Выбор зависит от локальной структуры данных и нужного рецептивного поля.
Такое ядро позволяет обрабатывать локальные области с умеренным числом весов. Несколько слоев 3 × 3 добавляют нелинейные преобразования между операциями и увеличивают рецептивное поле. Ядра 5 × 5 и 7 × 7 тоже применяют, когда это оправдано архитектурой или разрешением входа.
valid означает отсутствие дополнения нулями, поэтому пространственный размер обычно уменьшается. same добавляет padding так, чтобы при шаге 1 выход сохранял размер входа; при больших шагах размер может уменьшиться. В конкретном API следует проверять правила округления и раскладки.
Сеть может сохранять больше пространственной информации, но промежуточные карты останутся крупнее, а вычислительная стоимость вырастет. Уменьшение разрешения можно выполнять свертками со stride, а классификационные архитектуры часто заканчиваются глобальным усреднением.
Часто да, если архитектура содержит только свертки и операции с допустимыми размерами. Полносвязный слой с фиксированным числом входов может потребовать конкретного разрешения или адаптивного пулинга перед ним.
Это гиперпараметр: его выбирают по валидационному качеству, задержке и памяти. Увеличение каналов дает слою больше обучаемых фильтров, но увеличивает вычислительную стоимость и риск переобучения при ограниченном наборе данных.