Градиентный спуск — один из алгоритмов, благодаря которым нейросети учатся на своих ошибках. Он помогает модели постепенно улучшать предсказания: точнее распознавать изображения, анализировать данные и решать другие задачи. Разберём, как работает градиентный спуск, почему важна скорость обучения и как попробовать алгоритм на Python.
Что такое градиентный спуск простыми словами
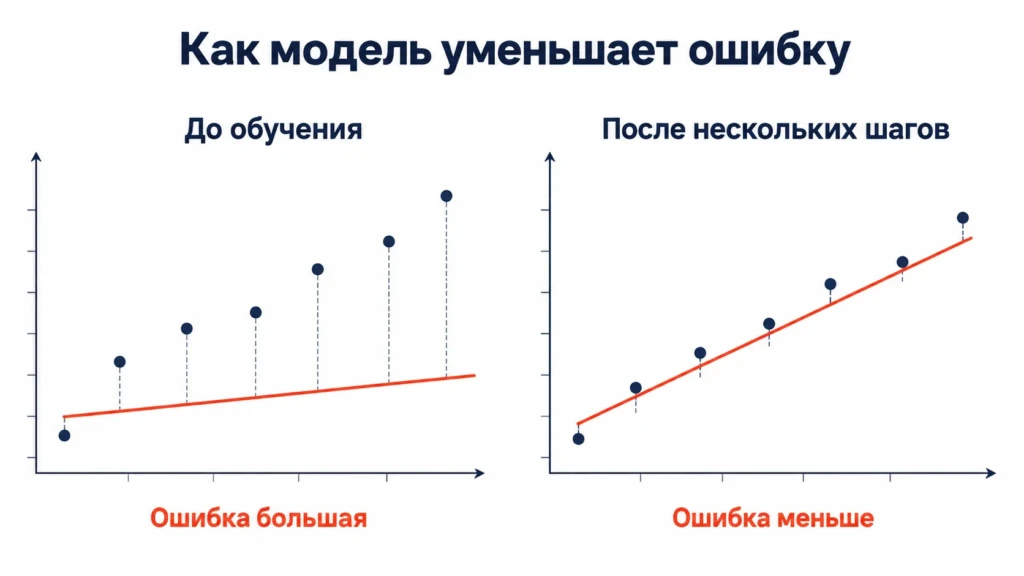
Градиентный спуск (Gradient Descent) — это алгоритм, который помогает нейросети уменьшать ошибки во время обучения. Для этого он постепенно меняет параметры модели, от которых зависят её ответы.
Представим, что компания разрабатывает нейросеть для прогнозирования количества заявок с рекламы. Ей показывают статистику прошлых кампаний: расходы, клики, показы и число полученных лидов. На этих данных модель учится определять, как связаны рекламные показатели.
Сначала предсказания могут быть неточными. Например, нейросеть ожидает 40 заявок, хотя кампания принесла 60. Чтобы в следующий раз получить более точный прогноз, нужно изменить параметры модели. Но как понять, какие именно и насколько сильно?
Здесь и помогает градиентный спуск. Алгоритм рассчитывает, в какую сторону стоит изменить параметры, чтобы ошибка стала меньше. После этого модель снова делает прогноз, проверяет результат и при необходимости повторяет процесс.
Важно, что во время обучения нейросеть старается уменьшить ошибку на известных ей примерах. Насколько хорошо она справится с новыми данными, проверяют отдельно.
Как работает градиентный спуск
Представьте, что вы спускаетесь с горы в густом тумане. Вершину и подножие не видно, но можно определить, в какую сторону склон идёт вниз. Вы делаете шаг, снова проверяете наклон и продолжаете движение.
Примерно так работает градиентный спуск. Только вместо высоты горы у нас ошибка нейросети, а вместо положения человека — параметры модели.
Чтобы разобраться в алгоритме, достаточно понять три понятия.
Функция потерь (Loss Function) показывает, насколько сильно предсказание модели отличается от правильного результата. Например, нейросеть ожидала 40 заявок вместо 60. Функция потерь помогает оценить величину такой ошибки.
Градиент (Gradient) показывает, как ошибка будет меняться при изменении параметров модели. По нему алгоритм определяет, в какую сторону двигаться, чтобы уменьшить ошибку.
Шаг обучения (Learning Rate) определяет, насколько сильно изменятся параметры за один шаг. Если шаг слишком маленький, обучение может идти медленно. Если слишком большой, алгоритм рискует перескочить подходящее значение.
Теперь посмотрим, как эти три элемента работают вместе.
- Нейросеть делает предсказание. Например, рассчитывает ожидаемое количество заявок по рекламной кампании.
- Программа определяет ошибку. Сравнивает прогноз с правильным результатом.
- Алгоритм рассчитывает градиент. Определяет, как изменение параметров повлияет на ошибку.
- Параметры обновляются. Алгоритм делает шаг в направлении уменьшения ошибки.
- Процесс повторяется. Модель снова делает прогноз и проверяет, насколько хорошо он получился.
Так нейросеть постепенно подбирает параметры, которые помогают ей лучше справляться с обучающими задачами.
В простом примере может быть всего один параметр. У современных нейросетей их бывают миллиарды, но общий принцип обучения остаётся похожим.
Градиентный спуск на простом примере
Чтобы увидеть работу алгоритма, возьмём задачу с одним числом. Допустим, нам нужно подобрать значение w, максимально близкое к 3.
Начнём с нуля. Чем дальше наше число от тройки, тем больше ошибка.
Посчитать её можно по формуле:
[
L(w)=(w-3)^2
]
Здесь w — число, которое мы подбираем, а L(w) — величина ошибки.
Если w = 0, ошибка равна 9. Если w = 2, ошибка равна 1. А если w = 3, ошибка становится нулевой.
Нам нужно постепенно приблизить w к тройке. Для этого используется формула градиентного спуска:
[
w_{\text{новый}}=w_{\text{старый}}-\eta\cdot\text{градиент}
]
Выглядит сложнее, чем работает. Мы берём текущее значение параметра и изменяем его с учётом градиента и скорости обучения. Символ η (эта) как раз обозначает Learning Rate.
Для нашей функции градиент рассчитывается как 2 × (w − 3). При начальном значении w = 0 он равен −6.
Выберем скорость обучения 0,2. Тогда первый шаг будет таким:
0 − 0,2 × (−6) = 1,2
После первого шага мы получили значение 1,2 вместо нуля. Ошибка уменьшилась с 9 до 3,24.
Продолжим вычисления.
| Шаг | Значение w | Ошибка |
| 0 | 0 | 9 |
| 1 | 1,2 | 3,24 |
| 2 | 1,92 | 1,1664 |
| 3 | 2,352 | 0,4199 |
| 4 | 2,6112 | 0,1512 |
| 5 | 2,7667 | 0,0544 |
За пять шагов алгоритм приблизился к числу 3, а ошибка уменьшилась почти до нуля. Если продолжить вычисления, она будет становиться ещё меньше.
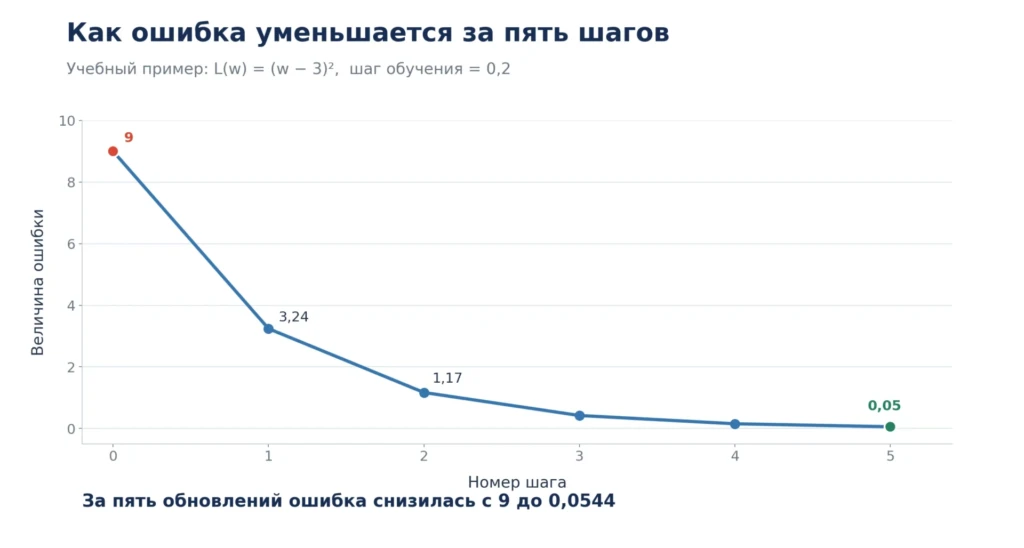
Это учебный пример с одной переменной. В настоящих нейросетях всё сложнее, потому что алгоритму приходится одновременно подбирать огромное количество параметров. Но принцип остаётся прежним: определить направление изменения и сделать следующий шаг.
Что такое Learning Rate и почему он важен
Learning Rate — это скорость обучения, которая определяет размер каждого шага градиентного спуска. От неё во многом зависит, насколько быстро модель сможет уменьшить ошибку.
Вернёмся к примеру с поиском числа 3. Мы начинали с нуля и использовали шаг 0,2. Благодаря этому ошибка быстро уменьшилась.
Но что будет, если изменить Learning Rate?
| Learning Rate | Значение после первого шага | Ошибка |
| 0,01 | 0,06 | 8,6436 |
| 0,2 | 1,2 | 3,24 |
| 1,1 | 6,6 | 12,96 |
При шаге 0,01 алгоритм двигается очень медленно. Ошибка уменьшается, но для хорошего результата понадобится больше повторений.
При шаге 0,2 модель быстро приближается к нужному числу.
А при шаге 1,1 алгоритм перескакивает через тройку и оказывается слишком далеко с другой стороны. Ошибка становится даже больше первоначальной.
Получается, что большая скорость обучения не всегда означает быстрое улучшение модели. Иногда она мешает найти подходящие значения параметров.
В реальных проектах Learning Rate подбирают экспериментально. Разработчики смотрят, как меняется ошибка, и пробуют разные настройки. Также существуют способы автоматически уменьшать шаг по мере обучения, чтобы сначала быстрее продвигаться к подходящим значениям, а затем точнее их настраивать.
Какие бывают виды градиентного спуска
При обучении нейросети приходится обрабатывать множество примеров. Например, модель для распознавания спама может учиться на сотнях тысяч электронных писем.
Возникает вопрос: обязательно ли использовать все письма для каждого обновления параметров? Или можно брать их небольшими группами?
В зависимости от того, сколько данных используется за один шаг, выделяют три основных варианта градиентного спуска.
Пакетный градиентный спуск (Batch Gradient Descent)
Алгоритм сначала обрабатывает весь обучающий набор и только после этого обновляет параметры модели.
Представим, что у нас есть 10 000 рекламных заявок. Программа рассчитывает ошибку по всем примерам, определяет градиент и выполняет одно обновление.
Такой подход учитывает всю обучающую выборку при каждом шаге. Но если данных очень много, вычисления могут занимать много времени и требовать значительных ресурсов.
Стохастический градиентный спуск (SGD)
Стохастический градиентный спуск (Stochastic Gradient Descent) использует для обновления параметров один обучающий пример.
Например, модель получает одну заявку, рассчитывает ошибку и изменяет параметры. Затем берёт следующую заявку и повторяет процесс.
Обновления происходят чаще, но отдельные примеры могут сильно отличаться друг от друга. Поэтому ошибка иногда заметно колеблется, а параметры меняются менее плавно.
Мини-пакетный градиентный спуск (Mini-Batch)
Этот вариант объединяет два предыдущих подхода. Данные обрабатываются небольшими группами.
Например, 10 000 заявок можно разделить на группы по 100. После обработки каждой группы модель обновляет параметры.
Mini-Batch широко используется при обучении современных нейросетей, поскольку позволяет эффективно обрабатывать большие наборы данных и не ждать окончания расчётов по всей выборке.
Сравним три подхода:
| Метод | Сколько данных используется за шаг |
| Batch Gradient Descent | Вся обучающая выборка |
| SGD | Один пример |
| Mini-Batch | Небольшая группа примеров |
Разработчик выбирает подход с учётом задачи, размера выборки и вычислительных ресурсов. Кстати, в современных библиотеках оптимизатор с названием SGD часто работает именно с мини-пакетами.
Как градиентный спуск помогает обучать нейросети
Вернёмся к модели, которая определяет спам. Она получает текст сообщения, анализирует его и выдаёт вероятность того, что письмо подозрительное.
Во время обучения программа знает правильный ответ для каждого примера. Если нейросеть ошиблась, нужно изменить её параметры, чтобы в дальнейшем она лучше справлялась с похожими задачами.
Эти параметры называют весами и смещениями. Они влияют на обработку информации внутри нейросети. Во время обучения алгоритм постепенно меняет их значения, чтобы уменьшить ошибки.
Здесь часто встречается термин Backpropagation — обратное распространение ошибки. Его иногда путают с градиентным спуском, хотя они выполняют разные задачи.
Backpropagation помогает рассчитать градиенты, то есть определить, как каждый параметр влияет на ошибку. А градиентный спуск использует эти значения для обновления параметров.
При разработке нейросетей также применяют оптимизаторы — алгоритмы, которые управляют обновлением весов. Среди известных вариантов SGD с Momentum и Adam. Они используют дополнительные механизмы, которые могут улучшать процесс обучения.
Используется ли градиентный спуск в ChatGPT?
Да, методы оптимизации на основе градиентов применяются при обучении больших языковых моделей.
Во время тренировки нейросеть обрабатывает большие объёмы данных, рассчитывает ошибки и изменяет параметры. Благодаря этому она постепенно учится лучше выполнять задачи, для которых её обучают.
Но когда вы открываете ChatGPT и просите написать рекламный текст, веса модели не начинают заново изменяться от каждого сообщения обычного чата. Вы используете уже обученную нейросеть.
Поэтому для повседневной работы с ИИ не нужно уметь рассчитывать градиенты. Можно создавать тексты, изображения, презентации и анализировать данные с помощью готовых инструментов.
Курс «Практикум по нейросетям» в Академии IT DMS
Цифровой сертификат после итогового теста.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
А вот если вы хотите самостоятельно разрабатывать или дообучать нейросети, понимание градиентного спуска пригодится. Оно помогает разобраться, почему обучение идёт медленно, из-за чего увеличивается ошибка и как влиять на результат.
Как попробовать градиентный спуск на Python
Посмотрим, как работает алгоритм в небольшой программе. Возьмём ту же задачу: нужно подобрать число, максимально близкое к 3.
Для этого достаточно обычного Python. Дополнительные библиотеки устанавливать не придётся.
Создайте файл gradient_descent.py и добавьте код:
def loss(w):

    return (w - 3) ** 2

def gradient(w):

    return 2 * (w - 3)

w = 0.0

learning_rate = 0.2

for step in range(6):

    print(

        f"Шаг {step}: "

        f"w = {w:.4f}, "

        f"ошибка = {loss(w):.4f}"

    )

    w = w - learning_rate * gradient(w)
В начале программы задаются две функции. Первая рассчитывает ошибку, а вторая — градиент. Затем мы устанавливаем начальное значение w = 0 и скорость обучения 0,2.
Цикл for несколько раз выводит текущую ошибку и изменяет параметр. С каждым шагом число приближается к тройке.
После запуска программа покажет:
Шаг 0: w = 0.0000, ошибка = 9.0000

Шаг 1: w = 1.2000, ошибка = 3.2400

Шаг 2: w = 1.9200, ошибка = 1.1664

Шаг 3: w = 2.3520, ошибка = 0.4199

Шаг 4: w = 2.6112, ошибка = 0.1512

Шаг 5: w = 2.7667, ошибка = 0.0544
Теперь попробуйте изменить learning_rate с 0,2 на 0,01 и запустить программу снова. Вы увидите, что ошибка уменьшается значительно медленнее.
Если установить значение 1,1, алгоритм начнёт перескакивать через минимум и ошибка будет расти.
Это простой эксперимент, который помогает увидеть влияние скорости обучения. В реальных проектах разработчики обычно используют PyTorch или TensorFlow. Эти библиотеки умеют автоматически рассчитывать градиенты и обновлять параметры нейросетей.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Как посмотреть работу градиентного спуска без программирования
Если пока не хочется разбираться в Python, можно попробовать интерактивные инструменты.
Например, у Google есть <Link url=»https://developers.google.com/machine-learning/crash-course/linear-regression/gradient-descent-exercise» title=»тренажёр градиентного спуска»/>. В нём можно изменять скорость обучения и наблюдать, как модель подбирает параметры.
Ещё один вариант — <Link url=»https://playground.tensorflow.org/» title=»TensorFlow Playground»/>. Здесь можно менять количество слоёв и нейронов, Learning Rate и другие настройки. Результаты обучения отображаются прямо на экране.
Начните с небольшой скорости обучения, посмотрите, как уменьшается ошибка, а затем увеличьте шаг. Так проще понять, почему одни настройки помогают модели учиться, а другие мешают.
Почему градиентный спуск может работать плохо
Бывает, что модель обучается очень долго, ошибка почти не уменьшается или начинает расти. Причин может быть несколько, и не всегда проблема заключается в самом алгоритме.
Например, при слишком маленьком Learning Rate параметры меняются медленно. Если шаг слишком большой, модель может постоянно перескакивать подходящие значения. Также на обучение влияют качество данных, архитектура нейросети и выбранная функция потерь.
Есть и другая проблема: алгоритм может уменьшить ошибку на обучающих данных, но модель всё равно будет плохо работать на новых примерах. Это один из возможных признаков переобучения.
Поэтому разработчики следят не только за процессом градиентного спуска, но и за качеством модели на независимых проверочных данных.
Стоит учитывать и то, что алгоритм не всегда находит самое лучшее решение из всех возможных. У простых функций может быть один минимум, а у сложных нейросетей поверхность ошибки устроена гораздо сложнее. Поэтому результат зависит от начальных параметров, настроек обучения и особенностей задачи.
Что важно помнить о градиентном спуске
Градиентный спуск помогает нейросети постепенно уменьшать ошибки. Для этого алгоритм рассчитывает, в какую сторону нужно изменить параметры модели, и делает шаг с учётом выбранной скорости обучения.
Для первого знакомства достаточно разобраться в трёх понятиях: функция потерь показывает величину ошибки, градиент помогает определить направление изменения, а Learning Rate управляет размером шага.
Если вы планируете заниматься разработкой нейросетей, дальше стоит изучить обратное распространение ошибки и оптимизаторы SGD и Adam. Эти инструменты помогают понять, как устроено обучение современных моделей на практике.
FAQ
Градиентный спуск — это алгоритм оптимизации, который постепенно изменяет параметры модели, чтобы уменьшить ошибку её предсказаний.
Он помогает обновлять параметры нейросети на основе вычисленных градиентов и уменьшать функцию потерь во время обучения.
Шаг обучения, или Learning Rate, определяет величину изменения параметров модели при каждом обновлении. Слишком маленький шаг замедляет обучение, а слишком большой может сделать его нестабильным.
Классический стохастический градиентный спуск рассчитывает обновление по одному примеру, пакетный — по всей обучающей выборке, а Mini-Batch — по небольшим группам примеров.
Это реализация алгоритма, который вычисляет градиент функции потерь и обновляет параметры модели. Для этого можно использовать обычный Python или библиотеки машинного обучения.
Backpropagation вычисляет градиенты параметров нейросети. Градиентный спуск использует их для обновления параметров и уменьшения ошибки.