Нейросеть может почти безошибочно справляться с примерами, на которых её обучали, но допускать много ошибок на новых данных. Это называется переобучением, или overfitting. Разберём, почему оно возникает, как заметить проблему и какие методы помогают улучшить работу модели.
Что такое переобучение нейросети простыми словами
Переобучение нейросети (overfitting) — это ситуация, когда модель слишком сильно подстраивается под обучающие данные и плохо справляется с незнакомыми примерами. Она запоминает особенности исходной выборки, включая случайные совпадения, вместо того чтобы научиться находить закономерности, которые пригодятся в дальнейшем.
Представим, что компания обучает нейросеть отличать настоящие заявки с сайта от спама. Для этого ей показывают несколько тысяч обращений, заранее отмеченных как качественные или подозрительные. Постепенно модель начинает замечать характерные признаки спама: повторяющиеся формулировки, подозрительные ссылки, определённые сочетания слов.
Но во время обучения нейросеть может слишком сильно привязаться к конкретным примерам. Допустим, среди спамных заявок часто встречается слово «заработок». Модель начинает считать его одним из главных признаков мошенничества, хотя само по себе это слово ничего не доказывает. В результате обычные обращения с похожими формулировками могут ошибочно попадать в спам.
Предположим, после обучения нейросеть показывает следующие результаты:
| Данные | Точность модели |
| Обучающие заявки | 98% |
| Новые заявки | 73% |
Цифры условные, но хорошо показывают проблему. На знакомых примерах нейросеть почти не ошибается, а на новых её точность оказывается на 25 процентных пунктов ниже. Такой разрыв может указывать на переобучение, хотя для окончательного вывода нужно проверить качество данных и условия тестирования.
Способность модели правильно работать с новыми примерами в машинном обучении называется обобщением (generalization). Именно она важна для реального использования нейросети. Высокая точность на обучающей выборке сама по себе ещё не означает, что модель готова к работе.
Почему возникает переобучение нейросети
У переобучения нет одной причины. Иногда дело в недостатке данных, иногда — в сложности модели или слишком продолжительном обучении. Разберём наиболее распространённые ситуации.
Мало обучающих данных
Допустим, нейросеть учат распознавать собак по фотографиям. Ей показывают всего 50 снимков, причём почти все сделаны на улице при хорошем освещении. Модель может запомнить не только особенности животных, но и фон, освещение и другие случайные детали.
Когда нейросети покажут собаку в квартире или на фотографии, сделанной вечером, она может ошибиться. Раньше ей просто не встречались такие условия, поэтому она не научилась уверенно распознавать животное независимо от окружения.
При обучении важно использовать разнообразные примеры. Причём количество не всегда решает проблему: тысяча почти одинаковых фотографий может оказаться менее полезной, чем несколько сотен снимков с разными ракурсами, освещением и фоном.
Слишком сложная модель
Нейросети состоят из связанных между собой вычислительных элементов — искусственных нейронов. Их работа зависит от параметров, которые изменяются во время обучения. Чем сложнее архитектура, тем больше зависимостей модель потенциально способна находить в данных.
Но большая нейросеть не обязательно лучше маленькой. Если обучающих примеров недостаточно, сложная модель может начать учитывать случайные особенности каждого из них. На знакомой выборке она покажет отличный результат, но при появлении новых данных многие найденные зависимости окажутся бесполезными.
В некоторых задачах уменьшение количества слоёв или нейронов помогает улучшить качество. Правда, чрезмерно упрощать модель тоже нельзя: тогда ей может не хватить возможностей для распознавания действительно важных закономерностей.
Слишком долгое обучение
Нейросеть обычно обучают в несколько циклов. Один полный проход по обучающему набору данных называется эпохой (epoch). После каждого прохода модель корректирует свои параметры, стараясь уменьшить количество ошибок.
Сначала обучение приносит пользу: нейросеть всё лучше справляется с задачей. Но в какой-то момент результат на новых примерах может перестать улучшаться, хотя на знакомых данных точность продолжает расти. Это означает, что дальнейшее обучение может усиливать переобучение.
Поэтому количество эпох не стоит считать самостоятельным показателем качества. Гораздо важнее следить за тем, как нейросеть работает с данными, которые не использовались для изменения её параметров.
Переобучение и недообучение: в чём разница
Кроме overfitting, в машинном обучении встречается противоположная проблема — недообучение (underfitting). В этом случае модель ещё не научилась достаточно хорошо решать задачу и допускает много ошибок даже на знакомых примерах.
Представим нейросеть для распознавания рукописных цифр. Если она недообучилась, то будет путать 3 и 8 и на обучающих изображениях, и на новых. При переобучении ситуация другая: модель отлично распознаёт цифры из учебной выборки, но начинает ошибаться, когда видит незнакомый почерк.
| Состояние модели | Обучающие данные | Новые данные |
| Недообучение | Много ошибок | Много ошибок |
| Хорошее обучение | Хороший результат | Сопоставимый хороший результат |
| Переобучение | Очень хороший результат | Заметно хуже |
Для борьбы с недообучением иногда увеличивают сложность модели или продолжительность обучения. При переобучении могут помочь противоположные действия: уменьшение сложности, более ранняя остановка обучения и специальные методы ограничения модели.
Главная задача разработчика — найти подходящие настройки, при которых нейросеть не только хорошо справляется с учебными примерами, но и сохраняет качество на новых данных.
Как определить переобучение нейросети
Один из самых надёжных способов обнаружить проблему — сравнить результаты модели на обучающих и независимых проверочных данных. Для этого ещё до начала обучения нужно правильно организовать эксперимент.
Разделите данные на три выборки
В машинном обучении данные обычно распределяют между тремя наборами. У каждого своя задача:
| Выборка | Для чего используется |
| Train — обучающая | Нейросеть изучает примеры и изменяет свои параметры |
| Validation — проверочная | Разработчик оценивает промежуточные результаты и подбирает настройки |
| Test — тестовая | Проводится финальная проверка модели на отложенных данных |
Например, можно выделить 70% примеров для обучения, 15% для проверки и ещё 15% для тестирования. Это распространённый вариант, но не обязательное правило. Пропорции зависят от объёма данных, сложности задачи и способа оценки.
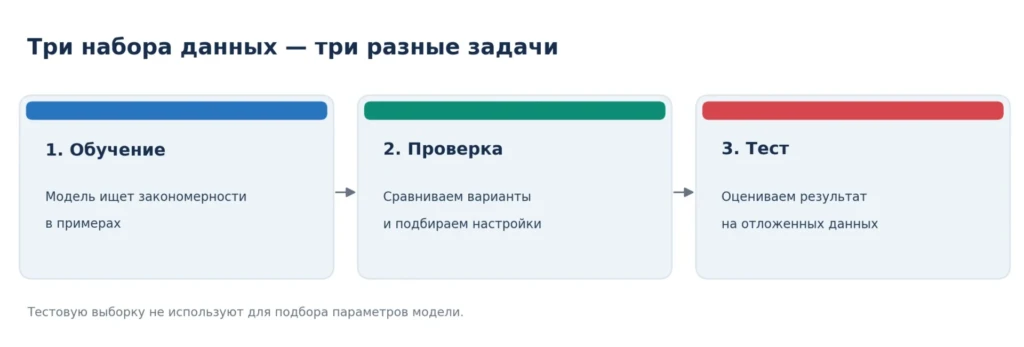
Важно, чтобы проверка действительно проводилась на независимых примерах. Если одни и те же заявки случайно попадут одновременно в обучающую и тестовую выборки, модель может показать завышенную точность.
Для данных, которые меняются со временем, тоже есть нюанс. Например, если нейросеть прогнозирует результаты рекламных кампаний, случайное перемешивание всей истории не всегда подходит. Часто разумнее обучать модель на более ранних периодах, а проверять на поздних, чтобы приблизить эксперимент к реальным условиям прогнозирования.
Сравните показатели на графике
При обучении нейросетей часто используют показатель Loss — функцию потерь. Он показывает, насколько предсказания модели отличаются от правильных ответов согласно выбранному способу расчёта. Обычно чем ниже Loss, тем лучше результат.
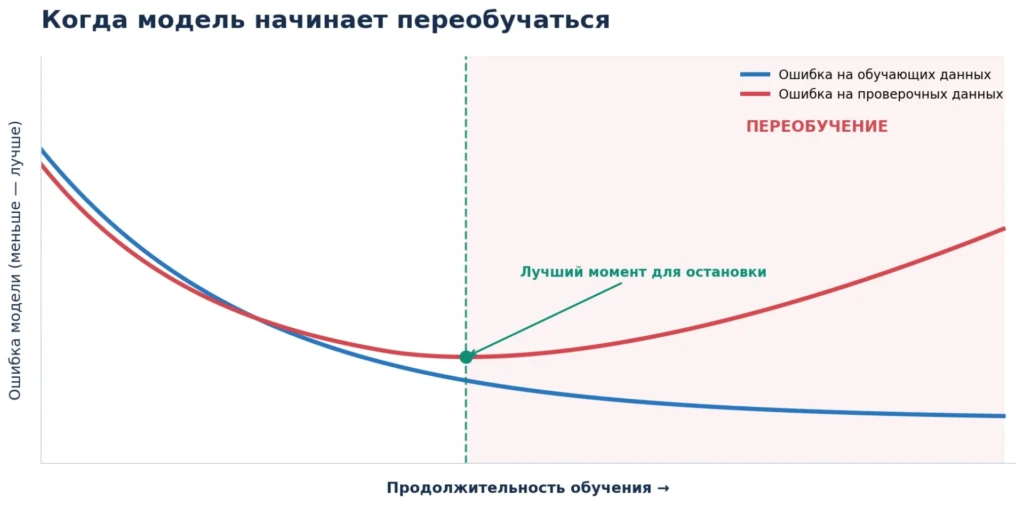
Разработчики отслеживают две кривые: ошибку на обучающих данных и ошибку на проверочных. В начале обе могут снижаться, поскольку нейросеть действительно учится. Но затем иногда возникает расхождение: на знакомых данных ошибка продолжает уменьшаться, а на новых начинает расти.
Это один из характерных признаков переобучения. Модель всё лучше запоминает обучающую выборку, но её способность справляться с незнакомыми примерами уже ухудшается.
Небольшая разница между показателями нормальна. Насторожить должен устойчивый разрыв, особенно если проверочная ошибка растёт на протяжении нескольких эпох. Для просмотра таких графиков используют TensorBoard и другие инструменты анализа обучения. Они помогают определить, когда качество перестало улучшаться и какие изменения стоит попробовать.
Как бороться с переобучением нейросети
Универсального способа, который гарантированно избавляет от overfitting, нет. Если проблема связана с некачественными данными, изменение архитектуры может не помочь. Поэтому прежде чем менять настройки, стоит разобраться, из-за чего модель ошибается.
Улучшить обучающие данные
Часто помогает расширение и улучшение выборки. Если нейросеть плохо распознаёт фотографии в темноте, стоит добавить примеры с разным освещением. Если модель для определения спама ошибается на новых формулировках, полезно расширить набор текстов.
Также используют аугментацию данных (data augmentation) — создание дополнительных вариантов на основе существующих примеров. Например, при обучении распознаванию изображений фотографии можно немного поворачивать, обрезать или менять их яркость. Так модель увидит больше вариантов одного объекта без необходимости собирать совершенно новый набор изображений.
Но преобразования должны сохранять правильный ответ. Если нейросеть учится распознавать цифры, произвольный поворот изображения может изменить сам символ и испортить обучение.
Остановить обучение раньше
Метод Early Stopping позволяет прекратить обучение, когда результат на проверочных данных перестаёт улучшаться. Это помогает избежать ситуации, когда модель продолжает запоминать обучающую выборку, хотя качество на новых примерах уже снижается.
Допустим, нейросеть должна пройти 30 эпох. К десятой эпохе ошибка на проверочных данных достигает минимума, а затем начинает расти. В таком случае можно остановить обучение и использовать параметры модели, полученные на более раннем этапе.
В библиотеке Keras для этого предусмотрен готовый инструмент EarlyStopping:
from keras.callbacks import EarlyStopping

early_stopping = EarlyStopping(

    monitor="val_loss",

    patience=3,

    restore_best_weights=True

)
Параметр monitor=»val_loss» указывает, что нужно следить за ошибкой на проверочных данных. Значение patience=3 разрешает подождать три эпохи без улучшения, прежде чем остановить обучение. А restore_best_weights=True возвращает параметры модели к состоянию, при котором проверочный результат был лучшим.
Это настройка механизма остановки, а не полноценная программа обучения. Чтобы он заработал, нужно передать его в model.fit() и предоставить модели проверочные данные.
Упростить модель
Если нейросеть очень сложная, а обучающих данных немного, можно попробовать уменьшить количество слоёв или нейронов. Затем сравнить качество новой версии с предыдущей на одинаковой проверочной выборке.
Например, вместо двух скрытых слоёв по 100 нейронов использовать один слой с восемью нейронами. В некоторых задачах более простая модель лучше справляется с новыми данными, поскольку у неё меньше возможностей запоминать случайные детали.
Но уменьшать сложность бесконечно нельзя. Если модель станет слишком простой, появится недообучение, и качество ухудшится уже на знакомых примерах.
Использовать регуляризацию
Регуляризация (regularization) — это методы, которые ограничивают чрезмерную подстройку модели под обучающую выборку. Они помогают уменьшить влияние случайных деталей, которые могут мешать работе на новых данных.
Один из способов — L2-регуляризация. Она добавляет штраф за слишком большие значения весов модели. Веса — это параметры, которые определяют, насколько сильно отдельные признаки влияют на предсказание.
Другой метод называется Dropout. Во время обучения он случайным образом отключает часть выходов нейронов в определённых слоях, чтобы модель меньше зависела от отдельных связей.
Оба метода могут помочь, но настройки приходится подбирать экспериментально. Слишком сильная регуляризация ограничит модель настолько, что она перестанет находить даже важные закономерности.
Проверить данные на утечки
Иногда нейросеть показывает подозрительно хорошие результаты из-за ошибки в подготовке данных. Например, одинаковые заявки случайно попали и в обучающую, и в тестовую выборку. Модель уже видела эти примеры, поэтому проверка создаёт ложное впечатление высокого качества.
Такая ситуация называется утечкой данных (data leakage). Другой пример — модель должна прогнозировать вероятность покупки, но среди её входных данных оказалась информация о том, что покупка уже совершена. При реальном прогнозировании такого признака ещё не будет.
Утечка данных сама по себе не равнозначна переобучению, но тоже мешает объективно оценить модель. В подобных случаях исправлять нужно прежде всего подготовку данных, а не архитектуру нейросети.
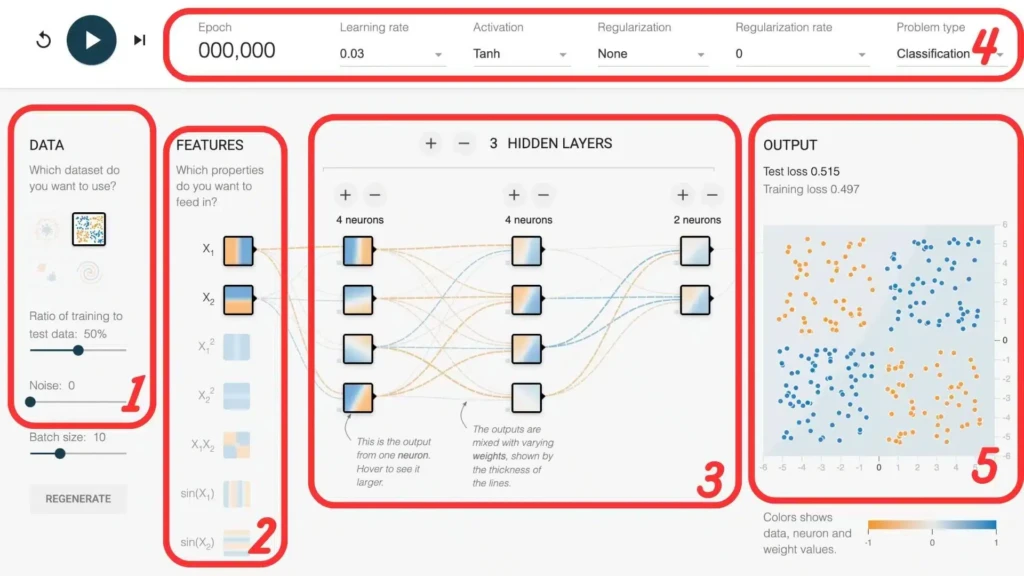
Пример переобучения нейросети на Python
Посмотрим, как переобучение проявляется в небольшом эксперименте. Для этого используем библиотеку scikit-learn и искусственный набор данных make_moons. Он состоит из точек двух классов, расположенных в форме полумесяцев. Нейросеть должна научиться различать эти классы.
Преимущество примера в том, что для него не нужны реальные пользовательские данные или подключение к сторонним сервисам. Достаточно установленного Python и библиотеки scikit-learn, которую можно добавить командой:
pip install scikit-learnТеперь создадим набор из 80 точек, разделим его на две части и обучим небольшую нейросеть с двумя скрытыми слоями.
from sklearn.datasets import make_moons

from sklearn.model_selection import train_test_split

from sklearn.neural_network import MLPClassifier

X, y = make_moons(

    n_samples=80,

    noise=0.30,

    random_state=42

)

X_train, X_test, y_train, y_test = train_test_split(

    X, y,

    test_size=0.35,

    stratify=y,

    random_state=42

)

model = MLPClassifier(

    hidden_layer_sizes=(100, 100),

    alpha=0.00001,

    max_iter=1300,

    random_state=42

)

model.fit(X_train, y_train)

print("Обучение:", model.score(X_train, y_train))

print("Проверка:", model.score(X_test, y_test))
Здесь n_samples=80 задаёт количество примеров, а noise=0.30 добавляет разброс точек, чтобы задача была не слишком простой. Затем программа выделяет 65% данных для обучения и 35% для проверки. Параметр hidden_layer_sizes=(100, 100) создаёт два скрытых слоя по 100 нейронов, а маленькое значение alpha задаёт слабую регуляризацию.
При запуске со scikit-learn 1.8.0 получились следующие результаты:
| Данные | Точность |
| Обучающие | 100% |
| Отложенные | 71,4% |
Нейросеть правильно классифицировала все 52 обучающих примера, но ошиблась на восьми из 28 новых. Разница хорошо показывает, как модель может отлично запомнить исходную выборку и значительно хуже справляться с незнакомыми данными.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Это небольшой учебный эксперимент, поэтому результаты чувствительны к случайному разбиению. В полноценном проекте дополнительно выделяют проверочную выборку для подбора настроек, используют несколько проверок и только после выбора модели проводят финальное тестирование. Иначе есть риск подобрать параметры под сами тестовые данные.
Бывает ли переобучение у ChatGPT и других генеративных нейросетей
Да, большие языковые модели тоже могут переобучаться. Особенно это актуально при дополнительном обучении на собственных данных — fine-tuning.
Например, компания хочет дообучить языковую модель отвечать на обращения клиентов. Для этого собирают несколько тысяч примеров вопросов и правильных ответов. Если все вопросы сформулированы очень похоже, модель может научиться хорошо воспроизводить знакомые шаблоны, но хуже справляться с необычными запросами.
Поэтому при дообучении языковых моделей также используют независимые проверочные наборы. Они помогают понять, насколько хорошо модель справляется с вопросами, которых не было среди обучающих примеров.
При этом важно отличать переобучение от обычных ошибок генеративного ИИ. Если ChatGPT неправильно ответил на вопрос или придумал несуществующий факт, это ещё не доказывает overfitting. Причиной могут быть недостаток информации, неточный запрос или ограничения самой модели.
Если вы добавили в промпт несколько примеров и попросили нейросеть писать в похожем стиле, это тоже не переобучение в техническом смысле. Вы передали дополнительную информацию для формирования ответа, но не изменили веса модели, как при настоящем обучении.
Для повседневных задач — написания текстов, подготовки презентаций, анализа таблиц и изображений — обычно достаточно научиться правильно формулировать запросы, предоставлять нужный контекст и проверять результаты.
Курс «Практикум по нейросетям» в Академии IT DMS
Цифровой сертификат после итогового теста.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
А если вы разрабатываете собственное ИИ-приложение или дообучаете модель на корпоративных данных, понадобятся более глубокие знания: как готовить выборки, выбирать параметры обучения, оценивать качество и устранять переобучение.
Что важно помнить о переобучении
Переобучение возникает, когда нейросеть слишком сильно подстраивается под исходные примеры и теряет способность хорошо работать с новыми данными. Поэтому высокая точность во время обучения ещё не говорит о том, что модель готова к использованию.
Чтобы обнаружить проблему, сравнивают результаты на независимых выборках и следят за графиками ошибок. Если качество на новых данных начинает ухудшаться, проверяют обучающие примеры, сложность модели и настройки обучения.
Иногда достаточно добавить разнообразные данные или раньше остановить обучение. В других случаях приходится менять архитектуру и применять регуляризацию. Главное — оценивать нейросеть по тому, насколько хорошо она справляется с реальными задачами, а не по красивым цифрам на обучающей выборке.
FAQ
Один из главных признаков — высокое качество на обучающих данных при заметно худших результатах на новых. Проверочная ошибка может расти, даже если тренировочная продолжает снижаться.
При переобучении модель хорошо работает на обучающих примерах, но хуже на новых. При недообучении она допускает много ошибок даже на обучающей выборке.
Основные методы включают улучшение обучающих данных, Early Stopping, упрощение модели, регуляризацию L1/L2 и Dropout.
Единственного гарантированного метода нет. Early Stopping помогает ограничить переобучение, останавливая тренировку после прекращения улучшения на проверочных данных.
Большие языковые модели могут переобучаться при тренировке или дополнительном обучении. Однако отдельный ошибочный ответ ChatGPT не доказывает наличие переобучения.