Разработчику нужно проверить новый отчёт по рекламе, а в рабочей выгрузке хранятся идентификаторы пользователей, выплаты и внутренние показатели. Вместо копии базы можно создать искусственную таблицу с такими же столбцами и правдоподобными значениями. Такие наборы называют синтетическими данными.
Что такое синтетические данные простыми словами
Синтетические данные — это искусственно созданные записи, которые повторяют структуру и нужные закономерности исходной информации. Они могут выглядеть как обычная таблица с кликами и заявками, хотя строки в ней относятся к вымышленным событиям.
Пример такого дашборда:
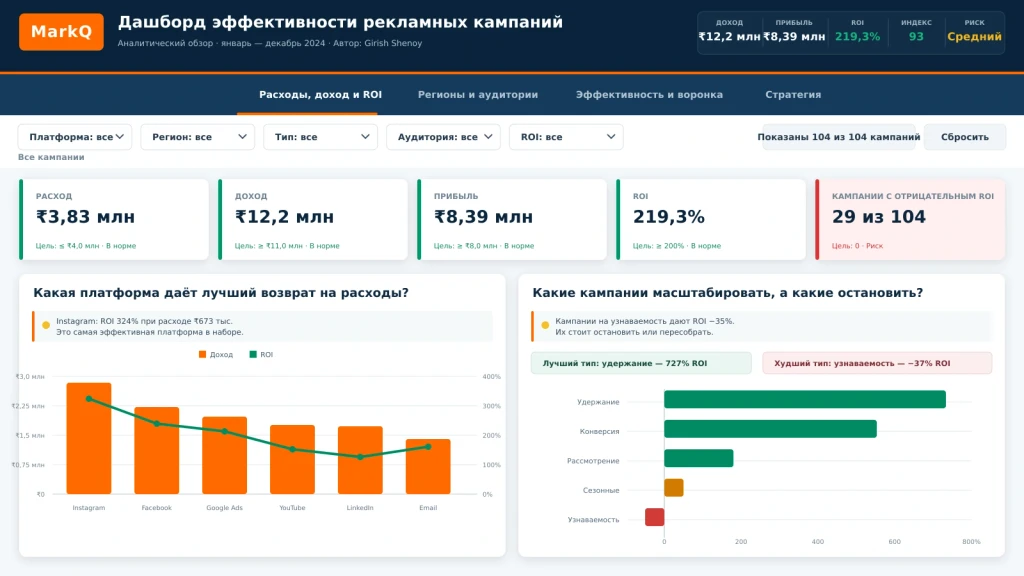
В рекламной аналитике синтетический датасет может содержать источник трафика, кампанию, GEO, устройство, время клика, статус заявки и выплату. Генератор заполняет таблицу так, чтобы значения не противоречили друг другу. Например, заявка появляется после клика, а выплата начисляется только при нужном статусе.
Случайный набор цифр для этой задачи не подойдёт. Дашборд, возможно, откроется, но фильтры, расчёты и модель будут работать с бессмысленными сочетаниями. В полезном датасете соблюдаются правила, которые команда собирается проверить.
Где синтетические данные пригодятся вебмастеру или digital-команде
Чаще всего такие наборы нужны разработчикам, аналитикам и специалистам по машинному обучению. С ними сталкиваются и команды, которые работают с трафиком, трекерами, CRM и отчётами.
| Задача | Как используют синтетические данные |
| Проверить новый дашборд | Загружают искусственные кампании, клики и заявки, затем проверяют фильтры и расчёты |
| Передать данные подрядчику | Дают таблицу нужного формата без копии рабочей базы |
| Протестировать CRM или трекер | Создают события с разными статусами, пустыми полями и ошибками |
| Проверить редкие ситуации | Добавляют дубли заявок, возвраты, отклонённые лиды или пропущенное GEO |
| Обучить модель | Дополняют выборку примерами, которых мало в исходной статистике |
Синтетический отчёт не показывает реальную прибыль кампании и не заменяет рабочую аналитику. Его задача — проверить, как система принимает, обрабатывает и показывает данные. Для оценки трафика по-прежнему нужны фактические клики, расходы, заявки и выплаты.
Как создают синтетические данные
Способ зависит от задачи. Для тестовой CRM часто хватает правил, а для сложных таблиц и машинного обучения используют модели, которые изучают связи в исходном наборе.
| Способ | Как работает | Когда подходит |
| По правилам | Команда задаёт столбцы, форматы и допустимые значения | Формы, отчёты, CRM и тестовые базы |
| На основе исходной таблицы | Генератор изучает частые значения и связи между столбцами | Аналитика и машинное обучение |
| В симуляторе | Программа воспроизводит события в виртуальной среде | Изображения, датчики и компьютерное зрение |
В проектах с рекламной аналитикой обычно используют первые два способа. Правила дают больше контроля, а обученный генератор лучше повторяет сложные связи. Отдельно мы объясняли, как работает генеративный ИИ и откуда модель берёт материал для новых примеров.
Перед генерацией специалист разбирает исходную таблицу: ищет пропуски, проверяет форматы, смотрит, какие значения встречаются чаще и как связаны столбцы. Например, он выясняет, какие устройства преобладают в каждом GEO и какие статусы могут идти после заявки. Для такой работы нужны анализ данных, статистика и понимание бизнес-задачи.
Курс «Data Science и Machine Learning» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Как создают синтетический датасет для рекламной аналитики
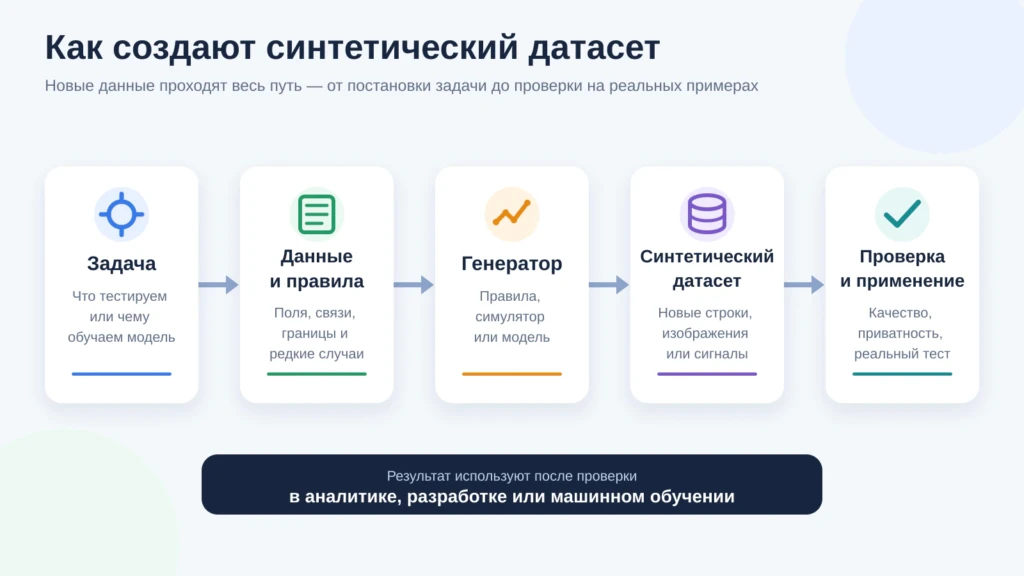
Допустим, команда готовит новый дашборд. В нём должны отображаться кампании, клики, заявки, принятые лиды и выплаты. Рабочую базу разработчику передавать нельзя, поэтому для проверки создают отдельный набор.
Схема такая:
- Определяем задачу. Команда решает, что нужно проверить: загрузку таблицы, фильтры, формулы или модель.
- Выбираем поля. В набор включают источник, кампанию, GEO, устройство, время клика, статус заявки и выплату.
- Задаём правила. Заявка не может появиться раньше клика, а её статус должен соответствовать выплате.
- Создаём строки. Генератор заполняет таблицу вымышленными событиями.
- Проверяем результат. Данные загружают в систему и смотрят, правильно ли работают расчёты и нужные сценарии.
Для проверки интерфейса достаточно правильного формата и заранее подготовленных крайних случаев. Например, полезно добавить пустое GEO, дубль заявки или кампанию без конверсий. Так разработчик увидит, что происходит с отчётом в ситуациях, которые редко попадаются в обычной выгрузке.
Как синтетические данные используют в машинном обучении
Представим модель, которая оценивает вероятность заявки по источнику, GEO, устройству и времени перехода. Если в исходной выборке мало данных по отдельному региону или редкому типу трафика, модель почти не учится работать с такими случаями. Синтетические строки помогают добавить примеры для эксперимента.
Здесь легко получить обратный эффект. Если генератор без причины сделает мобильный трафик почти всегда конверсионным, модель запомнит эту ошибку. Поэтому сначала фиксируют результат на исходной выборке, затем добавляют синтетические строки и сравнивают обе версии на одном отдельном наборе настоящих данных.
В ML-проекте специалист выбирает столбцы, по которым модель строит прогноз, обучает алгоритм и проверяет результат. Долю синтетических данных подбирают экспериментально, а каждый вариант сравнивают на одной и той же тестовой выборке.
Как проверить качество синтетических данных
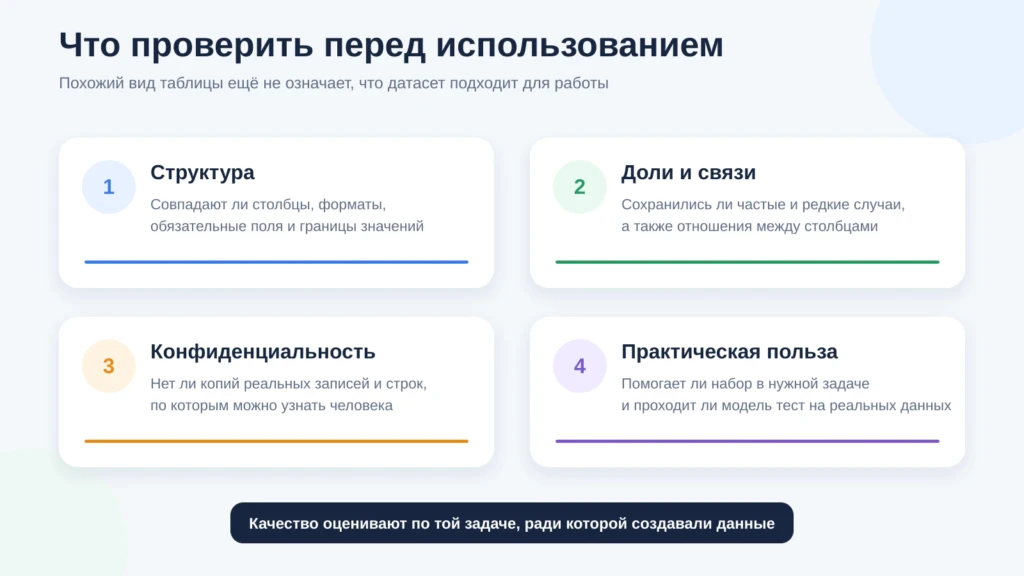
Красивой таблицы с правдоподобными цифрами недостаточно. Набор проверяют по тем условиям, ради которых его создавали.
- Совпадает ли структура. Нужны правильные столбцы, даты, форматы и обязательные поля.
- Соблюдается ли логика. Заявка следует за кликом, выплата соответствует статусу, число лидов не превышает число переходов.
- Есть ли нужные редкие случаи. В наборе должны появиться ошибки и пограничные ситуации, которые команда хочет проверить.
- Нет ли копий рабочих записей. Это особенно важно, если генератор обучался на исходной базе.
- Помог ли набор решить задачу. Дашборд должен корректно считать показатели, а ML-модель — проходить проверку на отдельной реальной выборке.
Один и тот же датасет может хорошо подойти для проверки интерфейса и плохо — для машинного обучения. В первом случае важны формат и граничные значения. Во втором нужны правдоподобные связи между источником, устройством, GEO и результатом сессии.
Чем синтетические данные отличаются от обезличенных
Синтетические данные часто путают с обезличиванием и аугментацией. Разница влияет на риск утечки и на то, для какой задачи подходит набор.
| Вид данных | Как получают | Пример |
| Синтетические | Создают новые вымышленные записи | Искусственные рекламные сессии для тестового дашборда |
| Обезличенные | Удаляют или меняют идентификаторы в настоящих строках | Выгрузка заявок без имени и контактов |
| Дополненные | Изменяют существующие примеры, сохраняя их смысл | Поворот изображения или изменение его яркости |
Обезличенная строка всё ещё основана на настоящем событии, поэтому иногда человека можно определить по косвенным признакам. Синтетическая запись создаётся заново. Если генератор обучался на рабочей базе, готовый набор всё равно проверяют на слишком близкие совпадения.
Какие ошибки встречаются при генерации
Тестовая таблица без пустых полей, задержанных событий и дублей плохо описывает рабочую систему. На таком наборе проверка проходит успешно, а после подключения рабочей базы появляются ошибки. Такие случаи добавляют в датасет заранее.
Генератор также повторяет недостатки исходной информации. Если в выгрузке почти нет данных по определённому GEO, искусственные строки не восполнят пробел автоматически. Для такой группы задают отдельные правила, собирают дополнительные данные или проводят отдельный эксперимент.
Синтетические данные помогают безопаснее тестировать сервисы и дополнять обучающие выборки, но выводы по ним всегда сверяют с рабочей системой. Для дашборда проверяют расчёты и обработку ошибок, для ML-модели — качество на отдельной реальной выборке.
*Instagram и Facebook принадлежат Meta Platforms Inc., деятельность которой признана экстремистской и запрещена на территории РФ.
FAQ
Да. В тестовый набор можно добавить кампании, клики, заявки, разные статусы и выплаты. Разработчик проверит загрузку, фильтры и расчёты без копирования рабочей базы.
В отдельных задачах это возможно, особенно при качественной симуляции. Для рекламной аналитики безопаснее сравнивать результат с моделью, обученной на исходных данных, и проверять обе версии на отдельной реальной выборке.
Нет. Генератор, обученный на рабочей базе, может слишком точно повторить редкую запись. Перед передачей набора проверяют совпадения и возможность определить человека по косвенным признакам.
Готовой доли для всех проектов нет. Сначала измеряют результат на исходной выборке, затем добавляют искусственные примеры небольшими порциями и каждый раз проверяют модель на одном и том же наборе настоящих данных.
Он соблюдает структуру и правила исходной системы, содержит нужные редкие случаи и помогает решить поставленную задачу. Для машинного обучения итоговый результат проверяют на данных, которые не участвовали в генерации.