В переписке с нейросетью мы считаем сообщения, а модель обрабатывает их в токенах — небольших фрагментах текста. От их количества зависит, поместится ли документ в запрос и сколько будет стоить его обработка через API. Показываем на примерах, как считаются токены, чем отличаются лимиты и как оценить расходы на работу с ИИ.
Как текст превращается в токены
Токеном может быть целое слово, его часть, знак препинания или сочетание пробела с буквами. Перед обработкой запроса специальная программа — токенизатор — разбивает текст на такие фрагменты. Каждому соответствует числовой идентификатор. Модель обрабатывает последовательность этих чисел, а при генерации ответа выбирает следующие токены. Затем они преобразуются в текст, который ты видишь в чате.
Границы токенов не обязаны совпадать с границами слов или слогов. Например, начало слова может оказаться одним токеном, а окончание — другим. Пробел тоже имеет значение: слово с пробелом перед ним может кодироваться иначе, чем то же слово в начале строки.
У токенизатора есть словарь допустимых токенов. Как именно он разобьёт фразу, зависит от этого словаря и правил кодирования. Поэтому универсального ответа на вопрос «сколько токенов в одном слове» нет.
Почему два слова могут занимать семь токенов
Для статьи мы посчитали фразу «Привет, мир!» с помощью открытой библиотеки OpenAI tiktoken в двух кодировках.
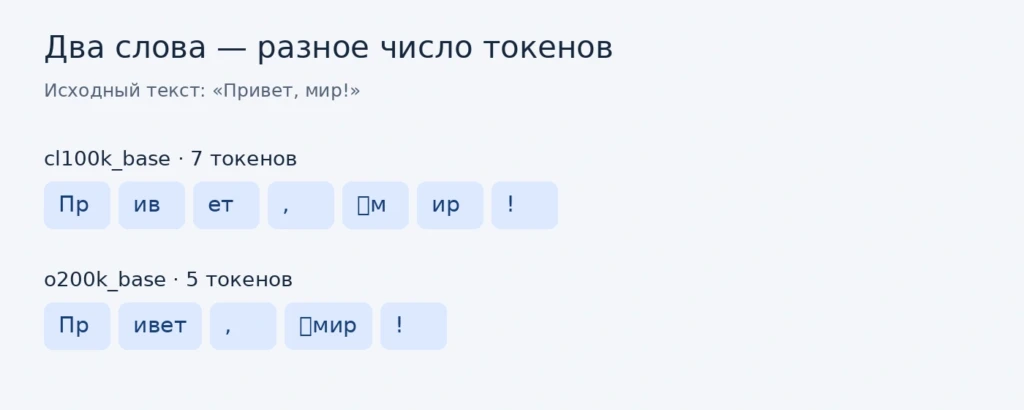
Ориентир «один токен — примерно четыре символа», который приводит OpenAI, относится к английскому тексту. Для своего материала лучше использовать счётчик выбранной модели: на результат влияют язык, числа, ссылки и форматирование.
Как узнать, сколько токенов в твоём тексте
Для предварительной оценки подойдёт официальный токенизатор или метод подсчёта токенов у разработчика модели. Например, у OpenAI есть онлайн-токенизатор, а в Gemini API — метод подсчёта входных токенов.
Для оценки объёма запроса:
- Уточни модель и токенизатор. Счётчик для другой кодировки может дать другое число.
- Вставь весь текст, который собираешься передать. Включи задачу, исходный материал, примеры и требования к ответу.
- Если работаешь через API, проверь статистику завершённого запроса. Она покажет фактический расход, который учитывает сервис.
Полный запрос может оказаться больше текста, который ты проверила в счётчике. Приложение может добавлять свои инструкции, историю переписки и описания доступных инструментов. Изображения и другие вложения тоже обрабатываются по правилам конкретной модели.
Допустим, ты хочешь сократить статью и получить пять вариантов заголовка. Для оценки нужно посчитать и статью, и задание к ней. Если вставить только фразу «сократи статью», результат ничего не скажет о размере будущего запроса.
Курс «Практикум по нейросетям» в Академии IT DMS
Цифровой сертификат после итогового теста.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Чем отличаются входные и выходные токены
Входные токены — это данные, которые модель получает для подготовки ответа. Выходные — то, что она генерирует. В API их часто обозначают как input и output, а в некоторых интерфейсах — prompt и completion.
Во вход могут попадать твой вопрос, документ, инструкции приложения и та часть предыдущей переписки, которую сервис передаёт модели. Поэтому новый вопрос из трёх слов может сопровождаться большим объёмом входных данных.
Представь, что ты загрузил статью, попросил сделать выжимку, а затем написал: «Теперь предложи заголовки». Чтобы заголовки относились к статье, модели нужен материал из предыдущего обмена. Если приложение снова передаёт его в запросе, он снова учитывается во входных токенах. Само приложение может сокращать историю или заменять её пересказом, поэтому расход зависит и от устройства сервиса.
У моделей с рассуждением в расход выхода могут входить и внутренние рассуждения, которые не показываются в ответе. Поэтому для расчёта стоимости используй статистику запроса: длины видимого текста недостаточно.
Что такое контекстное окно и почему документ не помещается
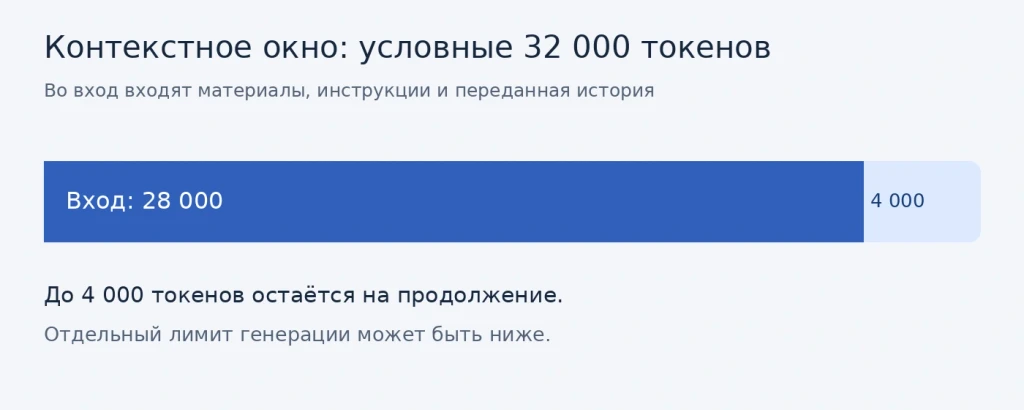
Контекстное окно — это максимальный объём данных, с которым модель может работать в пределах одного запроса. Его измеряют в токенах. Это ограничение нужно отличать от максимальной длины ответа.
Условный пример: модель поддерживает контекст в 32 000 токенов. Если полный вход занимает 28 000, на продолжение остаётся не больше 4 000. При этом отдельный лимит модели на генерацию может разрешать ещё меньше.
В обычном чате при достижении предела сервис может предложить начать новый диалог или сократить историю. В API слишком большой запрос может закончиться ошибкой.
Большое окно полезно для длинных документов, но не гарантирует, что модель правильно использует каждый фрагмент. Если задача касается одного раздела договора, часто удобнее передать этот раздел вместе с нужными определениями, чем загружать всю папку документов.
Как посчитать стоимость токенов
В API цену часто указывают за миллион токенов. Вход и выход могут стоить по-разному. Чтобы оценить расходы, нужно отдельно посчитать обе части, а затем сложить результаты.
Возьмём условный тариф: $1 за миллион входных токенов и $5 за миллион выходных. Запрос содержит 12 000 входных токенов, модель генерирует 1 500 выходных.
Как посчитать стоимость токенов
В API цену обычно указывают за миллион токенов. Вход и выход оплачиваются отдельно, поэтому для расчёта нужно знать объём запроса и ответа.
Возьмём Chat Latest (chat-latest) — модель OpenAI, которая соответствует актуальной Instant-модели в ChatGPT. На 26 октября 2026 года стандартная цена в API составляет $5 за миллион входных токенов и $30 за миллион выходных.
Допустим, полный запрос занимает 12 000 входных токенов, а ответ — 1 500 выходных. Посчитаем каждую часть:
- Вход: 12 000 ÷ 1 000 000 × $5 = $0,06.
- Выход: 1 500 ÷ 1 000 000 × $30 = $0,045.
Итого $0,105 за один запрос, или 10,5 цента. Тысяча запросов с таким же расходом обойдётся в $105. Здесь весь вход посчитан по обычной ставке, без кэширования и дополнительных платных инструментов.
Этот расчёт относится к API. Подписка ChatGPT оплачивается отдельно: стоимость каждого сообщения в обычном чате по такой формуле не списывается, а использование API в подписку Plus не входит.
Что меняется при работе через API
API позволяет подключить модель к боту, сайту или внутреннему сервису. Здесь расход приходится контролировать уже на уровне приложения: сохранять статистику запросов, задавать предел генерации и оценивать стоимость типичных задач.
Например, для бота, который отвечает по базе знаний, полезно измерить расход на короткий вопрос, длинную переписку и обращение с большим документом. Затем можно оценить бюджет на ожидаемое число пользователей. Так оценка будет учитывать разницу между обращениями пользователей.
Для повторяющихся запросов у некоторых провайдеров есть кэширование: модель повторно использует результаты обработки совпадающего начала запроса. Это может снизить стоимость входа и задержку. Однако кэшированный текст продолжает занимать место в контексте, а условия применения и оплаты зависят от модели и провайдера.
Поэтому при разработке ИИ-сервиса важно проверять три вещи вместе: подходит ли ответ для задачи, помещаются ли данные в контекст и сколько стоит типичный сценарий использования.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Можно ли пользоваться нейросетью бесплатно и без токенов
Бесплатный доступ не означает, что модель перестаёт использовать токены. Просто сервис предоставляет часть работы за свой счёт и ограничивает её по своим правилам: например, числом сообщений или доступом к отдельным функциям.
Платная подписка на чат тоже не обязательно означает покупку конкретного количества токенов. У подписки, API и агрегатора могут быть разные способы оплаты. Внутренние кредиты сервиса не стоит автоматически приравнивать к токенам модели: коэффициенты и правила списания устанавливает сам сервис.
Перед оплатой уточни, что именно продаётся: пополнение баланса API, пакет кредитов приложения или подписка на чат. Затем проверь доступные модели, ограничения и правила списания. Сравнивать только число кредитов в двух тарифах недостаточно.
При локальном запуске языковой модели токенизация тоже сохраняется. Платы провайдеру за каждый запрос может не быть, но вычисления выполняет твоё оборудование.
Как уменьшить расход и сохранить полезный ответ
Начать стоит с самого запроса. Если модели нужна одна таблица, передай её с пояснениями вместо большого документа с десятками ненужных страниц. Если нужен ответ на один вопрос, укажи желаемый формат и объём.
Для повседневной работы помогают несколько приёмов:
- Передавай относящиеся к задаче фрагменты вместе с необходимым контекстом.
- Убирай дубли, повторяющиеся инструкции и технический мусор из исходных материалов.
- Задавай объём ответа: например, «пять вариантов заголовка без пояснений».
- Для новой независимой задачи начинай отдельный диалог. Для продолжения старой сохраняй нужные вводные.
- В приложении через API проверяй статистику расхода и возможности кэширования.
Сокращать запрос до потери смысла невыгодно. Если убрать критерии, ограничения и важные данные, ответ придётся исправлять новыми запросами. Полезнее сравнить несколько вариантов задания по качеству результата и общему расходу на готовую работу.
FAQ
Универсального числа нет. Оно зависит от языка, текста и токенизатора. Точнее вставить сам материал в счётчик выбранной модели.
Одного числа для всего ChatGPT нет. Размер контекста зависит от доступной модели и режима работы. Отдельно действуют ограничения сервиса на использование. Лимит сообщений и размер контекста описывают разные ограничения.
Словарь может включать десятки или сотни тысяч токенов; конкретный размер зависит от модели. Он показывает, какие токены доступны токенизатору. Контекстное окно показывает, сколько токенов модель может обработать в одном запросе. Это разные характеристики.
Этот показатель описывает темп генерации. Он помогает оценить, насколько быстро появляется ответ, но сам по себе ничего не говорит о его правильности. Время до первого фрагмента ответа и дальнейшая скорость генерации тоже могут различаться.