Галлюцинации нейросети — это ответы, в которых модель сообщает ложные сведения, придумывает факты или использует несуществующие источники, сохраняя при этом убедительную форму изложения. Проблема встречается у больших языковых моделей (LLM), поисковых ИИ-ассистентов и других систем генеративного искусственного интеллекта.
Галлюцинации искусственного интеллекта возникают из-за особенностей обучения и генерации текста. Снизить их частоту можно с помощью правильных промптов, внешних источников данных и автоматической проверки результатов, но полностью исключить такие ошибки пока не удаётся.
Что означает галлюцинация в контексте ИИ
Термин hallucination пришёл в машинное обучение из английского языка. В 2018 году исследователи Google описали галлюцинации в нейросетевом машинном переводе, и с тех пор термин закрепился за ошибками генеративных моделей.
Для оценки таких ошибок полезно разделять два понятия. Фактическая достоверность показывает, соответствует ли ответ реальности. Согласованность с контекстом характеризует, следует ли он предоставленным документам и условиям задачи. Утверждение может быть верным в общем случае, но считаться галлюцинацией относительно источника, если в нём написано другое.
Основные виды галлюцинаций
В работе с языковыми моделями встречаются несколько типов ошибок:
- Фактические. Неверные даты, характеристики продуктов, имена, статистика или технические параметры. Например, модель указывает неправильную версию библиотеки.
- Логические. Противоречия внутри ответа, ошибочные выводы из верных посылок, некорректные вычисления.
- Библиографические. Несуществующие статьи, судебные решения, авторы, DOI и URL. Иногда реальный источник существует, но приписанные ему выводы выдуманы.
- Контекстные. Ответ противоречит предоставленному документу, игнорирует ограничения или подменяет условия задачи.
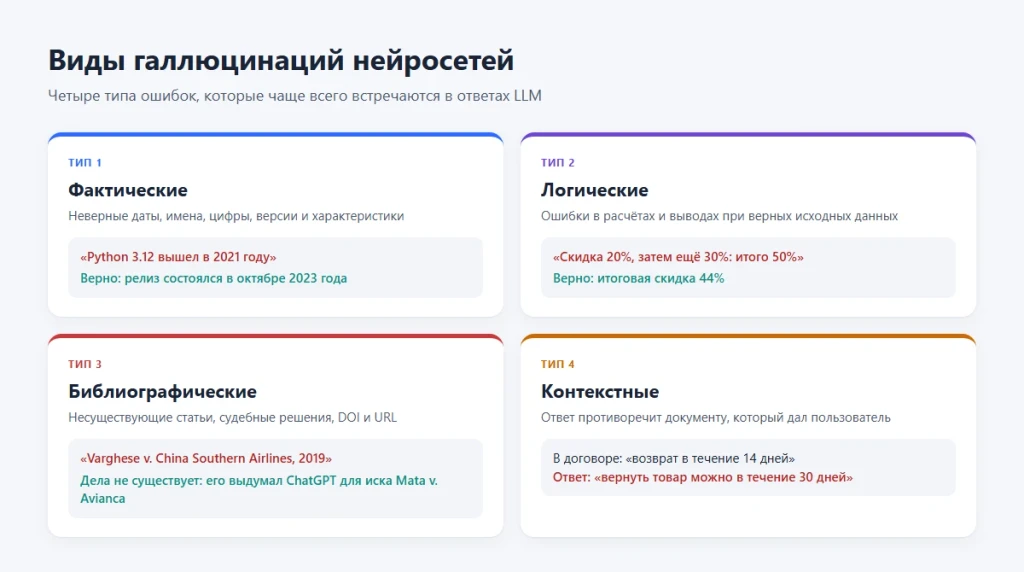
Один ответ может одновременно содержать несколько ошибок, например неверную дату и ссылку на несуществующее исследование.
Почему большие языковые модели генерируют ложные ответы
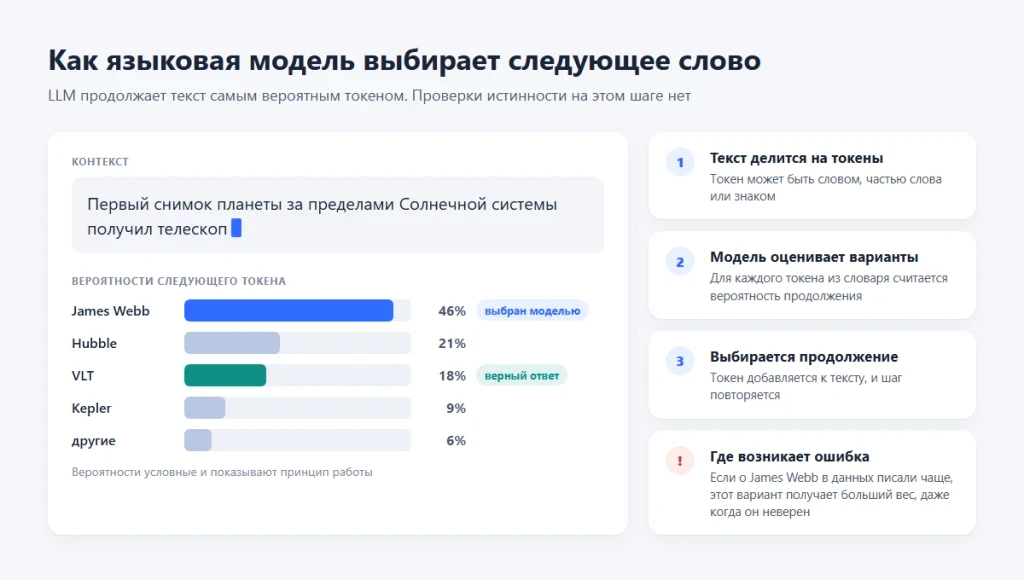
Предсказание следующего токена
Большая языковая модель генерирует текст последовательно. На каждом шаге она оценивает вероятности возможных следующих токенов с учётом предыдущего текста, системных инструкций и доступного контекста. Токеном может быть слово, часть слова или другой фрагмент текста.
Во время предобучения модель учится воспроизводить закономерности языка на больших массивах данных. Она усваивает факты, связи между понятиями и особенности формулировок. Но задача предсказания продолжения текста сама по себе не требует доказательства истинности каждого утверждения.
Если запрос касается редкого события или неизвестной модели устройства, LLM может построить ответ по знакомым шаблонам. В результате получается правдоподобное описание, в котором отдельные детали не соответствуют реальности.
Ошибки и противоречия в обучающих данных
Обучающие корпуса содержат устаревшие публикации, неточности, дубли и противоречивые сведения. Одно событие может описываться несколькими источниками с разными датами или характеристиками. Модель запоминает, какие формулировки встречаются чаще, а способа выяснить, какая из версий верна, у неё нет.
Проблема проявляется и при недостатке примеров. Редкие имена, узкоспециализированные термины и малоизвестные документы сложнее воспроизводить надёжно. Если редкая фамилия или узкий термин встречались в данных всего несколько раз, модель часто смешивает их с похожими и выдаёт неверную комбинацию.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Ограничения знаний и актуальности
Модель знает только то, что было в обучающих данных до даты отсечения знаний. О более поздних событиях она может только догадываться.
Поэтому LLM может перепутать действующие тарифы, версии API, законодательные требования или характеристики оборудования. Дата отсечения подсказывает, о каких событиях модель знать не может, однако и в ответах о более ранних событиях она тоже ошибается.
Поиск в интернете, подключение базы документов или передача актуальных данных позволяют дополнить знания модели. Но даже со свежим источником модель может взять из него не тот фрагмент или неверно его пересказать.
Температура и сэмплирование
При генерации модель может выбирать токены разными способами. В частности, температура регулирует распределение вероятностей: при её повышении выбор обычно становится разнообразнее, при снижении более предсказуемым.
При высокой температуре модель чаще выбирает маловероятные токены, и случайных ошибок становится больше. Но низкая температура не устраняет галлюцинации. Модель может стабильно выдавать одно и то же ложное утверждение, если оно соответствует её наиболее вероятному продолжению.
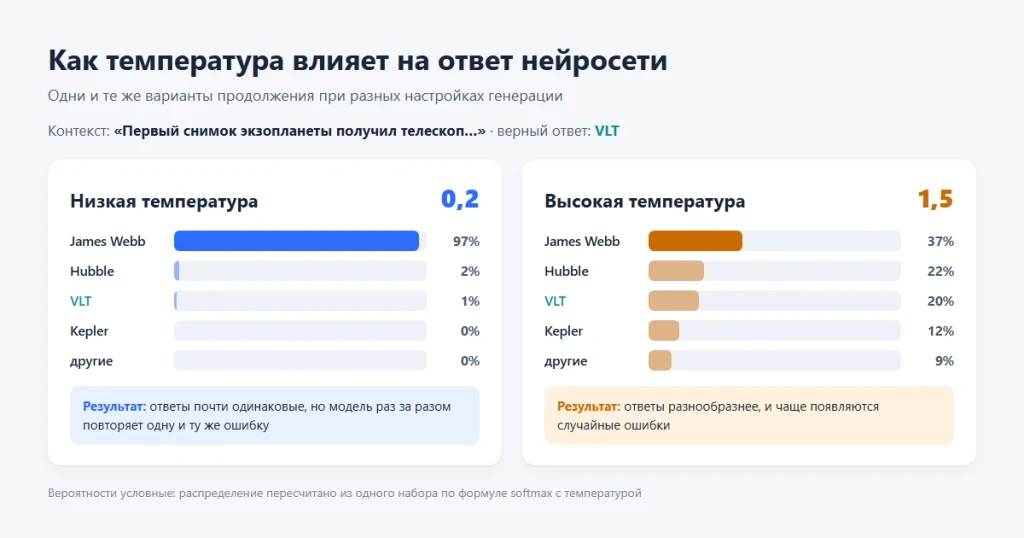
На результат также влияют другие параметры декодирования, включая top-p и ограничения длины.
Обучение на предпочтениях и оценка качества
После предобучения модели обычно проходят дополнительную настройку, в том числе с использованием примеров ответов и человеческих предпочтений. Такие методы помогают соблюдать инструкции и делать ответы полезнее.
Однако возникает проблема: если при обучении и оценке правильный ответ ожидается даже на вопрос без достаточных данных, угадывание может получать преимущество перед отказом. Модель воспроизводит этот сценарий и в реальных задачах.
Это объясняет, почему одна инструкция «отвечай точно» редко решает проблему. Для снижения частоты ошибок нужны изменения не только в промптах, но и в подходах к обучению и проверке моделей. Уверенная ошибка должна стоить модели больше, чем честный отказ от ответа.
Как бороться с галлюцинациями: методы для пользователей
Хороший промпт сокращает число неподтверждённых утверждений и упрощает их проверку.
Как составить промпт, чтобы нейросеть не врала
Запрос должен определять источники, допустимые выводы и поведение при нехватке информации. Особенно полезны такие условия, как запрет на выдуманные ссылки и разделение фактов с предположениями.
Готовый промпт для работы с документами:
Ответь на вопрос, используя только предоставленный контекст.
- Не добавляй факты, которых нет в источнике. Не придумывай цитаты, ссылки, имена и числа.
- Если информации недостаточно, противоречива или вопрос выходит за пределы контекста, прямо напиши «Не знаю» или укажи, каких данных не хватает.
- Для каждого существенного фактического утверждения укажи подтверждающий фрагмент или раздел исходного документа. Не создавай ссылки на отсутствующие материалы.
- Разделяй подтверждённые факты и предположения. Если делаешь вывод, обозначь его отдельно и объясни, на каких данных он основан.
- Не исправляй противоречия в источнике самостоятельно. Укажи на них.
Даже с таким промптом модель иногда неверно цитирует документ, пропускает оговорку или выдаёт свой вывод за подтверждённый факт.
Курс «Практикум по нейросетям» в Академии IT DMS
Цифровой сертификат после итогового теста.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Приёмы для повседневной работы
Для задач, в которых важна точность, полезны следующие правила:
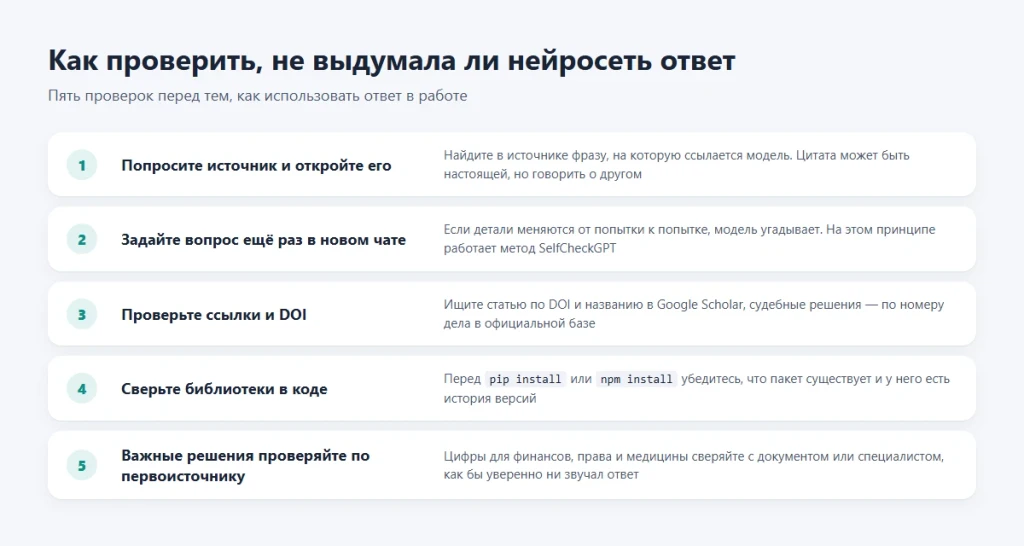
- Разбивайте сложные запросы. Сначала извлекайте факты из источника, затем просите выполнить анализ. Так проще определить, на каком этапе возникла ошибка.
- Запрашивайте подтверждения. Просите привести цитату, номер страницы или название раздела. Для внешних сведений требуйте проверяемые первоисточники.
- Ограничивайте область ответа. Вместо просьбы написать всё об инструменте задавайте конкретные вопросы о версии, методе или характеристике.
- Проверяйте спорные утверждения отдельно. Не просите ту же модель просто подтвердить собственный ответ. Используйте независимые источники, документацию и расчёты.
В творческих задачах разброс вариантов полезен. В финансовых расчётах, юридических документах и технических инструкциях лучше короткий ответ, который можно проверить.
Как разработчикам снижать риск галлюцинаций LLM
В продукте на базе LLM галлюцинации снижают в трёх местах: в данных, которые получает модель, в настройках генерации и в проверке готового ответа.
RAG и привязка к источникам
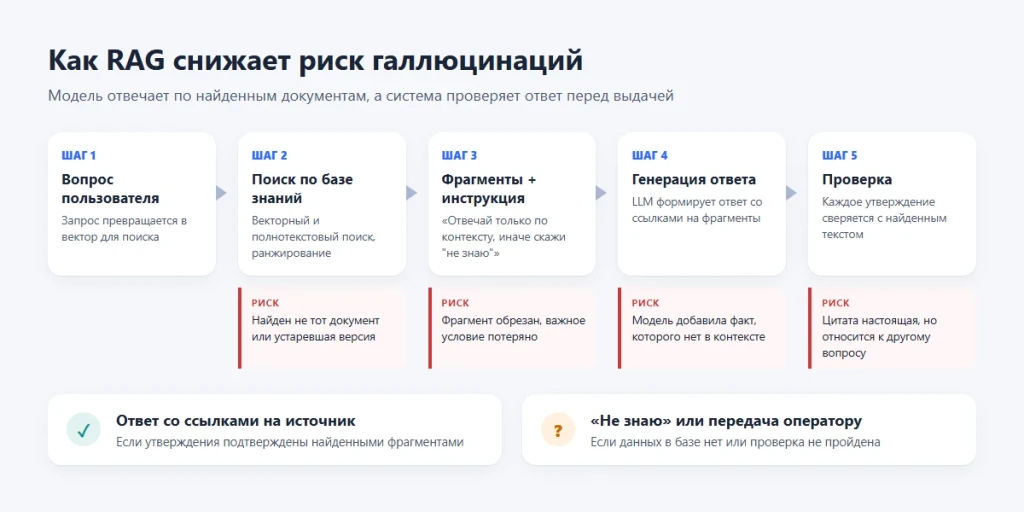
RAG (Retrieval-Augmented Generation) дополняет генерацию поиском по внешним документам. Перед ответом система извлекает релевантные фрагменты из базы знаний и передаёт их языковой модели.
Для RAG важны качество индексации, разбиение документов на фрагменты, метаданные и ранжирование результатов. Если поиск вернул не тот документ или пропустил существенное условие, генерация тоже может оказаться ошибочной.
Grounding предполагает привязку ответа к определённым данным или источникам. На практике для этого задают требования к цитированию, проверяют соответствие утверждений найденным фрагментам и предусматривают отказ от ответа при недостатке информации.
Чтобы отличать ошибки, которые исправляются настройкой поиска, от ошибок самой модели, полезно знать, как устроены и обучаются нейросети.
Причина ошибки и технический метод снижения риска
| Причина | Метод снижения риска |
| Устаревшие сведения | Поиск по актуальной документации, обновление базы |
| Недостаток контекста | RAG, уточнение запроса, отказ при нехватке данных |
| Случайные ошибки генерации | Настройка температуры и декодирования |
| Необоснованные выводы | Fine-tuning, примеры корректного отказа |
| Ошибочные ссылки | Проверка URL, DOI и библиографических записей |
| Нарушение ограничений задачи | Валидация ответа, структурированный формат |
Fine-tuning и настройка генерации
Fine-tuning позволяет адаптировать модель под определённый домен, формат ответов и правила работы. В обучающие примеры можно включать ситуации, в которых корректное поведение состоит в отказе от неподтверждённого ответа.
В узкой задаче ответы после дообучения становятся предсказуемее, а новых фактов модель таким способом почти не усваивает.
Снижение температуры помогает сделать ответы более стабильными. Для задач с однозначным результатом можно также ограничить формат генерации, например разрешить только значения из заданного списка или JSON с проверяемой схемой.
Автоматическая верификация и ограничение домена
Проверка результата должна учитывать тип задачи. Для арифметики можно использовать вычислительный инструмент, для программного кода тесты и исполнение в изолированной среде, для поиска фактов сопоставление с документами.
Проверка наличия цитаты в тексте ещё не доказывает, что она подтверждает конкретный вывод. Поэтому системы контроля должны оценивать связь между утверждением и источником, а при необходимости передавать спорные ответы специалисту.
Дополнительную защиту даёт ограничение домена. Например, корпоративный ассистент может отвечать только по утверждённой документации, а вопросы вне базы направлять оператору. Неподтверждённых ответов в таком режиме меньше, но ошибки поиска по базе остаются.
Как связать поиск по базе, ограничения формата и проверку ответов в одном продукте, разбирают в программах по генеративному ИИ, RAG и промпт-инжинирингу.
Как оценивать частоту галлюцинаций
Для сравнения моделей используют специальные тесты и бенчмарки. Например, Vectara публикует Hallucination Leaderboard, который оценивает склонность моделей к неподтверждённым утверждениям при пересказе документов.
Результаты таких тестов нельзя трактовать как универсальный процент ошибок любой нейросети в реальной работе. На показатели влияют тип исходных текстов, длина ответа, метод оценки и конкретная версия модели. Модель, хорошо справляющаяся с пересказом, может хуже работать с юридическими вопросами или сложными вычислениями.
При выборе LLM для продукта лучше проводить собственное тестирование на характерных запросах. В набор стоит включить вопросы с известным ответом, противоречивые документы и случаи, когда данных недостаточно. Отдельно следует измерять долю фактических ошибок и способность системы отказаться от ответа.
Если от утверждения зависит решение, которое трудно отменить, проверяйте его по первоисточнику, как бы уверенно ни звучал ответ.
FAQ
Не обязательно. В апреле 2025 года OpenAI опубликовала системную карточку моделей o3 и o4-mini. В тесте PersonQA с вопросами о людях o3 ошибалась в 33% ответов, o4-mini — в 48%, а предыдущая модель o1 — в 16%. Рассуждающая модель делает в одном ответе больше утверждений, поэтому среди них больше и верных, и ложных.
Поиск даёт модели свежие данные, но в источниках она по-прежнему может ошибаться. Ссылку из ответа стоит открыть и проверить важную информацию.
Да. Самая опасная форма таких ошибок — выдуманные библиотеки. Злоумышленник может зарегистрировать такое имя в npm или PyPI и выложить под ним вредоносный код. Эту схему называют slopsquatting. Прежде чем ставить зависимость из ответа нейросети, проверьте, что пакет существует, у него есть история версий и живой репозиторий.
Задайте тот же вопрос несколько раз в новых чатах. Если модель знает факт, ответы совпадут. Если она угадывает, детали будут меняться от попытки к попытке. На этом принципе построен метод SelfCheckGPT.
Это поведение называют угодливостью (sycophancy). При обучении на оценках людей ответы, которые совпадают с мнением собеседника, получают более высокие баллы, и модель учится под него подстраиваться.