Большие нейросети требуют много оперативной памяти и мощного оборудования. Поэтому разработчики используют квантование — технологию, которая уменьшает размер моделей и позволяет запускать их на более доступных компьютерах. Разберём, как она работает, чем отличаются 4-bit и 8-bit и как самостоятельно попробовать квантованную LLM.
Что такое квантование моделей простыми словами
Квантование, или квантизация (Quantization), — это способ уменьшить размер нейросети за счёт менее точного хранения её числовых параметров. Благодаря этому модель может занимать меньше оперативной памяти и памяти видеокарты.
Чтобы понять принцип, представьте фотографию. У неё есть оригинал в высоком качестве, который занимает много места, и сжатая версия. Вторую проще хранить и передавать, хотя некоторые мелкие детали изображения могут потеряться.
С нейросетями идея такая же. Внутри модели находятся миллионы или миллиарды чисел, которые влияют на её работу. Эти числа называют весами. Если хранить их с меньшей точностью, модель станет компактнее. При этом часть информации потеряется, поэтому ответы квантованной версии могут немного отличаться от оригинала.
Например, нейросеть с семью миллиардами параметров в одном формате может занимать около 14 ГБ, а после квантования — примерно 4–5 ГБ. Для пользователя это заметная разница: более компактная версия может запуститься там, где исходной модели не хватило бы памяти.
Квантование особенно полезно при локальном запуске LLM — больших языковых моделей, которые генерируют тексты, отвечают на вопросы и помогают работать с документами. С его помощью можно уменьшить требования к компьютеру без необходимости обучать новую нейросеть с нуля.
Как квантование уменьшает размер модели
Для хранения чисел компьютер использует биты. Чем больше бит выделено на значение, тем подробнее можно его представить, но тем больше памяти оно занимает.
В нейросетях встречаются разные форматы хранения весов. Например, FP16 использует 16 бит на число, а INT8 — 8 бит. При четырёхбитном представлении данных требуется ещё меньше места.
Посмотрим на условную модель с семью миллиардами параметров, или 7B. Буква B означает billion — миллиард.
| Формат весов | Сколько памяти занимают 7 млрд весов |
| FP16 (16 бит) | 14 ГБ |
| INT8 (8 бит) | 7 ГБ |
| INT4 (4 бита) | 3,5 ГБ |
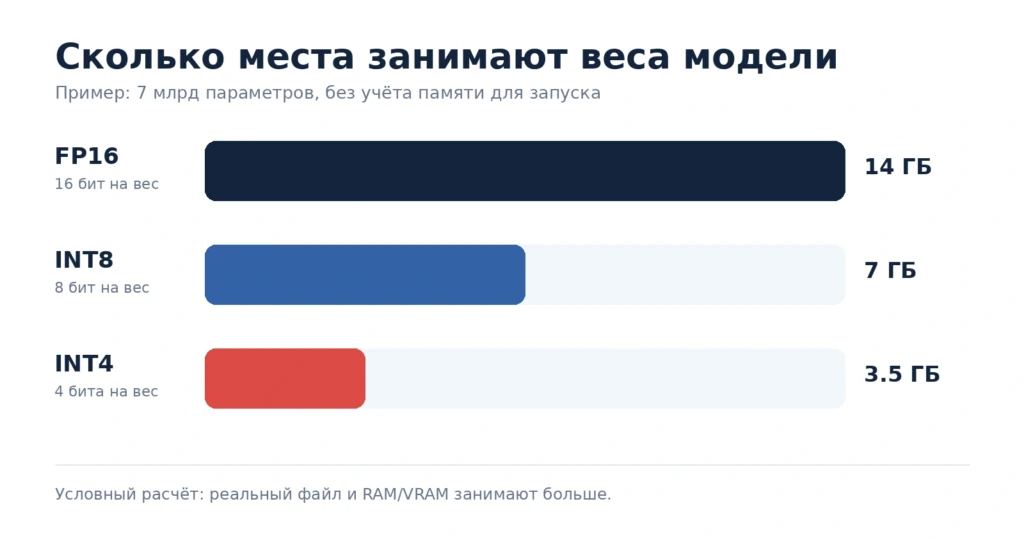
Это расчёт только для весов модели без дополнительных данных. В настоящих квантованных файлах также хранится информация, необходимая для восстановления числовых значений, а некоторые параметры могут оставаться в более высокой точности.
Поэтому четырёхбитная модель на 7B обычно не занимает ровно 3,5 ГБ. Её фактический размер зависит от выбранного способа квантования.
Снижение точности также не означает, что параметры модели просто округляют до целых чисел. Алгоритмы используют специальные правила преобразования, которые помогают сохранить важную информацию при меньшем объёме данных.
Зачем это нужно на практике
Допустим, вы хотите запустить языковую модель на собственном ноутбуке. Исходной версии требуется больше памяти, чем доступно устройству, поэтому программа не может её загрузить или работает слишком медленно.
Квантованная версия той же модели занимает меньше места. За счёт этого её иногда удаётся запустить без покупки новой видеокарты или аренды мощного облачного сервера.
Такая возможность интересна не только разработчикам. Например, локальную LLM можно использовать для подготовки черновиков текстов, обработки отзывов, классификации обращений и работы с документами.
При этом квантование не добавляет нейросети новых знаний. Если исходная модель плохо справляется с определённой задачей, уменьшение размера не исправит эту проблему.
Что означают 4-bit, 8-bit, GGUF и Q4_K_M
При поиске моделей для локального запуска часто встречаются обозначения Q4_K_M, Q5_K_M и Q8_0. На первый взгляд они выглядят сложно, но для первого знакомства достаточно понять несколько различий.
4-bit и 8-bit говорят о точности представления данных. Четырёхбитная версия обычно компактнее восьмибитной, поскольку для хранения весов используется меньше информации.
Но у этого преимущества есть обратная сторона: чем сильнее сжата модель, тем выше риск потерять часть качества. Особенно это может проявляться при сложных вычислениях, программировании и выполнении длинных инструкций.
В моделях, подготовленных для llama.cpp, можно встретить такие обозначения:
| Обозначение | Что означает | Когда выбирать |
| Q4_K_M | Компактный вариант квантования, в основном около 4 бит на вес | Когда нужно уменьшить требования к памяти |
| Q5_K_M | Более точное представление, обычно с большим размером файла | Когда есть дополнительный запас памяти |
| Q8_0 | Вариант примерно с 8 битами на вес | Когда хочется сохранить результат ближе к исходной модели |
Для первого эксперимента обычно удобно начать с Q4_K_M. Если компьютер позволяет, можно попробовать Q8_0 и сравнить ответы.
Однако более точный формат не гарантирует, что модель будет лучше выполнять абсолютно каждое задание. Результат зависит от исходной нейросети, алгоритма квантования и самой задачи.
Что такое GGUF
GGUF — это формат файла, в котором можно хранить модель и информацию, необходимую для её запуска. Он используется в llama.cpp, LM Studio и других программах для работы с локальными нейросетями.
Здесь легко запутаться, потому что GGUF и Q4_K_M часто встречаются в одном названии. GGUF обозначает формат файла, а Q4_K_M — способ представления весов внутри него. Поэтому можно скачать одну модель в формате GGUF, но выбрать разные варианты квантования.
Например, файлы Qwen3-4B-Q4_K_M.gguf и Qwen3-4B-Q8_0.gguf содержат версии одной модели Qwen3-4B. Первый компактнее, а второй хранит веса с более высокой точностью.
Какую квантованную модель выбрать для компьютера
При выборе лучше учитывать не только количество бит, но и размер самой нейросети. Модель с 14 миллиардами параметров даже после сильного квантования может требовать больше памяти, чем модель на 4 миллиарда параметров с высокой точностью.
Для первого знакомства можно попробовать модель Qwen3-4B. У неё есть несколько версий в GGUF, которые удобно сравнивать между собой.
В репозитории LM Studio Community на Hugging Face опубликованы, в частности, такие файлы:
| Версия Qwen3-4B | Размер файла |
| Q4_K_M | 2,50 ГБ |
| Q6_K | 3,31 ГБ |
| Q8_0 | 4,28 ГБ |
Это реальные размеры файлов конкретной модели, а не приблизительные расчёты. Разница между Q4_K_M и Q8_0 составляет 1,78 ГБ.
Посмотреть все версии можно в репозитории Qwen3-4B-GGUF на Hugging Face.
Но размер скачиваемого файла не равен всей памяти, которая потребуется программе. Во время работы нейросеть использует дополнительные ресурсы для обработки запросов. Особенно это заметно при длинных разговорах и больших документах.
Поэтому при выборе стоит оставлять запас RAM или VRAM. Если подходящая модель не помещается в память, лучше начать с меньшего числа параметров или более компактного варианта квантования.
Ещё один важный момент — совместимость. Не все форматы одинаково хорошо работают на разных процессорах и видеокартах. Поэтому перед скачиванием стоит проверить требования программы, в которой вы собираетесь запускать модель.
Как запустить квантованную модель в LM Studio
Для первого эксперимента можно обойтись без Python и сложных команд. Возьмём LM Studio — программу, которая позволяет скачивать и запускать языковые модели на собственном компьютере.
В ней есть каталог моделей и обычный чат. Вы выбираете подходящую нейросеть, загружаете её и можете общаться с ней без отдельного облачного API.
Для примера используем Qwen3-4B. У неё есть обе версии, которые нам нужны для сравнения: Q4_K_M и Q8_0.
Установите LM Studio
Перейдите на официальный сайт, скачайте программу для своей операционной системы и установите её. LM Studio поддерживает Windows, macOS и Linux, но требования к оборудованию зависят от платформы.
После запуска найдите раздел Discover, предназначенный для поиска моделей. В актуальной ветке LM Studio 0.4 поиск также можно открыть через значок лупы. Некоторые элементы интерфейса могут отличаться между версиями.
Для первого теста желательно закрыть ресурсоёмкие приложения, особенно если у компьютера немного оперативной памяти.
Найдите Qwen3-4B
Откройте поиск моделей и введите:
lmstudio-community/Qwen3-4B-GGUFНайдите модель с этим названием и откройте её карточку. Проверьте, что это именно версия с четырьмя миллиардами параметров, а не похожая модель с другим размером или настройкой обучения.
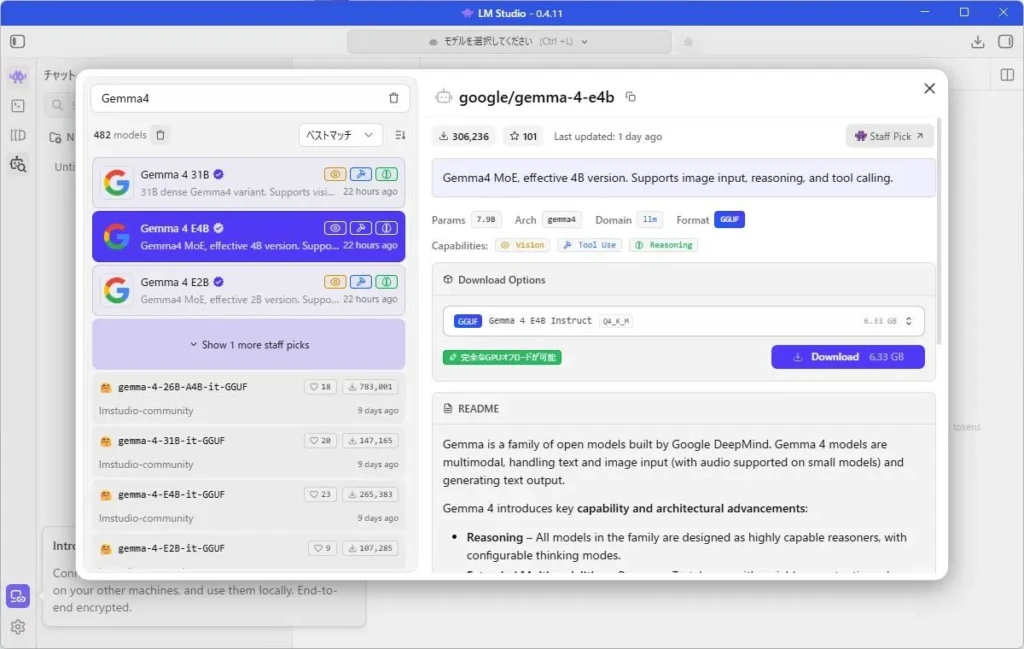
В списке доступных файлов найдите Q4_K_M. Её размер в указанном репозитории составляет 2,50 ГБ.
Скачайте эту версию. Если в вашей сборке LM Studio модель не находится по названию, можно вставить в поиск ссылку на её страницу в Hugging Face.
Загрузите модель и проверьте работу
После скачивания откройте раздел Chat. В меню выбора модели найдите Qwen3-4B Q4_K_M и загрузите её в память.
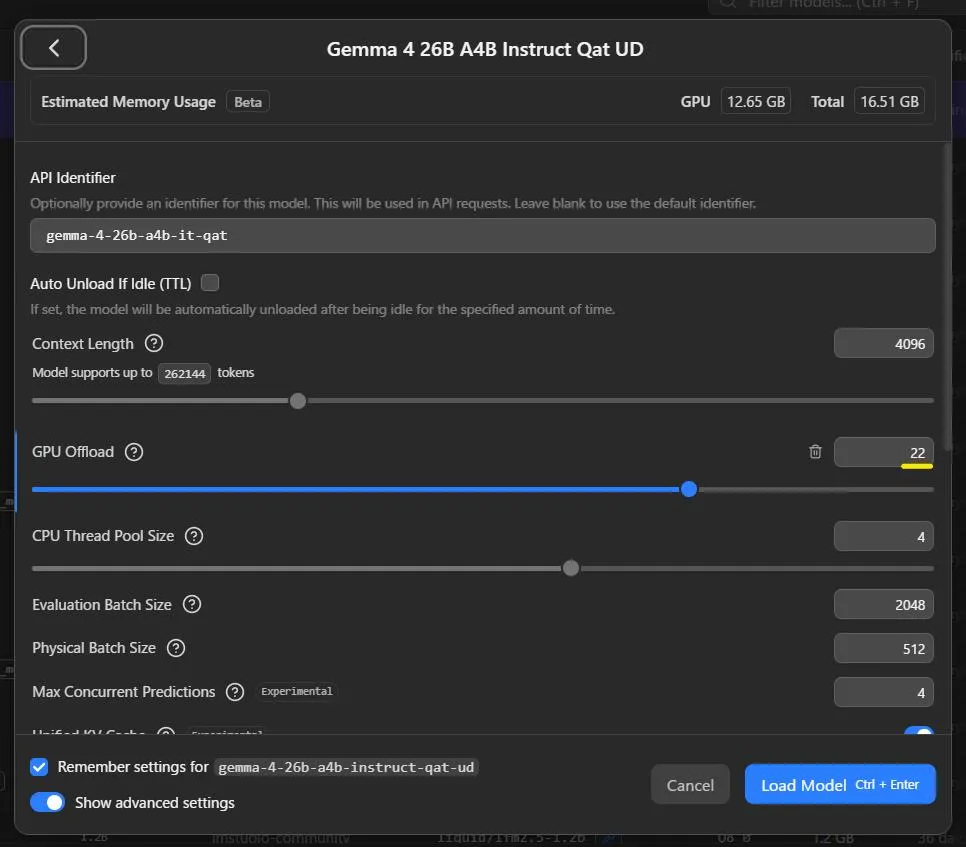
Если программа предлагает настройки запуска, для первого теста можно оставить стандартные параметры. После загрузки откроется возможность отправлять запросы модели.
Начните с простой задачи, результат которой легко проверить. Например:
Напиши три коротких заголовка для объявления о продаже беспроводных наушников. Не упоминай скидки, гарантию и бесплатную доставку. Не добавляй характеристики, которых нет в запросе.
Посмотрите, соблюдает ли модель ограничения и не придумывает ли особенности товара.
Этот тест покажет, что нейросеть успешно запущена и умеет обрабатывать инструкции. Но чтобы оценить влияние квантования, понадобится сравнение с другой версией той же модели.
Скачайте Q8_0 для сравнения
Вернитесь к карточке Qwen3-4B и найдите файл Q8_0 размером 4,28 ГБ. Если компьютер позволяет, скачайте его и загрузите вместо Q4_K_M.
Перед новым тестом откройте отдельный пустой чат. Повторите предыдущий запрос без изменений.
Для более корректного сравнения используйте одинаковые настройки генерации, включая температуру и длину контекста. Если доступна настройка температуры, для теста можно выбрать низкое значение, например 0, чтобы уменьшить случайные различия между ответами.
Теперь у вас есть два варианта одной нейросети, которые можно проверять на одинаковых заданиях.
Как понять, сильно ли квантование ухудшило модель
Один удачный ответ почти ничего не говорит о качестве. Лучше подготовить несколько заданий, в которых можно проверить правильность результата, соблюдение инструкций и скорость работы.
Например, маркетолог может сравнить две версии Qwen3-4B на задачах с рекламными данными.
Тест 1. Расчёт рекламных показателей
Скопируйте запрос:
Есть результаты двух рекламных каналов.
Поиск: расходы 36 000 рублей, 1200 кликов, 48 заявок.
Соцсети: расходы 72 000 рублей, 1600 кликов, 48 заявок.
Для каждого канала рассчитай CPC (стоимость клика), CR (конверсию из клика в заявку) и CPL (стоимость заявки).
Верни только JSON с двумя объектами: search и social. В каждом объекте должны быть поля cpc_rub, cr_percent и cpl_rub. Все значения должны быть числами. Не добавляй пояснений и не придумывай причины различий.
Для проверки используйте следующие правильные значения:
| Показатель | Поиск | Соцсети |
| CPC | 30 руб. | 45 руб. |
| CR | 4% | 3% |
| CPL | 750 руб. | 1500 руб. |
Сравните, правильно ли обе модели выполнили расчёты и сохранили заданный формат. Например, ответ с верными цифрами, но дополнительным текстом вместо чистого JSON не полностью соответствует инструкции.
Тест 2. Работа с рекламным текстом
Используйте один и тот же запрос:
Напиши объявление для онлайн-магазина, который продаёт настольные лампы. Известно только, что лампы доступны в белом и чёрном цветах.
Сделай заголовок до 40 символов и основной текст до 100 символов. Не упоминай скидки, доставку, гарантию, мощность, материалы и другие сведения, которых нет в описании.
Здесь стоит проверить не красоту текста на глаз, а конкретные требования: длину заголовка, размер основного текста и отсутствие выдуманных характеристик.
Можно добавить третье задание из своей реальной работы — например, классификацию нескольких отзывов или извлечение данных из документа. Только не используйте для первоначального теста конфиденциальные материалы клиентов.
Запишите результаты
После проверки сохраните ответы обеих версий и сравните их по нескольким критериям.
| Что сравнить | Q4_K_M | Q8_0 |
| Размер файла | 2,50 ГБ | 4,28 ГБ |
| Правильность расчётов | Заполнить после теста | Заполнить после теста |
| Соблюдение формата JSON | Заполнить после теста | Заполнить после теста |
| Соблюдение ограничений | Заполнить после теста | Заполнить после теста |
| Скорость генерации | Измерить | Измерить |
Для сравнения скорости используйте показатель токенов в секунду, если он доступен в вашей версии интерфейса, или замерьте время ответа. Первый запуск может дополнительно включать загрузку модели, поэтому его не стоит напрямую сравнивать с уже прогретой моделью.
Желательно повторить каждое задание несколько раз. Даже при одинаковых настройках ответы могут отличаться, поэтому один результат не даёт полной картины качества.
Если компактная модель справляется с вашими задачами примерно так же хорошо, как более тяжёлая версия, Q4_K_M может оказаться подходящим выбором. А если она чаще ошибается в вычислениях или нарушает инструкции, стоит рассмотреть вариант с более высокой точностью.
Какие бывают методы квантования моделей
Квантование можно выполнить разными способами. Для первого знакомства достаточно знать два основных подхода.
Post-Training Quantization (PTQ) — квантование после обучения. Сначала создают и обучают модель, а затем уменьшают точность хранения её параметров. Именно так подготавливают многие компактные версии уже существующих языковых моделей.
Quantization-Aware Training (QAT) — обучение с учётом будущего квантования. При таком подходе модель во время обучения или дополнительной настройки учитывает ошибки, которые возникнут после уменьшения точности.
Существуют и специальные методы для больших языковых моделей. Например, GPTQ и AWQ используют дополнительные способы подбора квантованных значений, чтобы сильнее сжать веса и сохранить качество.
Выбирать конкретный алгоритм обычному пользователю LM Studio чаще всего не требуется: разработчики уже подготовили файлы для скачивания. Но при самостоятельной оптимизации LLM эти различия становятся важными.
Отдельно можно встретить термин QLoRA. Так называют технологию, которая помогает экономить память при дополнительном обучении больших языковых моделей. Её используют для других задач, чем простое скачивание компактной GGUF-версии для чата.
Как загрузить модель в 4-bit на Python
Если вы хотите разрабатывать приложения на базе нейросетей, квантование можно использовать и через Python. Например, библиотека Hugging Face Transformers позволяет загружать совместимые модели с четырёхбитным представлением весов.
Для демонстрации возьмём небольшую OPT-350M. Она значительно меньше моделей на 7–8 миллиардов параметров, поэтому лучше подходит для первого знакомства.
В примере будем ориентироваться на компьютер с совместимой видеокартой NVIDIA и рабочей средой CUDA. Сначала необходимо установить подходящую версию PyTorch по инструкции на официальном сайте.
Затем установите необходимые библиотеки:
pip install -U transformers accelerate bitsandbytes

Создайте файл quantization_example.py:

import torch

from transformers import AutoModelForCausalLM, BitsAndBytesConfig

if not torch.cuda.is_available():

    raise RuntimeError(

        "Для этого примера нужна совместимая CUDA-видеокарта"

    )

config = BitsAndBytesConfig(

    load_in_4bit=True,

    bnb_4bit_quant_type="nf4"

)

model = AutoModelForCausalLM.from_pretrained(

    "facebook/opt-350m",

    quantization_config=config,

    device_map="auto",

    dtype="auto"

)

memory_mb = model.get_memory_footprint() / 1024**2

print(f"Память модели: {memory_mb:.1f} МиБ")
В этом примере load_in_4bit=True включает четырёхбитную загрузку, а nf4 задаёт способ представления весов. Библиотека bitsandbytes обрабатывает совместимые слои модели, а Transformers загружает их в доступную вычислительную среду.
После запуска программа должна вывести оценку объёма памяти, который учитывает сама библиотека для модели. Точное значение зависит от окружения, поэтому заранее подставлять в статью конкретное число неправильно.
Есть и важное различие: такой код не создаёт отдельный GGUF-файл и не сохраняет новую модель для LM Studio. Он демонстрирует загрузку весов с квантованием непосредственно в Python.
Если потребуется подготовить собственный GGUF-файл, для этого существуют отдельные инструменты, например llama-quantize из проекта llama.cpp.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Когда квантование не поможет
Квантование полезно, когда основная проблема связана с объёмом памяти. Но оно не решает все сложности, которые возникают при работе с нейросетями.
Например, если модель плохо понимает русский язык, не справляется со сложными инструкциями или постоянно ошибается в расчётах, уменьшение точности весов не улучшит её знания. В такой ситуации стоит попробовать другую модель или изменить подход к решению задачи.
Если вы хотите разобраться, как нейросети создают и обучают, у нас есть отдельный материал «Как сделать нейросеть: создать свой ИИ с нуля». Там рассматриваются разные способы разработки ИИ-приложений, включая использование готовых моделей.
Ещё одна распространённая ошибка — ориентироваться только на размер файла. Во время работы нейросеть хранит не одни лишь веса. Например, для обработки длинного разговора используется KV-кеш — промежуточные данные, объём которых может увеличиваться вместе с длиной контекста.
Если вы часто отправляете нейросети большие документы, полезно также разобраться, что такое токены в нейросети и как они связаны с контекстным окном.
Наконец, квантование не всегда ускоряет генерацию. На одном устройстве компактная модель может работать заметно быстрее, а на другом часть выигрыша потеряется из-за особенностей процессора и поддерживаемых вычислений.
Поэтому при выборе квантованной LLM стоит проверить четыре вещи: помещается ли она в память, насколько быстро отвечает, соблюдает ли инструкции и достаточно ли точны результаты. Если всё устраивает, более компактная версия может заметно упростить локальную работу с нейросетью.
FAQ
Квантование — это способ уменьшить размер нейросети за счёт хранения её числовых параметров с меньшей точностью. Это помогает снизить требования к памяти компьютера.
Основная цель — уменьшить расход памяти при запуске модели, сохранив приемлемое качество ответов. На подходящем оборудовании квантование также может ускорить работу.
Четырёхбитное квантование обычно сильнее уменьшает размер модели, но может приводить к большей потере точности. Восьмибитное требует больше памяти, зато чаще сохраняет результаты ближе к исходной версии.
Q4_K_M — вариант квантования весов модели, распространённый в экосистеме llama.cpp. Он позволяет уменьшить размер файла и часто используется для локального запуска LLM.
GGUF — это формат файла модели. Квантование — способ представления её параметров. Один GGUF-файл может содержать веса Q4_K_M, другой — Q8_0.
Да. Например, LM Studio позволяет скачать готовую квантованную LLM, загрузить её в память и общаться с ней через графический интерфейс.