Нейросети умеют работать не только с текстом, но и с фотографиями, аудио и видео. Например, можно загрузить скриншот рекламного отчёта и попросить ИИ посчитать стоимость заявки. Разберём, что такое мультимодальность, какие модели её поддерживают и как попробовать их возможности самостоятельно.
Что такое мультимодальные нейросети
Мультимодальная нейросеть — это модель искусственного интеллекта, которая может работать с несколькими видами данных. Например, получать текст и изображения, анализировать звуковую запись или отвечать на вопросы по видео.
Каждый вид информации называют модальностью. Если нейросеть умеет обрабатывать текст и фотографии, она уже мультимодальная. Ей необязательно поддерживать сразу все существующие форматы.
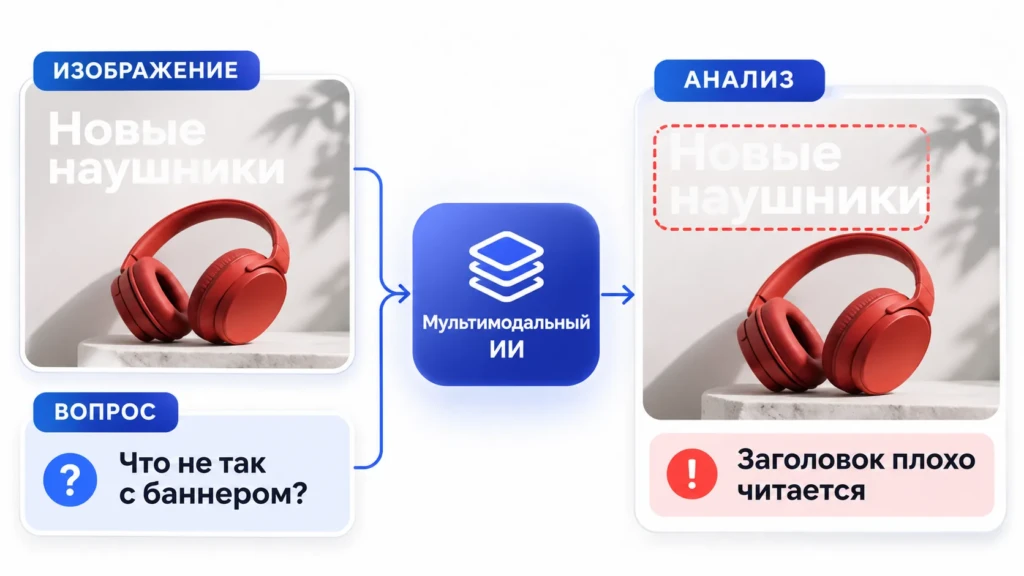
Допустим, вам нужно проверить рекламный баннер. В обычном текстовом чате пришлось бы подробно описывать изображение: какие цвета использованы, где находится кнопка, что написано на баннере. Мультимодальной модели можно просто отправить картинку и спросить: «Что здесь мешает прочитать предложение?».
Ещё один пример — отчёт из рекламного кабинета. Вместо ручного переноса данных в сообщение можно прикрепить скриншот и попросить нейросеть извлечь показатели, составить таблицу или выполнить расчёты.
При этом мультимодальность не означает, что модель обязательно генерирует изображения или видео. Она может получать картинку, а отвечать обычным текстом.
С какими данными работают мультимодальные модели
Основные виды информации, с которыми сталкивается пользователь, — текст, изображения, аудио и видео. Модель может принимать несколько таких типов данных в одном запросе, но конкретные возможности зависят от её версии.
| Данные | Что умеет делать ИИ | Пример |
| Текст | Читать, анализировать, создавать ответы | Разобрать условия оффера |
| Изображения | Распознавать объекты, текст и графики | Проверить рекламный баннер |
| Аудио | Распознавать речь и анализировать запись | Расшифровать интервью |
| Видео | Анализировать кадры и события | Разобрать рекламный ролик |
Например, мультимодальная модель может получить фотографию товара и текстовый вопрос о его внешнем виде. В другом случае — видеозапись и просьбу найти момент появления определённого объекта.
Документы PDF и DOCX сами по себе не являются отдельными модальностями. Это форматы файлов, которые могут содержать текст, изображения, таблицы и графики. Насколько хорошо нейросеть обработает такой документ, зависит от модели и сервиса.
Как работают мультимодальные нейросети
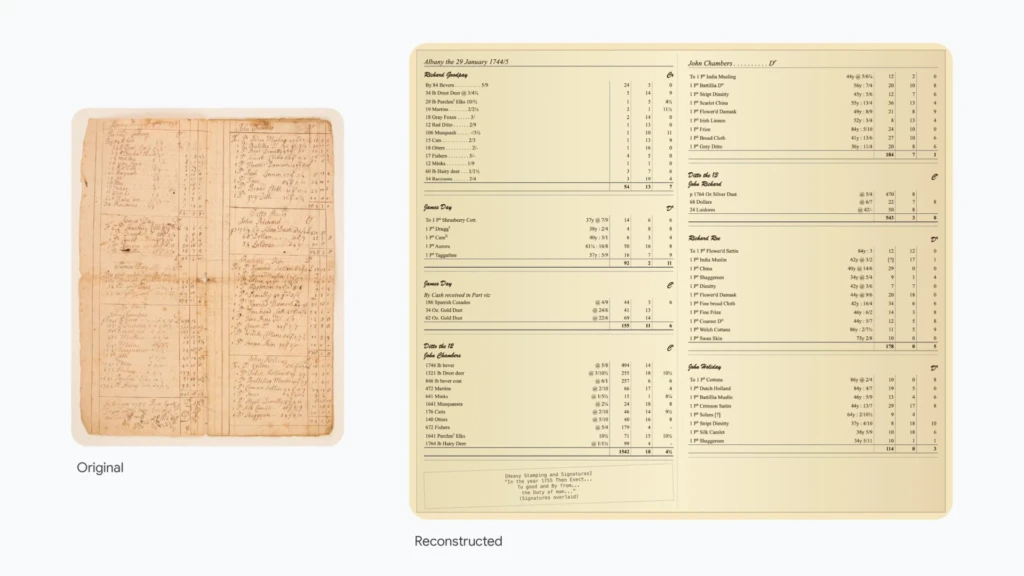
Нейросети обрабатывают информацию не так, как человек. Для работы им нужно преобразовать входные данные в числовую форму, с которой могут выполнять вычисления алгоритмы.
Например, текст разбивается на токены — небольшие фрагменты слов или символов. Изображение модель обрабатывает с помощью механизмов, позволяющих выделять из него визуальные признаки. Для звука и видео используются свои способы представления информации.
Затем модель учитывает обработанные данные при формировании ответа. Конкретное устройство может различаться: некоторые системы используют отдельные компоненты для разных модальностей, другие объединяют обработку более тесно.
Предположим, вы загружаете изображение рекламного отчёта и просите рассчитать CPL — стоимость заявки. Система должна прочитать названия каналов и цифры, понять вашу инструкцию, выполнить вычисления и подготовить ответ.
Проблема может возникнуть на любом этапе. Например, нейросеть перепутает столбцы с кликами и заявками, а затем правильно выполнит формулу с неправильными исходными числами. Поэтому при работе с отчётами полезно сначала проверять распознанные данные и только потом расчёты.
Чем мультимодальная LLM отличается от обычной
LLM (Large Language Model) — большая языковая модель. Такие модели используют для обработки и генерации текста: написания ответов, перевода, анализа документов и других задач.
Мультимодальная LLM дополнительно может получать информацию из изображений, аудио или других поддерживаемых видов данных.
Например, обычной текстовой модели нужно передать значения диаграммы словами. Мультимодальной можно отправить саму диаграмму и спросить, какой показатель вырос сильнее.
Важно: есть два понятия, которые часто путают — генеративность и мультимодальность.
- Генеративная модель создаёт новый контент: текст, изображения, аудио или видео.
- Мультимодальная модель работает с несколькими видами информации на входе или выходе.
Одна нейросеть может обладать обоими свойствами. Например, получать фотографию и создавать текстовое описание её содержимого.
Подробнее о создании контента с помощью ИИ читайте в нашем материале «Генеративный ИИ: что это и как работает».
Примеры мультимодальных нейросетей
Сегодня для работы с разными видами данных необязательно самостоятельно устанавливать и обучать модель. Многие возможности доступны в готовых приложениях.
ChatGPT
В ChatGPT можно прикрепить изображение и задать вопрос о его содержимом. Например, попросить описать фотографию, разобрать график или оценить читаемость рекламного баннера.
Сервис также поддерживает работу с документами, таблицами и аудиофайлами. Загрузка и анализ видео тоже доступны в поддерживаемых режимах, но обработка ролика может быть неполной. Конкретные возможности и лимиты зависят от аккаунта, платформы и выбранного режима.
Для первого знакомства с мультимодальным ИИ удобно начать именно с изображения. Не нужно настраивать API или писать код: достаточно прикрепить файл и объяснить, что требуется получить.
Google Gemini
Модели семейства Gemini работают с текстом, изображениями, аудио и видео. Например, можно попросить модель проанализировать ролик и перечислить основные события с указанием времени.
Это полезно при работе с рекламными креативами. Модель может помочь выделить сцены, найти момент появления продукта или подготовить описание ролика.
Но видеоанализ тоже имеет ограничения. В стандартном режиме Gemini использует выборку кадров, поэтому короткие события и быстрые переходы иногда остаются незамеченными. Для проверки важных деталей нужно возвращаться к исходному видео.
Qwen-VL
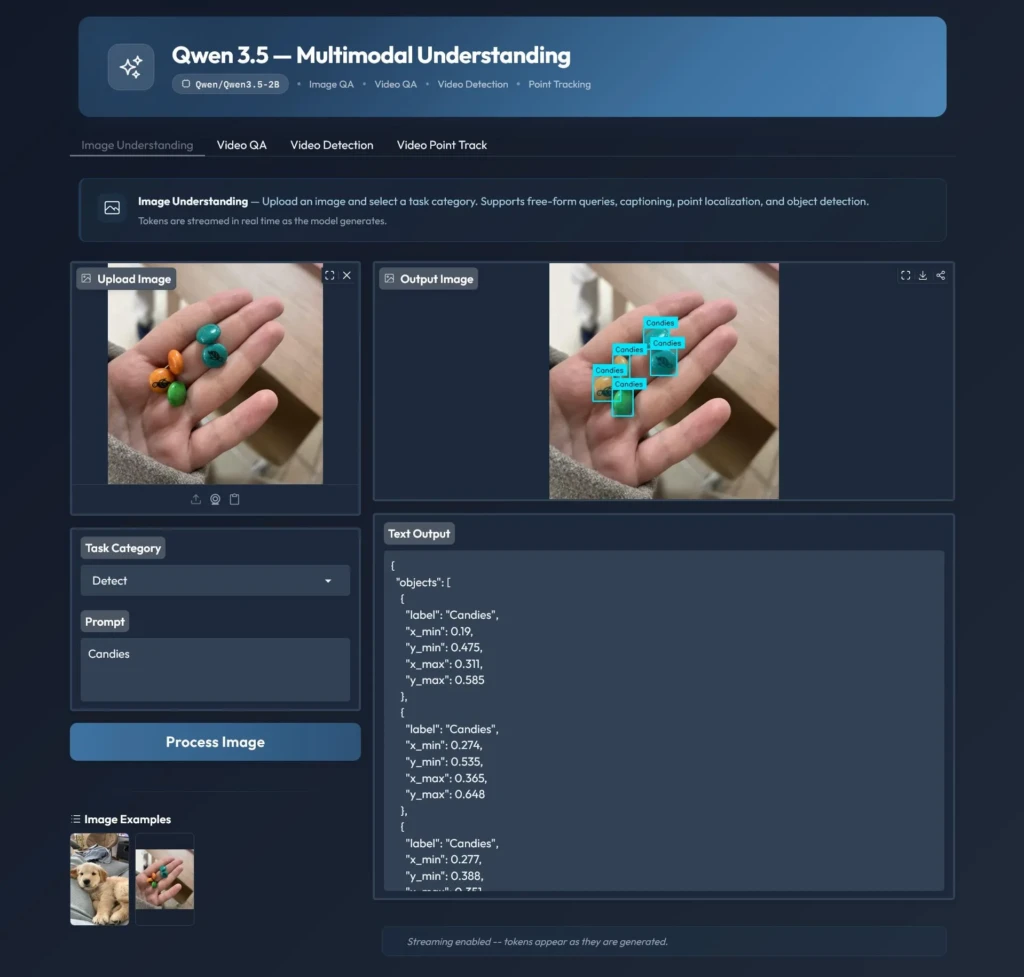
Qwen-VL — семейство моделей, предназначенных для работы с визуальной и текстовой информацией. Они могут отвечать на вопросы об изображениях, распознавать объекты и выполнять другие задачи.
Некоторые модели этого семейства доступны с открытыми весами. Разработчики могут запускать их самостоятельно, если оборудование и программная среда соответствуют требованиям выбранной версии.
Например, модель можно использовать в приложении, которое получает фотографию товара и помогает составить описание. Но качество результата нужно проверить на разных изображениях, а не на одной удачной фотографии.
Gemini Embedding 2
Есть и мультимодальные модели, которые не предназначены для обычной переписки.
22 апреля 2026 года Google объявила об общей доступности Gemini Embedding 2. Она преобразует разные виды информации, включая текст и изображения, в числовые представления, которые помогают искать похожие по смыслу материалы.
Например, пользователь вводит описание «чёрные кроссовки с белой подошвой», а система ищет подходящие фотографии товаров. Для этого не обязательно искать точное совпадение слов в названиях файлов.
Такие числовые представления называются эмбеддингами. Как они устроены и используются в поиске, мы объясняли в статье «Что такое эмбеддинг в нейросети».
Где мультимодальный ИИ полезен в работе
Мультимодальные модели особенно удобны, когда информация находится не в обычном тексте, а на изображениях, в записях разговоров или видеороликах.
Например, специалисту по рекламе может понадобиться сравнить несколько баннеров или быстро разобрать статистику. Редактору — подготовить расшифровку интервью, а маркетологу — найти интересные моменты в видеозаписи.
Для аудитории AffTimes можно выделить три понятных сценария.
| Задача | Что можно поручить нейросети |
| Проверка креативов | Описать баннер, найти плохо читаемый текст, сравнить варианты |
| Анализ отчёта | Извлечь числа со скриншота и подготовить расчёты |
| Разбор видео | Выделить сцены, описать действия и найти призыв к покупке |
Самый простой вариант для практики — работа со скриншотом. Для неё не нужно записывать видео, устанавливать специальные программы или писать код.
Как попробовать мультимодальную нейросеть на практике
Один из простых способов проверить мультимодальный ИИ — загрузить скриншот рекламного кабинета и попросить нейросеть разобраться в показателях. Например, сравнить несколько кампаний по стоимости клика, конверсии и стоимости заявки.
Для этого откройте отчёт в Google Ads, Яндекс Директе или другом рекламном кабинете. Сделайте скриншот таблицы, на котором видны расходы, клики и конверсии. Перед загрузкой в сторонний сервис скройте клиентские данные и другую конфиденциальную информацию.
Затем откройте ChatGPT или Gemini, прикрепите изображение и отправьте запрос:
Прочитай данные рекламного отчёта на изображении. Составь таблицу с расходами, кликами и заявками по каждой кампании. Рассчитай CPC, CR и CPL. Сначала покажи исходные значения, а затем результаты вычислений. Если какая-то цифра плохо читается, не придумывай её.
После ответа проверьте, правильно ли нейросеть перенесла значения из таблицы. Особенно внимательно посмотрите на числа и названия столбцов: модель может перепутать показатели или неправильно распознать мелкий текст.
Затем можно попросить ИИ сравнить кампании и указать, где стоимость заявки выше или ниже. Но выводы об окупаемости делать только по этим данным нельзя — для этого нужны сведения о продажах и выручке.
Курс «Практикум по нейросетям» в Академии IT DMS
Цифровой сертификат после итогового теста.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Как работать с аудио и видео
Мультимодальные нейросети можно использовать и с материалами, которые сложнее разобрать вручную.
Аудиозаписи
Допустим, вы записали интервью с экспертом и хотите подготовить текстовый материал. Сервис с поддержкой аудио может сделать расшифровку, выделить основные темы и помочь найти нужные фрагменты разговора.
Для начала достаточно загрузить запись и попросить:
Расшифруй разговор. Сохрани смысл ответов и отдельно выпиши основные тезисы эксперта. Если имя, число или термин неразборчивы, отметь это, а не придумывай.
После обработки сверьте с записью имена, даты, суммы и важные цитаты. Автоматическая расшифровка иногда ошибается, особенно если собеседники перебивают друг друга или на фоне есть шум.
Видеоролики
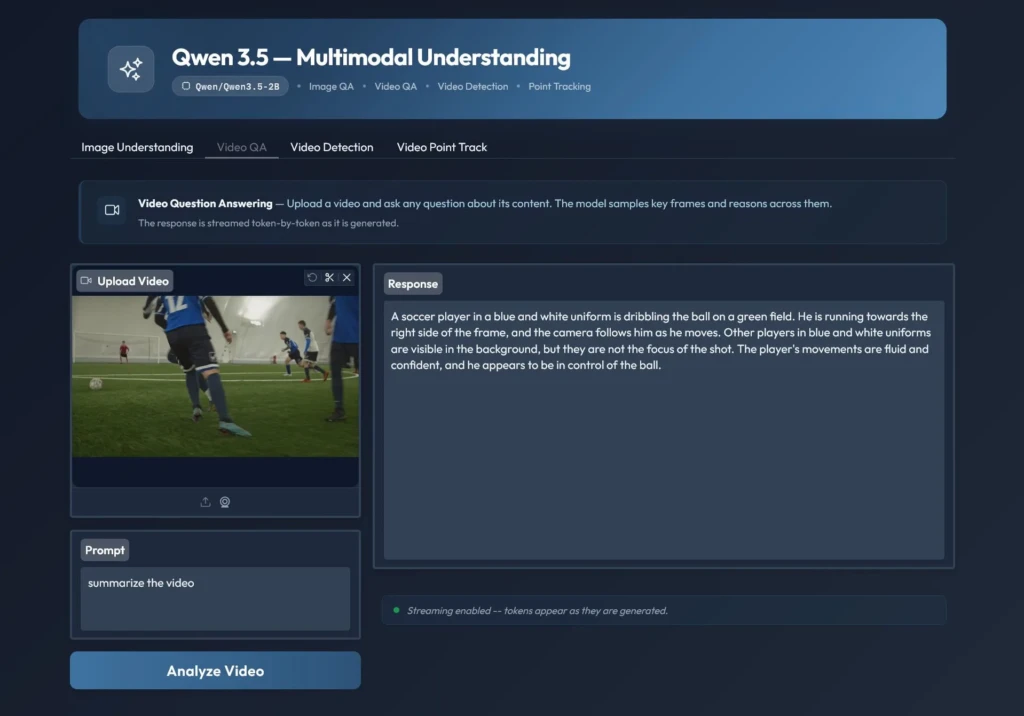
С видео можно работать похожим образом. Например, если вы анализируете рекламный ролик, попросите нейросеть описать первые секунды, появление продукта и финальный призыв к действию.
Пример запроса:
Разбери ролик по сценам. Укажи, что происходит в начале, когда появляется продукт и какой призыв к действию используется. Добавь временные отметки и не придумывай детали, которых нельзя разобрать.
Затем откройте исходный ролик и проверьте отмеченные моменты. Это особенно важно для быстрых переходов, коротких надписей и деталей звука.
Как подключить мультимодальную модель через Python
Готовые чаты подходят для разовых задач. Но если нужно встроить анализ изображений в свой сервис, можно использовать API — интерфейс, через который программа отправляет запрос модели и получает ответ.
Например, разработчик может сделать инструмент, который принимает изображение рекламного отчёта, извлекает показатели и передаёт их в систему аналитики.
Разберём небольшой пример с Gemini API. Он рассчитан на тех, кто уже немного знаком с Python. Остальным для первого знакомства достаточно предыдущей инструкции без программирования.
Установите библиотеку
Понадобятся Python, ключ Gemini API и доступ к сервису. Использование API может оплачиваться отдельно от подписки на приложение Gemini.
Откройте терминал и выполните:
python -m pip install -U google-genaiЕсли в вашей системе Python запускается командой python3 или py, используйте соответствующий вариант.
Сохраните API-ключ
Получите ключ в Google AI Studio. Для безопасности лучше передавать его через переменную окружения, а не вставлять прямо в код.
Например, в PowerShell на Windows:
$env:GEMINI_API_KEY = "ваш_ключ"На macOS или Linux:
export GEMINI_API_KEY="ваш_ключ"Команду выполняют в том же терминале, где затем будет запускаться программа. Не публикуйте настоящий ключ в репозитории или скриншотах.
Отправьте изображение модели
Создайте папку для проекта. Поместите туда скачанный учебный отчёт multimodal-ai-ad-report-practice.png и создайте рядом файл multimodal_example.py.
Вставьте в него код:
from pathlib import Path

from google import genai

from google.genai import types

client = genai.Client()

image_data = Path(

    "multimodal-ai-ad-report-practice.png"

).read_bytes()

response = client.models.generate_content(

    model="gemini-3.8-flash",

    contents=[

        "Прочитай таблицу на изображении. "

        "Для каждого канала выпиши расходы, "

        "клики и заявки. Не придумывай цифры.",

        types.Part.from_bytes(

            data=image_data,

            mime_type="image/png"

        ),

    ],

)

print(response.text)
В терминале перейдите в папку проекта и запустите:
python multimodal_example.pyПрограмма прочитает PNG-файл и передаст модели изображение вместе с текстовой инструкцией. Полученный ответ выведется в терминал.
В данном случае мы просим только извлечь исходные данные. Расчёты CPC, CR и CPL в рабочем приложении надёжнее выполнять отдельным Python-кодом, а не поручать их полностью языковой модели.
Если захотите разработать более сложный ИИ-сервис, например помощника с доступом к базе данных и внешним инструментам, пригодится наш разбор LangChain.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Какие ограничения есть у мультимодальных нейросетей
Мультимодальная модель может прочитать изображение и подготовить убедительный ответ, но это ещё не гарантирует его точность. На скриншотах нейросети иногда путают цифры и столбцы, в аудиозаписях — слова и имена, а в видео — отдельные события.
Поэтому проверка зависит от задачи. Для рекламного отчёта важны точные числа и формулы, для интервью — цитаты, а для анализа ролика — соответствие описания реальным кадрам.
Есть и вопрос конфиденциальности. Прежде чем загружать в сторонний сервис клиентские документы, записи разговоров или внутреннюю статистику, проверьте правила компании и условия обработки данных.
Для работы с мультимодальным ИИ достаточно соблюдать несколько правил:
- Используйте качественные изображения и записи.
- Сначала проверяйте извлечённые факты, затем выводы.
- Просите модель отмечать неразборчивые фрагменты.
- Перепроверяйте важные числа, даты и цитаты.
- Не загружайте закрытую информацию без разрешения.
Если модель уверенно сообщает то, чего нет на изображении или в записи, это может быть галлюцинацией — ошибкой, при которой ИИ выдаёт неверные сведения за достоверные. Мы подробно разбирали такие случаи в статье «Галлюцинации нейросетей: почему возникают и как с ними бороться».
Для знакомства с мультимодальностью достаточно одного эксперимента со скриншотом. Если результат пригодится в работе, следующим шагом может стать автоматизация: приложение будет само получать изображения или записи, извлекать нужную информацию и передавать её дальше. Именно здесь появляются задачи для разработчиков мультимодальных ИИ-систем.
FAQ
Мультимодальная нейросеть — это модель искусственного интеллекта, которая умеет работать с несколькими видами информации, например текстом и изображениями, аудио или видео.
Мультимодальность означает, что система может обрабатывать несколько типов данных на входе или выходе. Например, получать изображение и текстовый вопрос и формировать ответ.
Мультимодальной генеративной моделью называют модель, которая работает с несколькими видами информации и создаёт контент. Например, получает фотографию и генерирует текстовое описание.
Текстовая LLM работает преимущественно с языковой информацией. Мультимодальная LLM дополнительно может обрабатывать изображения, звук или другие поддерживаемые виды данных.
Мультимодальные возможности есть у моделей, используемых в ChatGPT, семейства Gemini и Qwen-VL. Конкретные типы входных и выходных данных зависят от модели и сервиса.
Для анализа изображений и документов, расшифровки аудио, обработки видео, поиска по разным типам данных и создания ИИ-приложений.