В рекламной выгрузке название кампании может повторяться сотни раз, а соседние показатели отличаются по масштабу: расход — десятки тысяч рублей, CTR — единицы процентов. Обе проблемы решает нормализация, но разными способами. Разберём их на понятном примере.
Что такое нормализация данных
Нормализация данных — это приведение данных к удобному и предсказуемому виду по заданным правилам. Значение термина зависит от задачи.
| Где работают с данными | Что делают |
| В базе данных | Разносят сведения по связанным таблицам, чтобы сократить повторы |
| В машинном обучении | Приводят числовые признаки к сопоставимому масштабу |
Допустим, компания собирает статистику рекламных кампаний. Базе нужно правильно хранить названия кампаний, источники трафика, менеджеров и показатели. Модели нужны числа, на которых она сможет искать закономерности: расход, CTR, CPC, число лидов. Исходные данные одни, а нормализация решает две разные задачи.
Нормализация не заменяет очистку данных. Она не исправит опечатку в названии кампании, не заполнит пропуск и не удалит готовые дубли. Сначала данные проверяют и очищают, затем приводят к нужной структуре или масштабу.
Как нормализация работает в базе данных
Представим таблицу с ежедневной статистикой:
| Дата | Кампания | Источник | Менеджер | Почта | Расход | Лиды |
| 01.11 | Осенний запуск | Поиск | Анна | a@example.com | 60 000 | 96 |
| 02.11 | Осенний запуск | Поиск | Анна | a@example.com | 54 000 | 83 |
| 02.11 | Осенний запуск | Telegram | Анна | a@example.com | 21 000 | 31 |
Пока строк мало, таблица выглядит нормально. Через год имя кампании и контакты менеджера будут повторяться в сотнях записей. Если Анна поменяет почту, адрес придётся обновлять в каждой строке. Достаточно пропустить одну запись — и в базе появятся две версии одного факта.
После нормализации данные можно разделить так:
- в таблице daily_stats хранить дату, расход, лиды и идентификаторы кампании и источника;
- в campaigns — названия кампаний и ответственных менеджеров;
- в sources — источники трафика;
- в managers — имена и контакты менеджеров.
Таблицы связываются идентификаторами: например, campaign_id или manager_id. Почта Анны теперь хранится в одном месте. В ежедневной статистике остаются только показатели и ссылки на нужные записи.
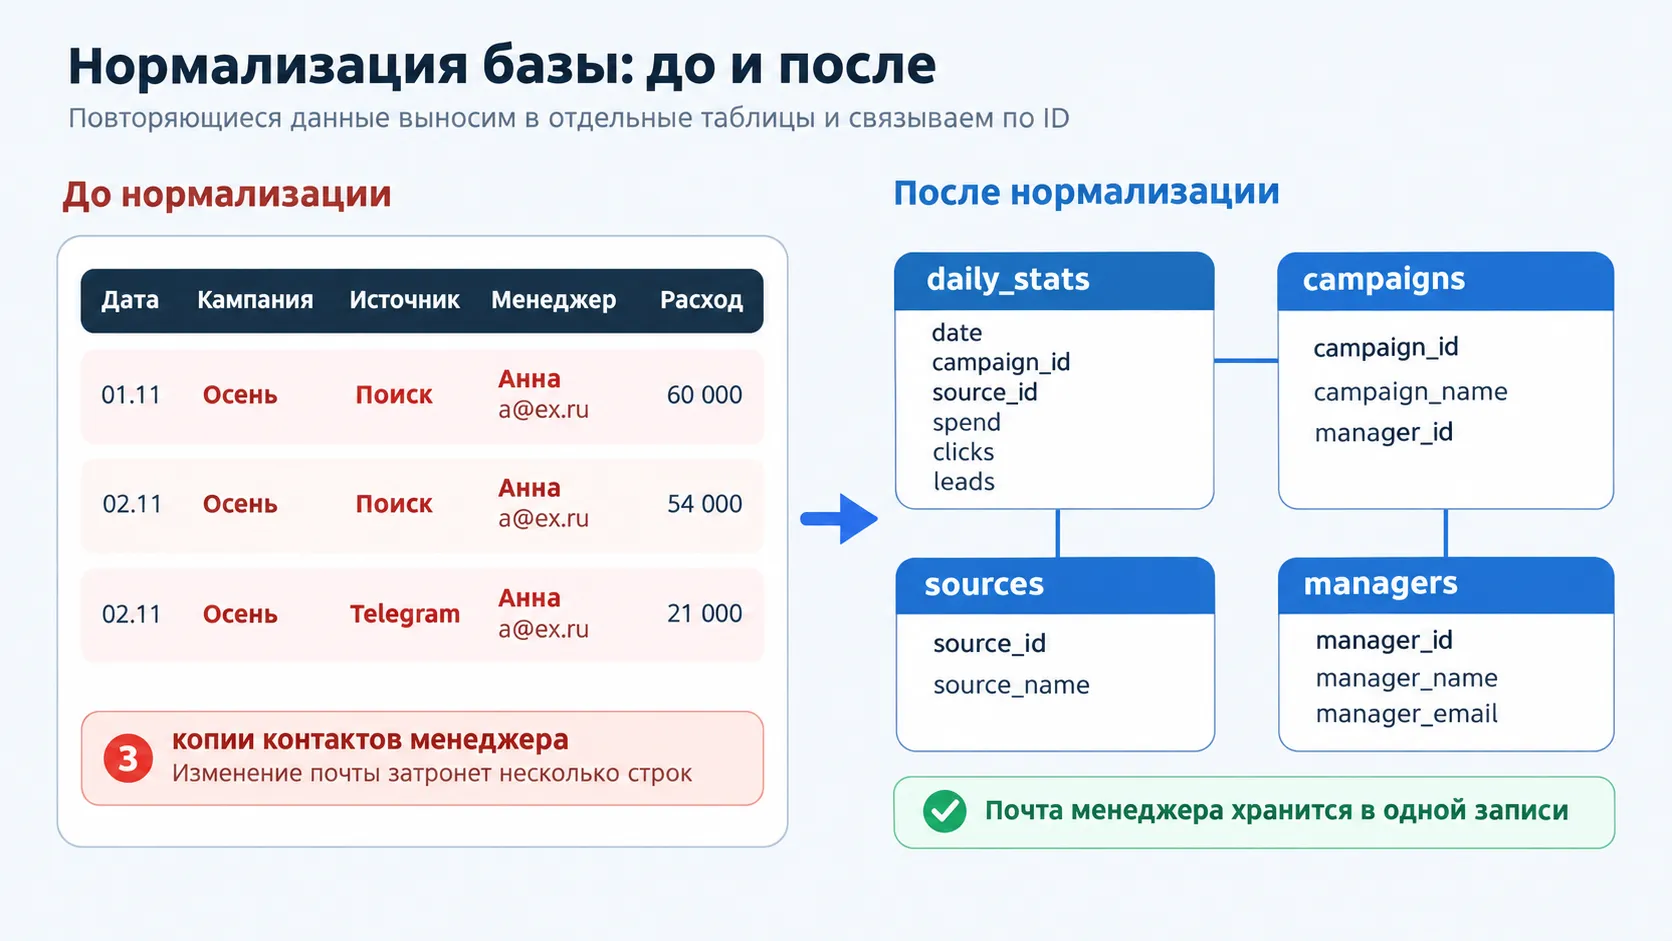
В результате базу проще обновлять и проверять. Новую почту менеджера меняют один раз, источник можно добавить ещё до появления статистики, а название кампании не приходится копировать в каждую строку.
Что такое 1НФ, 2НФ и 3НФ
Нормальные формы — это требования к устройству таблиц. Для большинства вводных задач достаточно понимать первые три.
| Нормальная форма | Простое объяснение | Пример |
| 1НФ | В одной ячейке хранится одно значение, каждую строку можно отличить от остальных | Имя и почта менеджера находятся в разных полях |
| 2НФ | Обычные столбцы зависят от всего составного ключа | Название кампании выносят из статистики, потому что оно зависит только от campaign_id |
| 3НФ | Сведения об одном объекте не хранят среди данных другого объекта | Имя и почту менеджера переносят в таблицу managers |
Составной ключ — это сочетание нескольких полей, которое определяет строку. Для ежедневной статистики таким сочетанием могут быть дата, кампания и источник. Расход относится ко всему сочетанию, а название кампании зависит только от самой кампании. Поэтому название удобнее хранить отдельно.
Третья нормальная форма помогает убрать ещё один тип повторов. Если в каждой кампании записаны имя и почта ответственного, контакты менеджера дублируются. В таблице кампаний оставляют manager_id, а сами контакты хранят в таблице менеджеров.
Есть и более строгие формы — BCNF, 4НФ и 5НФ. В типовых задачах новичка они нужны реже. Сначала полезнее научиться замечать очевидные повторы и понимать, к какому объекту относится каждый столбец.
Как нормализовать таблицу
Возьмите одну большую таблицу и разберите её по шагам:
- Определите отдельные объекты: кампании, источники, менеджеры, статистика.
- Для каждого объекта создайте свою таблицу.
- Добавьте первичные ключи: campaign_id, source_id, manager_id.
- В таблице статистики замените повторяющиеся названия идентификаторами.
- Свяжите таблицы внешними ключами.
- Проверьте, где придётся менять данные, если кампания получит новое название или менеджер сменит почту.
Хороший контрольный вопрос: «Сколько строк нужно изменить, чтобы обновить один факт?» Если правильный ответ — одна, структура, скорее всего, выбрана удачно. Если править нужно десятки строк, в таблице остался повтор.
Само количество таблиц ничего не гарантирует. Базу можно разбить на десять частей и всё равно сохранить неудобные зависимости. Смотрите на смысл данных: один объект должен иметь одно понятное место хранения.
Когда таблицу оставляют широкой
Для отчёта или анализа часто удобнее собрать плоскую таблицу, где рядом находятся кампания, источник, расход, клики и лиды. Это называется денормализацией. Дашборду проще читать готовую витрину, чем каждый раз соединять несколько таблиц.
Такой подход подходит для аналитических выгрузок и CSV-файлов. Важно знать, откуда берутся данные и как обновляется витрина. Основную информацию лучше хранить в надёжной связанной структуре, а широкую таблицу собирать из неё автоматически.
Что означает нормализация в Data Science
В машинном обучении тем же словом часто называют масштабирование числовых признаков. Допустим, в датасете есть расход 90 000 рублей, CTR 1,9% и CPC 37 рублей. Для человека значения понятны, а алгоритм видит числа с очень разным диапазоном.
Это особенно важно для методов, которые считают расстояние между объектами, например kNN, а также для SVM, PCA и многих линейных моделей. Большой диапазон одного признака может заметно влиять на расчёты. После масштабирования расход, CTR и CPC становятся сопоставимее.
Деревья решений и модели на их основе обычно не требуют такого преобразования. Поэтому scaler не добавляют автоматически во все проекты. Сначала смотрят на данные и выбранный алгоритм.
Нормализация и стандартизация: в чём разница
В повседневной речи нормализацией могут называть почти любое масштабирование. В библиотеках Python у методов разные названия и правила.
| Метод | Что делает | Когда пригодится |
| MinMaxScaler | Переносит значения в диапазон, обычно от 0 до 1 | Когда нужен фиксированный диапазон |
| StandardScaler | Делает среднее близким к 0, а стандартное отклонение — к 1 | Частый стартовый вариант для линейных моделей, SVM, kNN и PCA |
| RobustScaler | Использует медиану и устойчивее реагирует на выбросы | Когда встречаются отдельные очень большие или маленькие значения |
| Normalizer | Приводит длину каждой строки-вектора к единице | Для текстовых векторов и сравнения объектов по направлению |
При Min–Max-нормализации используют формулу (x − min) / (max − min). Минимальное значение становится 0, максимальное — 1, остальные располагаются между ними. При стандартизации из значения вычитают среднее и делят результат на стандартное отклонение. После неё числа могут быть меньше 0 или больше 1.
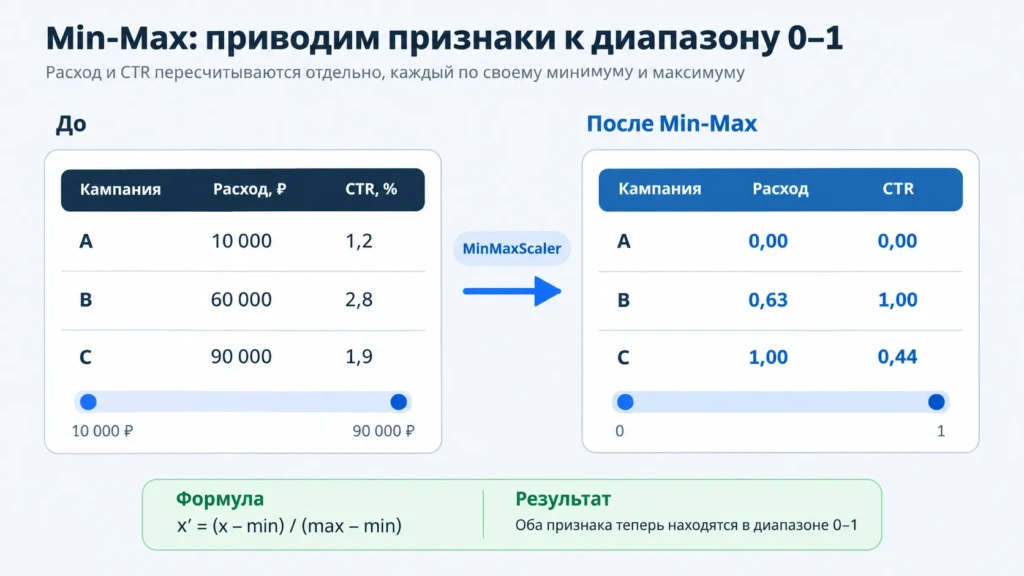
У MinMaxScaler есть слабое место: один сильный выброс растягивает диапазон и сжимает остальные значения. Поэтому способ выбирают после просмотра данных, а результат проверяют на качестве модели.
Как масштабировать признаки в Python
Покажем базовый пример на статистике кампаний. В файле campaigns.csv есть расход, CTR, CPC и число конверсий. Модель должна предсказывать конверсии по трём числовым признакам. Если пока сложно различать массивы и таблицы Python, сначала посмотрите, чем NumPy отличается от Pandas.
import pandas as pd

from sklearn.model_selection import train_test_split

from sklearn.preprocessing import StandardScaler

df = pd.read_csv("campaigns.csv")

features = df[["spend", "ctr", "cpc"]]

target = df["conversions"]

X_train, X_test, y_train, y_test = train_test_split(

    features,

    target,

    test_size=0.2,

    random_state=42,

)

scaler = StandardScaler()

X_train_scaled = scaler.fit_transform(X_train)

X_test_scaled = scaler.transform(X_test)
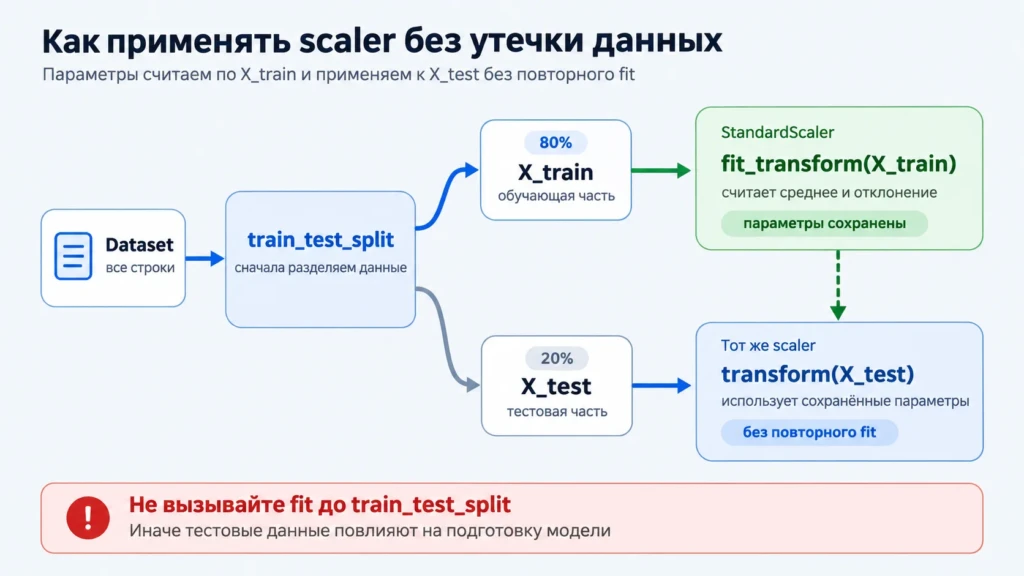
Сначала данные делят на обучающую и тестовую части. fit_transform() рассчитывает среднее и разброс по X_train, а затем преобразует обучающие значения. Для X_test вызывают только transform(), чтобы применить уже найденные параметры.
Если обучить scaler сразу на всём датасете, информация из тестовой части попадёт в подготовку модели. Проверка получится слишком оптимистичной. Такой случай называют утечкой данных.
В рабочем проекте scaler и модель часто объединяют через Pipeline. Тогда одинаковая последовательность действий используется при обучении и при прогнозе на новых данных. Это снижает риск забыть преобразование или случайно рассчитать его заново.
Работа специалиста Data Science начинается ещё до обучения модели. Нужно понять, какие столбцы полезны, отделить часть данных для честной проверки, выбрать способ преобразования и оценить результат. От этих решений зависит, можно ли доверять прогнозу.
Курс «Data Science и Machine Learning» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Частые ошибки при нормализации признаков
| Ошибка | Почему это проблема | Что сделать |
| Scaler обучили до разделения датасета | Тестовые данные повлияли на подготовку модели | Сначала сделать train_test_split, затем вызвать fit на X_train |
| Для X_test снова вызвали fit_transform() | Обучающая и тестовая части получили разные шкалы | Использовать тот же scaler и метод transform() |
| Масштабировали campaign_id | Идентификатор превратился в число с выдуманным порядком | Убрать служебный ID из признаков |
| Не проверили выбросы | Большое значение могло сжать основную часть диапазона | Посмотреть распределение и при необходимости выбрать RobustScaler |
| Ждали, что scaler очистит данные | Пропуски, ошибки и дубли никуда не исчезли | Провести очистку отдельным этапом |
Если модель работает с текстами или изображениями, она может представлять объекты в виде числовых векторов. Для них часто применяют L2-нормализацию, чтобы сравнивать направление векторов без влияния их длины. Подробнее об этом читайте в статье об эмбеддингах.
Какой способ нормализации выбрать
Сначала уточните задачу:
- Проектируете базу. Разделите данные по объектам, добавьте ключи и проверьте 1НФ, 2НФ и 3НФ.
- Готовите отчёт. Широкая таблица допустима, если она автоматически собирается из надёжного источника.
- Обучаете модель. Посмотрите на диапазоны признаков и требования алгоритма.
- Есть заметные выбросы. Сравните StandardScaler и RobustScaler.
- Работаете с векторами. Проверьте, нужна ли нормализация каждой строки через Normalizer.
После любого преобразования проверьте результат. В базе попробуйте изменить один факт и убедитесь, что он хранится в одном месте. В Data Science сравните качество модели на тестовой выборке и сохраните тот же scaler для новых данных.
FAQ
Нет, готовые дубли она автоматически не удаляет. Нормализация меняет структуру хранения и уменьшает вероятность новых повторов. Старые записи нужно обработать отдельно.
В широком смысле стандартизацию часто относят к методам нормализации. MinMaxScaler обычно переносит значения в диапазон от 0 до 1, а StandardScaler приводит среднее к 0 и стандартное отклонение к 1.
Нет. Обычно масштабируют числовые признаки, для которых важны величина и расстояние. Идентификаторы и текстовые категории обрабатывают отдельно.
После разделения датасета scaler обучают только на X_train. К тестовым и новым данным применяют уже рассчитанные параметры через transform().
Да. Основные данные можно хранить в связанных таблицах, а для аналитики автоматически собирать широкие витрины и выгрузки.