Выбросы в данных — это отдельные значения, которые заметно отличаются от основной массы наблюдений в выборке. Они могут возникать из-за ошибок измерения, неправильного ввода информации, сбоев оборудования или реальных особенностей исследуемого процесса. Такие значения способны искажать статистику, влиять на результаты анализа и снижать точность моделей машинного обучения.
Поиск выбросов — один из важных этапов подготовки данных. Перед удалением необходимо выяснить, почему наблюдение отличается от остальных и действительно ли оно ошибочное. Для обнаружения используют статистические методы, межквартильный размах, Z-оценку, диаграммы boxplot и алгоритмы машинного обучения.
Разберем, что такое выбросы, как обнаружить их в наборе данных, какие способы подходят для разных задач и когда нужно удаление аномальных значений.
Что такое выбросы в данных
Выброс (outlier) — наблюдение, которое существенно отклоняется от характерного распределения значений в выборке. В статистике так называют точки, расположенные на необычно большом расстоянии от основной группы данных.
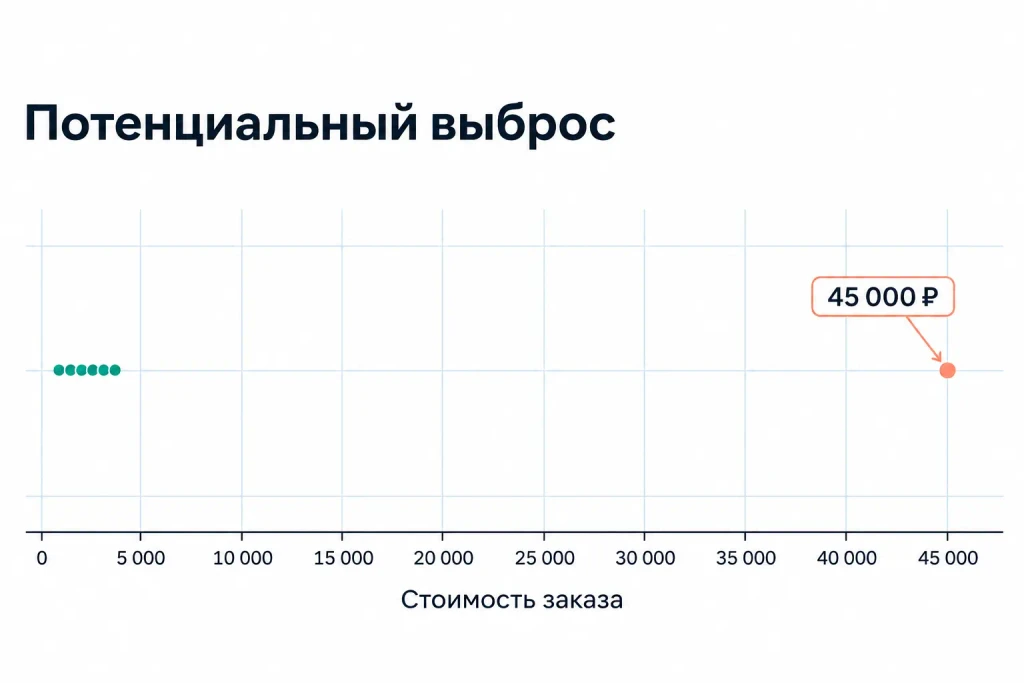
Например, интернет-магазин анализирует стоимость заказов:
1200, 1350, 1400, 1500, 1550, 1600, 1480, 1520, 45000
Большинство покупок находится в диапазоне 1200–1600 рублей. Последнее значение — 45 000 рублей — заметно отличается от остальных. Это потенциальный выброс, который стоит проверить.
Причины появления таких наблюдений различаются:
- Ошибки ввода. Вместо 1500 рублей сотрудник указал 15 000.
- Сбои оборудования. Датчик температуры передал некорректное значение.
- Ошибки сбора и обработки. При объединении таблиц нарушились единицы измерения или форматы чисел.
- Редкие события. Пользователь совершил необычно крупную покупку.
- Особенности распределения. В выборке присутствуют несколько групп объектов с разными характеристиками.
Важно различать ошибочные и необычные значения. Если клиент действительно оформил заказ на 45 000 рублей, это не ошибка измерения. Удаление такой записи приведет к потере полезной информации.
В статистике также различают глобальные и локальные выбросы. Первые отличаются от большинства наблюдений во всей выборке. Вторые выглядят необычно только относительно ближайших объектов или своей группы. Например, температура 30 °C может быть нормальной летом, но аномальной для зимних измерений.
Как выбросы влияют на статистику и анализ данных
Аномальные значения не всегда существенно меняют результаты исследования. Влияние зависит от количества таких наблюдений, их величины, распределения и выбранного метода анализа.
Наиболее заметные последствия:
- Искажение среднего арифметического. Несколько экстремальных значений могут существенно изменить итоговый показатель.
- Увеличение дисперсии. Разброс наблюдений становится больше, чем в основной части выборки.
- Изменение стандартного отклонения. Метрика чувствительна к большим отклонениям от среднего.
- Искажение корреляции. Отдельные точки способны изменить оценку связи между признаками.
- Ухудшение качества моделей. В задачах регрессии экстремальные значения могут непропорционально влиять на функцию потерь и параметры модели.
Например, если большинство сотрудников получает 70–100 тысяч рублей, а один руководитель — 900 тысяч, средняя зарплата по компании окажется заметно выше дохода типичного работника. В такой ситуации медиана может лучше описывать положение основной группы.
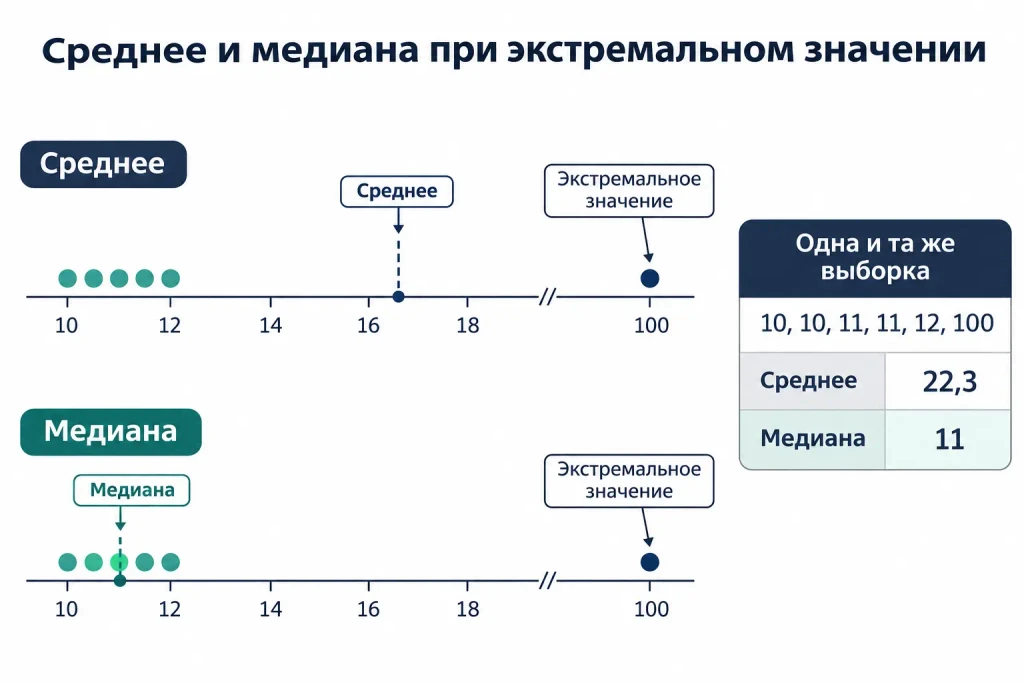
При этом устойчивые к выбросам методы, например медиана и межквартильный размах, позволяют уменьшить влияние экстремальных наблюдений.
Основные методы обнаружения выбросов
Универсального способа найти все аномальные значения нет. Выбор метода зависит от объема выборки, количества признаков, характера распределения и задачи исследования. Для простых таблиц обычно достаточно статистических критериев. При работе со сложными наборами данных применяют алгоритмы машинного обучения.
1. Межквартильный размах (IQR)
Межквартильный размах — один из распространенных способов обнаружения выбросов. Он показывает ширину центральной половины распределения и практически не зависит от отдельных экстремальных значений.
Для расчета используют три показателя:
- Q1 — первый квартиль. Ниже него находится 25% наблюдений.
- Q2 — второй квартиль, или медиана. Делит выборку пополам.
- Q3 — третий квартиль. Ниже него расположено 75% наблюдений.
Межквартильный размах рассчитывают по формуле:
IQR=Q3-Q1
После этого определяют нижнюю и верхнюю границы:
L=Q1-1,5IQR
U=Q3+1,5IQR
Значения за пределами этих границ считаются потенциальными выбросами.
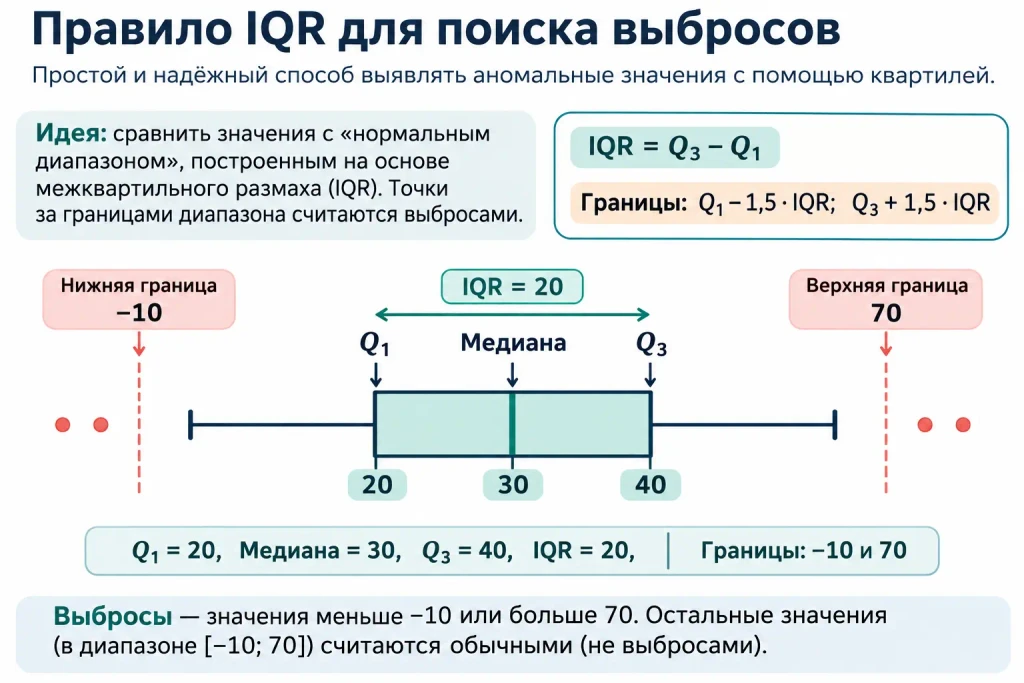
Пример расчета.
Допустим, первый квартиль равен 20, а третий — 40. Тогда:
IQR=40-20=20
Нижняя граница:
L=20-1,520=-10
Верхняя граница:
U=40+1,520=70
Следовательно, все значения меньше −10 и больше 70 попадают в категорию потенциальных выбросов.
Коэффициент 1,5 — общепринятое правило Тьюки для поиска умеренно удаленных наблюдений. Для выявления экстремальных значений иногда используют множитель 3.
Когда применять: при анализе числовых показателей, небольших и средних таблиц, распределений с асимметрией.
2. Z-оценка и стандартное отклонение
Z-оценка показывает, на сколько стандартных отклонений конкретное значение удалено от среднего арифметического.
Формула:
Z = (x - μ) / σГде:
- x — анализируемое значение;
- μ — среднее арифметическое;
- σ — стандартное отклонение.
Если модуль Z-оценки превышает 3, наблюдение часто рассматривают как потенциальный выброс:
Если модуль Z-оценки превышает 3, наблюдение часто рассматривают как потенциальный выброс:
|Z|>3
Например, средняя температура в наборе измерений составляет 20 °C, а стандартное отклонение — 2 °C. Для значения 28 °C получаем:
Z=(28-20)/2=4
Результат превышает установленный порог. Такое наблюдение требует дополнительной проверки.
Ограничение метода — чувствительность среднего и стандартного отклонения к экстремальным значениям. Если в выборке уже есть крупные выбросы, они могут изменить обе характеристики и затруднить обнаружение других аномалий.
Z-оценку лучше использовать для данных с приблизительно нормальным распределением. Для асимметричных распределений и выборок с большим количеством экстремальных значений предпочтительнее устойчивые статистические методы.
3. Диаграмма размаха Boxplot
Boxplot (ящик с усами) — графический способ изучения распределения и поиска потенциальных выбросов.
Диаграмма отображает несколько характеристик:
- нижняя граница ящика соответствует первому квартилю;
- линия внутри ящика показывает медиану;
- верхняя граница обозначает третий квартиль;
- высота ящика равна межквартильному размаху;
- усы показывают диапазон наблюдений, не выходящих за установленные границы;
- отдельные точки за усами обозначают потенциальные выбросы.
В классическом варианте boxplot усы заканчиваются на крайних наблюдениях, которые находятся в пределах 1,5 IQR от соответствующего квартиля. Поэтому их длина не обязательно совпадает с полным диапазоном значений.
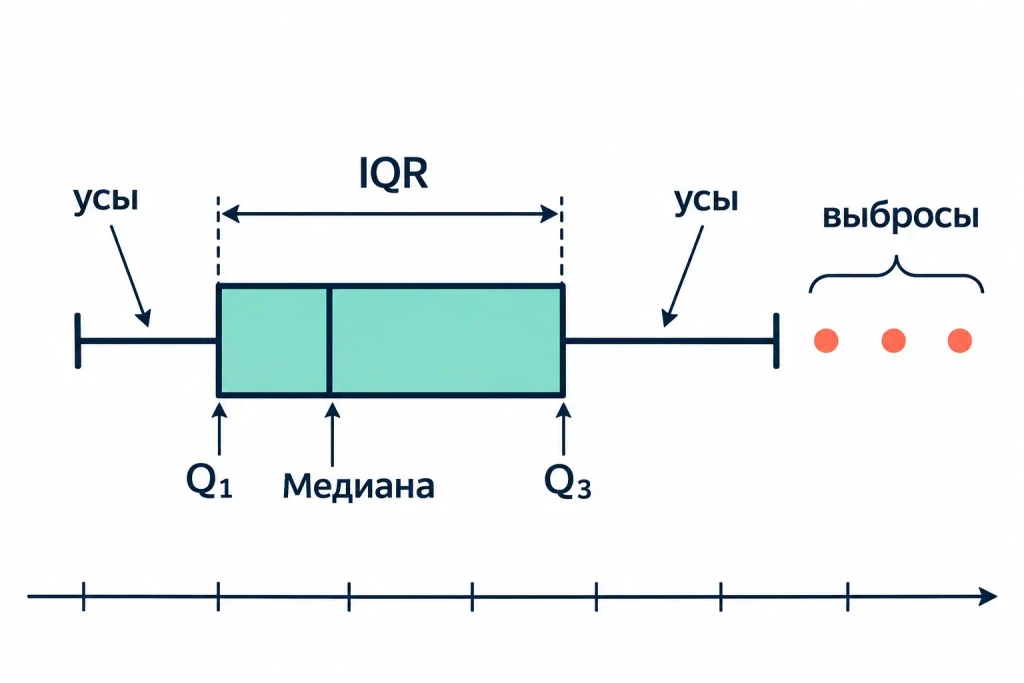
Преимущество метода — наглядность. Можно быстро увидеть асимметрию распределения, разброс и отдельные необычные наблюдения. Если построить несколько диаграмм для разных категорий, получится сравнить распределения между группами.
Однако boxplot не объясняет причину появления выброса. Кроме того, при большом количестве признаков анализировать каждую диаграмму вручную становится неудобно.
4. Модифицированная Z-оценка
Для выборок с экстремальными значениями вместо среднего и стандартного отклонения можно использовать медиану и медианное абсолютное отклонение (MAD).
Сначала рассчитывают MAD:
MAD = median(|xi - median(X)|)Затем определяют модифицированную Z-оценку:
Mi = 0,6745 * (xi — median(X)) / MAD
Значения с модулем выше 3,5 часто помечают как потенциальные выбросы.
Такой подход устойчивее классической Z-оценки, поскольку медиана и MAD меньше зависят от отдельных экстремальных наблюдений.
Метод подходит для распределений, в которых среднее и стандартное отклонение плохо описывают типичные значения. Но если MAD равен нулю, например из-за большого количества одинаковых чисел, стандартный расчет становится невозможным. В этом случае потребуется другой критерий.
5. Методы обнаружения выбросов в машинном обучении
Когда набор данных содержит много признаков, простые статистические критерии могут оказаться недостаточными. Значение может быть нормальным для одного столбца, но аномальным в сочетании с другими характеристиками.
Для таких задач используют алгоритмы обнаружения аномалий.
Isolation Forest (изолирующий лес). Алгоритм строит множество случайных деревьев и последовательно разделяет наблюдения по признакам. Аномальные объекты обычно изолируются за меньшее количество разбиений. Метод подходит для многомерных наборов данных и часто используется для поиска необычных транзакций, действий пользователей и технических событий.
Local Outlier Factor (LOF). Алгоритм сравнивает локальную плотность объекта с плотностью его ближайших соседей. Если вокруг точки значительно меньше похожих наблюдений, она получает высокий показатель аномальности. LOF полезен, когда в данных есть группы с разной плотностью.
One-Class SVM. Метод обучается определять область, в которой находятся обычные наблюдения. Точки за ее пределами классифицируются как аномальные. Алгоритм может работать со сложными границами распределения, но чувствителен к настройкам параметров и масштабу признаков.
Elliptic Envelope. Метод оценивает центр и ковариацию данных, предполагая, что основная масса наблюдений имеет приблизительно эллиптическое распределение.
В машинном обучении необходимо различать обнаружение выбросов и обнаружение новизны (novelty detection). В первом случае аномалии уже могут присутствовать в обучающей выборке. Во втором модель обучают на относительно чистых данных, а затем проверяют новые наблюдения. Это разные сценарии работы алгоритмов.
Курс «Data Science и Machine Learning» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Сравнение методов поиска выбросов
| Метод | Преимущества | Ограничения |
| Межквартильный размах | Не требует нормального распределения | Не учитывает связи между признаками |
| Z-оценка | Простой расчет и интерпретация | Чувствительна к экстремальным значениям |
| Boxplot | Наглядное представление | Не объясняет причины аномалий |
| Модифицированная Z-оценка | Устойчива к выбросам | Может не работать при MAD = 0 |
| Isolation Forest | Подходит для многомерных данных | Требует настройки и проверки результатов |
| LOF | Учитывает локальную плотность | Зависит от выбора числа соседей |
| One-Class SVM | Позволяет выявлять сложные границы | Чувствителен к параметрам и масштабированию |
Как найти выбросы в данных на Python
Для практической работы удобно использовать библиотеку Pandas для обработки таблиц и NumPy для вычислений. Найти потенциальные выбросы можно несколькими строками кода.
Рассмотрим пример с межквартильным размахом.
import pandas as pd

data = {
    "price": [1200, 1350, 1400, 1500, 1550,
              1600, 1480, 1520, 45000]
}

df = pd.DataFrame(data)

# Рассчитываем квартили
Q1 = df["price"].quantile(0.25)
Q3 = df["price"].quantile(0.75)

# Межквартильный размах
IQR = Q3 - Q1

# Определяем границы
lower = Q1 - 1.5 * IQR
upper = Q3 + 1.5 * IQR

# Находим выбросы
outliers = df[
    (df["price"] < lower) |
    (df["price"] > upper)
]

print("Найденные выбросы:")
print(outliers)
В результате программа выведет наблюдения, которые не попадают в установленный диапазон. В нашем примере это крупный заказ на 45 000 рублей.
Курс «Python Ninja» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Если нужно проверить сразу несколько числовых столбцов, можно использовать цикл:
for column in df.select_dtypes(include="number").columns:
    Q1 = df[column].quantile(0.25)
    Q3 = df[column].quantile(0.75)
    IQR = Q3 - Q1

    lower = Q1 - 1.5 * IQR
    upper = Q3 + 1.5 * IQR

    outliers = df[
        (df[column] < lower) |
        (df[column] > upper)
    ]

    print(f"\nСтолбец: {column}")
    print(outliers)
Этот вариант позволяет быстро проверить числовые признаки в таблице. При этом важно учитывать, что границы рассчитываются отдельно для каждого столбца. Взаимосвязи между признаками такой анализ не учитывает.
Для поиска аномалий с помощью Isolation Forest подойдет следующий пример:
import pandas as pd
from sklearn.ensemble import IsolationForest

df = pd.DataFrame({
    "price": [1200, 1350, 1400, 1500, 1550,
              1600, 1480, 1520, 45000],
    "quantity": [1, 2, 1, 3, 2, 1, 2, 1, 15]
})

model = IsolationForest(
    contamination=0.1,
    random_state=42
)

df["anomaly"] = model.fit_predict(df)

# Выводим обнаруженные аномалии
print(df[df["anomaly"] == -1])
Алгоритм присваивает обычным наблюдениям метку 1, а потенциальным выбросам — -1. Параметр contamination задает ожидаемую долю аномалий для определения порога классификации. Значение 0.1 в примере выбрано для демонстрации.
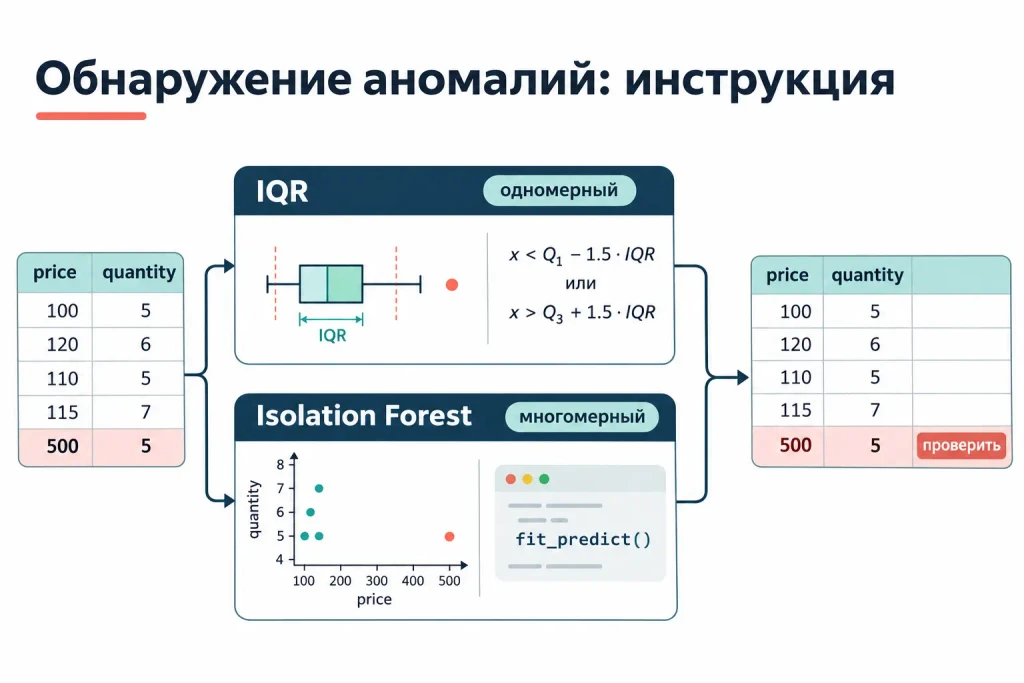
Перед применением модели желательно проверить масштаб признаков, пропущенные значения и качество исходной таблицы. Результат Isolation Forest не следует воспринимать как доказательство ошибки: алгоритм выявляет необычные объекты, но не определяет, почему они появились.
Удаление выбросов: когда это нужно делать
Не каждую необычную точку следует исключать из выборки. Иногда она отражает редкое, но вполне реальное событие.
Перед очисткой желательно установить причину отклонения и оценить его влияние на результаты исследования.
Существует несколько способов обработки:
- Удаление строк. Подходит для подтвержденных ошибок измерения, ввода или сбора информации. Например, если температура датчика составила 800 °C при физически невозможных для оборудования условиях и проверка подтвердила сбой, такую запись можно исключить.
- Замена значения. Если наблюдение явно ошибочное, но удалять всю строку нежелательно, можно заменить значение медианой или другим обоснованным показателем. Такой вариант требует осторожности, ведь искусственно подставленное число не является реальным измерением.
- Ограничение значений. Экстремальные значения заменяют ближайшими значениями на установленных процентильных границах. Например, все наблюдения выше 99-го процентиля приводят к значению этого процентиля. Метод позволяет уменьшить влияние крайних значений, сохранив количество строк.
- Логарифмирование. Преобразование числовых признаков помогает уменьшить асимметрию распределения и влияние очень больших значений. Оно полезно для показателей с правосторонним длинным хвостом, например стоимости заказов или доходов. Однако логарифмирование не исправляет ошибки в исходных данных и не гарантирует устранения выбросов.
- Использование устойчивых методов. Вместо удаления наблюдений можно применять медиану, робастную регрессию и другие методы, менее чувствительные к экстремальным значениям.
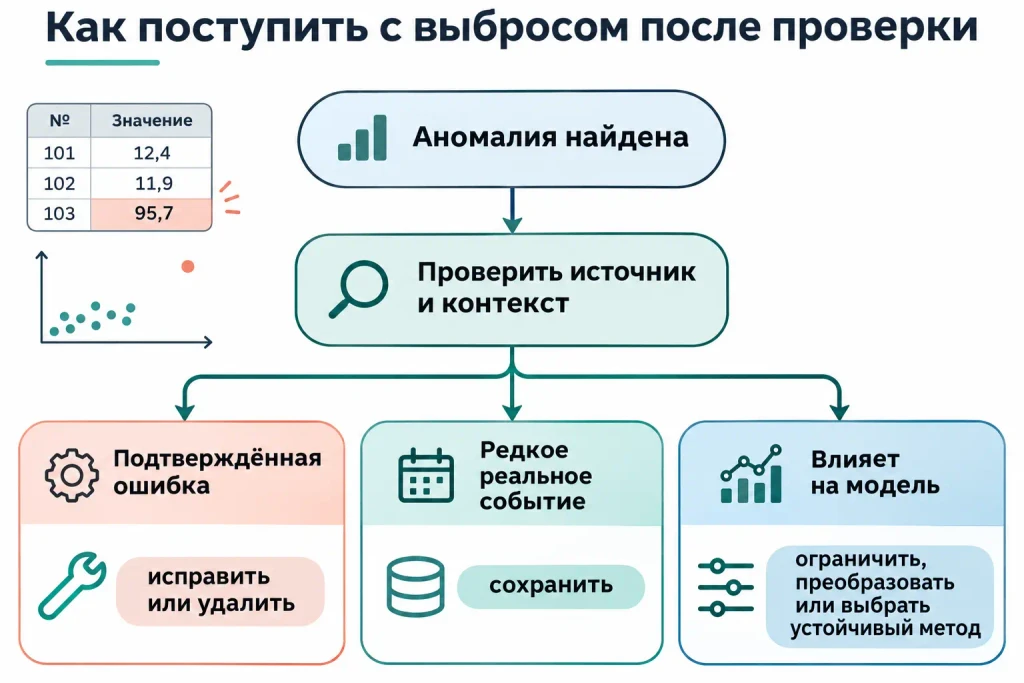
Для удаления выбросов, найденных по IQR, в Pandas можно использовать фильтрацию:
clean_df = df[
    (df["price"] >= lower) &
    (df["price"] <= upper)
].copy()
В результате останутся только строки, попадающие в рассчитанный диапазон. Перед такой операцией желательно сохранить исходную таблицу, чтобы можно было сравнить результаты и восстановить исключенные наблюдения.
Типичные ошибки при поиске аномальных значений
Даже правильно рассчитанные статистические показатели не гарантируют качественной очистки. На практике часто встречаются следующие проблемы:
- Автоматическое удаление всех выбросов. Редкие события могут быть важны для исследования. Например, крупные покупки интересны при анализе поведения клиентов.
- Использование одного порога для разных групп. В данных могут присутствовать категории с разными диапазонами нормальных значений.
- Игнорирование взаимосвязей признаков. Отдельное значение выглядит допустимым, но сочетание нескольких характеристик указывает на аномалию.
- Применение Z-оценки без проверки распределения. Для сильно асимметричных данных этот метод может давать некорректные результаты.
- Очистка до разделения обучающей и тестовой выборок. При построении прогнозных моделей параметры обработки нужно рассчитывать на обучающих данных, а затем применять к тестовым. Иначе возникает утечка информации.
- Отсутствие проверки после обработки. Необходимо повторно оценить распределение, статистические характеристики и качество модели.
Важно не удалять автоматически редкие наблюдения при работе с мошенничеством, банковскими операциями, кибербезопасностью и техническими сбоями. В таких задачах аномальные значения могут представлять наибольший интерес.
Какой метод обнаружения выбросов выбрать
Выбор зависит от структуры данных и цели анализа.
- Для небольшой таблицы с одним или несколькими числовыми столбцами подойдет межквартильный размах.
- Для приблизительно нормального распределения можно использовать Z-оценку.
- Для визуального изучения распределения удобно строить boxplot.
- Если выборка содержит экстремальные значения и асимметричные распределения, стоит рассмотреть модифицированную Z-оценку.
- Для многомерных данных и сложных зависимостей между признаками подойдут Isolation Forest и LOF.
Необязательно ограничиваться одним алгоритмом. В сложных проектах полезно сопоставить результаты нескольких методов и проверить найденные точки по исходным записям.
Заключение
Выбросы в данных — это наблюдения, которые заметно отличаются от основной массы значений. Они могут появляться из-за технических ошибок, неправильного ввода или реальных особенностей исследуемого процесса. Поэтому поиск аномалий должен сопровождаться проверкой их происхождения.
Для большинства стандартных задач достаточно начать с межквартильного размаха и диаграммы boxplot. Если требуется более глубокий анализ, можно использовать модифицированную Z-оценку и алгоритмы машинного обучения. Удаление оправданно только тогда, когда есть основания считать наблюдение ошибочным или не относящимся к исследуемой задаче. В остальных случаях лучше сохранить информацию и подобрать метод анализа, устойчивый к экстремальным значениям.
FAQ
Выбросы — отдельные значения, которые существенно отклоняются от общей массы наблюдений. Аномалии — более широкое понятие. К ним относятся не только экстремальные числа, но и необычные сочетания признаков, последовательности событий или отклонения от привычного поведения системы.
Да, но стандартные методы вроде IQR и Z-оценки для них не подходят. Вместо этого анализируют частоту категорий, ищут редкие комбинации признаков и используют алгоритмы обнаружения аномалий, способные работать с категориальными переменными.
Для временных рядов используют анализ отклонений от тренда и сезонных закономерностей, скользящие статистики, контрольные карты и специальные алгоритмы обнаружения аномалий.
Ложные выбросы — наблюдения, которые алгоритм помечает как аномальные, хотя на самом деле они соответствуют нормальному поведению системы.