Контекстное окно (context window) — это максимальный объём токенов, который языковая модель может учитывать в рамках одного запроса и генерации ответа. От размера контекстного окна зависит, сколько текста, истории переписки и других входных данных получится обработать за один вызов. Например, при анализе 100-страничного PDF этот параметр определяет, поместится ли извлечённый текст целиком в памяти LLM.
Для чего нужно контекстное окно нейросети
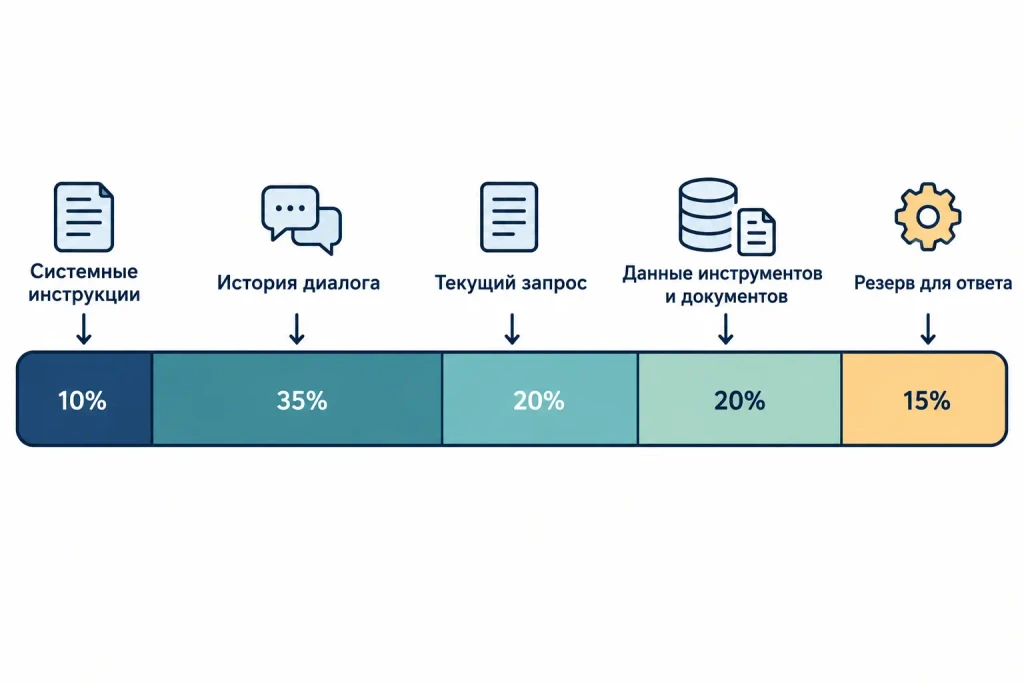
Контекстное окно ограничивает объём информации, доступной модели при обработке текущего запроса. В чат-боте в него могут входить системные инструкции, сообщения пользователя, предыдущие ответы, результаты вызовов инструментов и вложенные данные.
Модель обрабатывает последовательности разной длины в пределах поддерживаемых ограничений. Доступ к предыдущим токенам зависит от архитектуры внимания, а практический предел длины от обучения, реализации и вычислительных ресурсов.
Размер контекстного окна влияет на несколько задач:
- Работа с документами. Анализ договоров, отчётов, технической документации и исследований.
- Программирование. Разбор нескольких файлов проекта, поиск ошибок и подготовка изменений с учётом зависимостей.
- Диалог. Сохранение предыдущих сообщений, требований и уточнений в рамках доступного контекста.
- Автоматизация. Обработка инструкций, данных из API и результатов работы инструментов.
Допустим, нужно проверить PDF на 100 страниц. Если извлечённый текст, инструкции и резерв для ответа укладываются в доступный лимит, модель сможет получить документ целиком. Сам факт загрузки файла ещё не гарантирует, что весь его текст попадёт в память: сервис может использовать отдельную обработку, извлечение фрагментов или поиск.
Как работает контекстное окно
Токенизация превращает текст в последовательность чисел
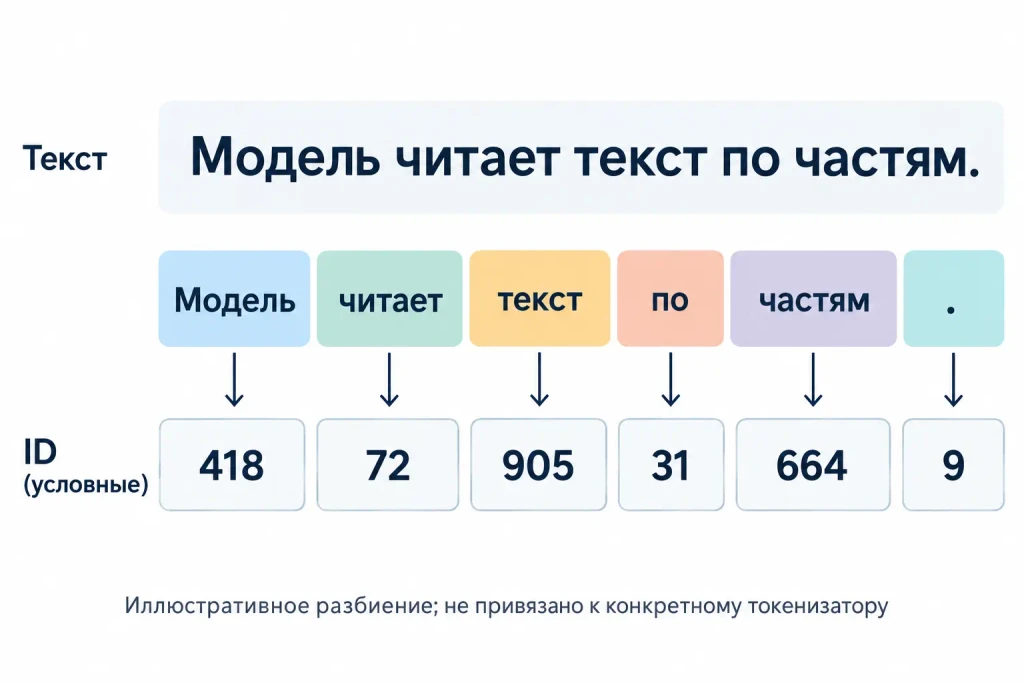
Нейросеть получает текст в виде токенов (tokens). Токен может соответствовать целому слову, части слова, знаку препинания или другому фрагменту текста. Каждый токен преобразуется в числовой идентификатор.
Токенизация (tokenization) выполняется алгоритмом. Среди распространённых подходов:
- BPE (Byte Pair Encoding). Объединяет часто встречающиеся последовательности символов или байтов в более крупные единицы.
- WordPiece. Использует подсловные единицы, выбираемые на основе статистики обучающего корпуса и словаря.
- SentencePiece. Инструментарий для обучения токенизаторов, который поддерживает, в частности, алгоритмы BPE и Unigram.
Конкретное разбиение зависит от токенизатора. Одно русское слово может превратиться в несколько токенов, тогда как распространённое английское слово часто кодируется одной единицей.
Пример токенизации текста
Ниже приведены примеры. Они показывают принцип разбиения токенов модели.
| Исходный текст | Возможное разбиение |
| Hello, world! | Hello / , / world / ! |
| Привет, мир! | При / вет / , / мир / ! |
| нейросеть | нейро / сеть |
| API | API |
Например, 12 000 символов русского текста могут занимать около 3 000–4 000 токенов.
Ограничения контекста и способы масштабирования
Почему большой контекст требует больше памяти
При генерации текста модель использует кеш ключей и значений (KV cache). Он сохраняет вычисленные представления предыдущих токенов, чтобы не пересчитывать их при каждом следующем шаге.
Как расширяют контекстное окно
Размер контекста зависит от обучения модели, позиционного кодирования и реализации механизма внимания. Для работы с длинными последовательностями используют несколько подходов.
- Скользящее окно (sliding window) ограничивает внимание ближайшими токенами. Это сокращает вычисления, но прямой доступ к удалённым частям последовательности может отсутствовать. Некоторые архитектуры дополнительно используют глобальные позиции или отдельные механизмы связи.
- RoPE (Rotary Position Embedding) кодирует относительные позиционные отношения через повороты векторов запросов и ключей. Для расширения диапазона позиций применяют различные схемы масштабирования, включая NTK-aware scaling. Они меняют поведение позиционного кодирования, однако не гарантируют сохранение исходного качества на любой длине.
- Ring Attention распределяет длинную последовательность между несколькими ускорителями. Блоки ключей и значений передаются между устройствами по кольцевой схеме, пока вычисляется внимание. Такой подход помогает распределять нагрузку, но требует подходящей аппаратной инфраструктуры.
Что происходит при переполнении контекста
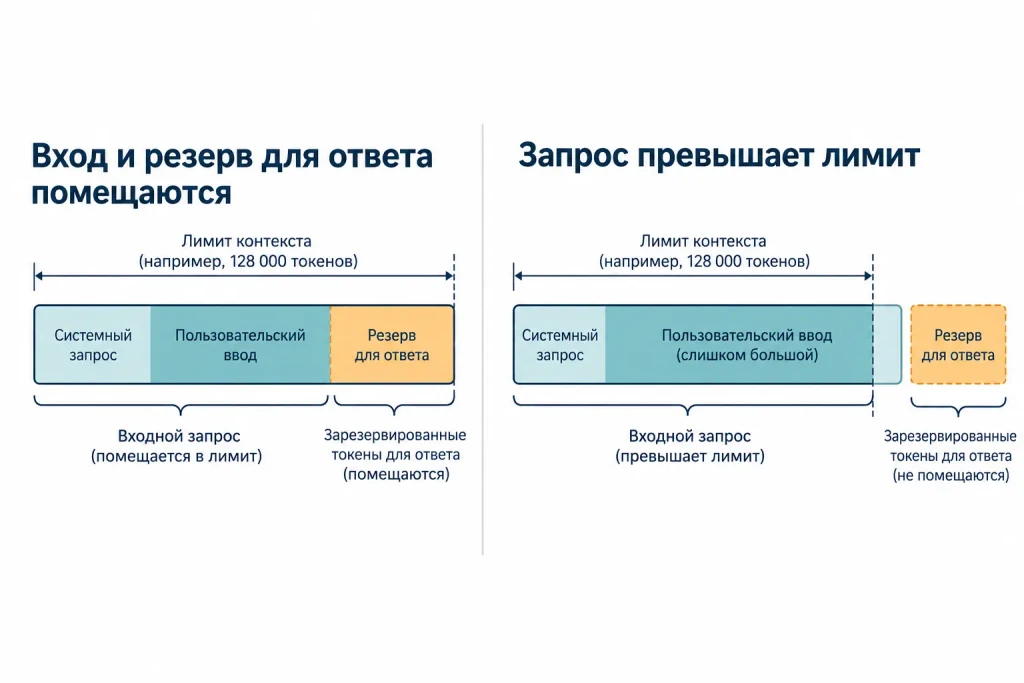
Лимит контекста включает входные данные и пространство, необходимое для генерации. В зависимости от API, архитектуры и настроек учитываются также служебные токены и внутренние механизмы обработки.
Если запрос превышает доступную ёмкость, возможны:
- ошибка валидации запроса;
- автоматическое сокращение истории в интерфейсе;
- усечение входных данных, если это предусмотрено приложением;
- остановка генерации при достижении допустимой длины.
Потеря информации может возникнуть и без переполнения. Феномен Lost in the Middle описывает снижение качества извлечения сведений, размещённых в середине длинного контекста. В экспериментах модели лучше использовали информацию в начале или конце последовательности.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Сравнение контекстных окон популярных моделей
Максимальная длина входа различается даже у моделей одного поколения. При сравнении нужно учитывать конкретную версию и условия доступа через API.
| Модель | Максимальный контекст |
| GPT-4o | 128 000 токенов |
| Claude 3.5 Sonnet | 200 000 токенов |
| Gemini 1.5 Pro | До 2 000 000 токенов |
| Llama 3 (8B, 70B) | 8 192 токена |
Максимальный размер окна не равен допустимому размеру пользовательского сообщения. Часть пространства занимает системный промпт, история диалога и служебные данные. Дополнительно API может ограничивать длину генерируемого ответа.
Как уместить большой документ в контекст
Для работы с крупными массивами данных применяют несколько стратегий. Выбор зависит от того, нужно ли анализировать весь материал одновременно или находить отдельные сведения.
Chunking, суммаризация и RAG
Chunking разделяет документ на фрагменты (чанки). Их размер выбирают с учётом структуры текста, модели и задачи. Для начала можно попробовать чанки по 500–1 000 токенов с небольшим перекрытием, а затем проверить качество поиска.
Суммаризация сокращает материал до основных положений. Она подходит для обзора документа, подготовки краткой справки или передачи результатов между этапами обработки. При этом числовые данные, исключения и формулировки условий могут потеряться.
RAG (Retrieval-Augmented Generation) сочетает генерацию ответа с поиском по внешней базе знаний. Документы индексируют, подходящие фрагменты извлекают по запросу и передают модели.
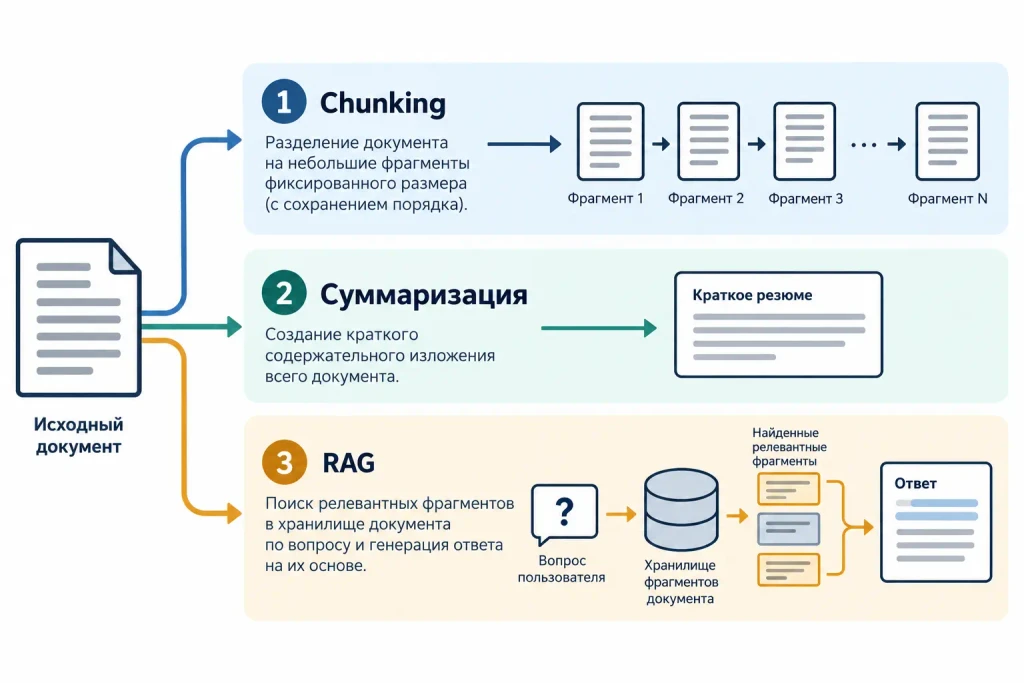
Даже при контексте в миллион токенов RAG может оказаться экономически выгоднее для корпоративной базы документов. Вместо повторной передачи всей документации каждый запрос использует несколько релевантных фрагментов. Это сокращает расход токенов, упрощает обновление базы и помогает контролировать источники ответа.
При внедрении таких решений в бизнес-процессы полезно изучить архитектуру генеративного ИИ.
Пример организации обработки документа
Для анализа технического регламента или договора можно использовать следующую последовательность:
- Извлечь текст из PDF, включая таблицы и необходимые метаданные. Проверить качество распознавания, если документ содержит сканы.
- Разделить текст на смысловые фрагменты с сохранением заголовков, номеров страниц и пунктов.
- Построить индекс для поиска. Для больших баз подойдут векторные представления (embeddings) и гибридный поиск.
- Найти фрагменты, связанные с вопросом. При необходимости расширить выборку соседними разделами.
- Передать найденные материалы модели вместе с инструкцией отвечать по источникам.
- Проверить ссылки на пункты, числовые значения и полноту ответа.
Если требуется сравнить все условия договора, лучше сначала сформировать перечень критериев, извлечь значения по каждому разделу, а затем выполнить итоговое сравнение. Это снижает риск пропуска исключений.
Подсчёт токенов и диагностика запросов
Перед отправкой большого промпта нужно оценить его длину. Для моделей OpenAI можно использовать библиотеку tiktoken.
Пример подсчёта на Python
import tiktoken

text = """
Контекстное окно определяет,
сколько токенов модель может учитывать.
"""

encoding = tiktoken.encoding_for_model("gpt-4o")
tokens = encoding.encode(text)

print("Количество токенов:", len(tokens))
Для другой модели может потребоваться отдельный токенизатор. Если точное соответствие неизвестно, можно использовать доступную кодировку как ориентир, но итоговую оценку стоит сверять с API.
Для моделей Hugging Face используют transformers:
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained(
    "meta-llama/Meta-Llama-3-8B"
)

text = "Пример текста для подсчета токенов."

tokens = tokenizer.encode(
    text,
    add_special_tokens=True
)

print(len(tokens))
Для закрытых моделей доступ к токенизатору может отсутствовать. Тогда применяют официальные средства подсчёта токенов провайдера.
Как проверить фактический расход
В API OpenAI после выполнения запроса можно проверить поле usage в ответе. Для Chat Completions доступны, в частности:
- prompt_tokens — количество входных токенов;
- completion_tokens — количество токенов ответа;
- total_tokens — общий расход.
При использовании других API названия полей отличаются. В некоторых системах отдельно учитываются токены кеша, мультимодальные данные и внутренние затраты на рассуждение.
Счётчик входных токенов полезен для мониторинга. Например, если после добавления истории диалога расход вырос с 5 000 до 30 000 токенов, стоит проверить, какие сообщения действительно нужны для текущей задачи.
Обработка превышения лимита в приложении
В некоторых API ошибка переполнения может обозначаться как context_length_exceeded. Конкретный код и формат ошибки зависят от провайдера и используемого интерфейса.
При обработке исключения приложение должно:
- определить, связана ли ошибка с длиной запроса;
- сократить историю или выбрать релевантные фрагменты;
- повторно проверить размер входа и резерв для ответа;
- выполнить ограниченное число повторных запросов.
Бесконечные повторы бесполезны, неизменённый запрос снова превысит лимит. Также нельзя автоматически удалять начало переписки без учёта зависимостей, поскольку там могут находиться системные инструкции или важные ограничения.
Контекстное окно и долговременная память
Контекст доступен в рамках текущей обработки. После завершения запроса его содержимое само по себе не становится постоянной памятью модели.
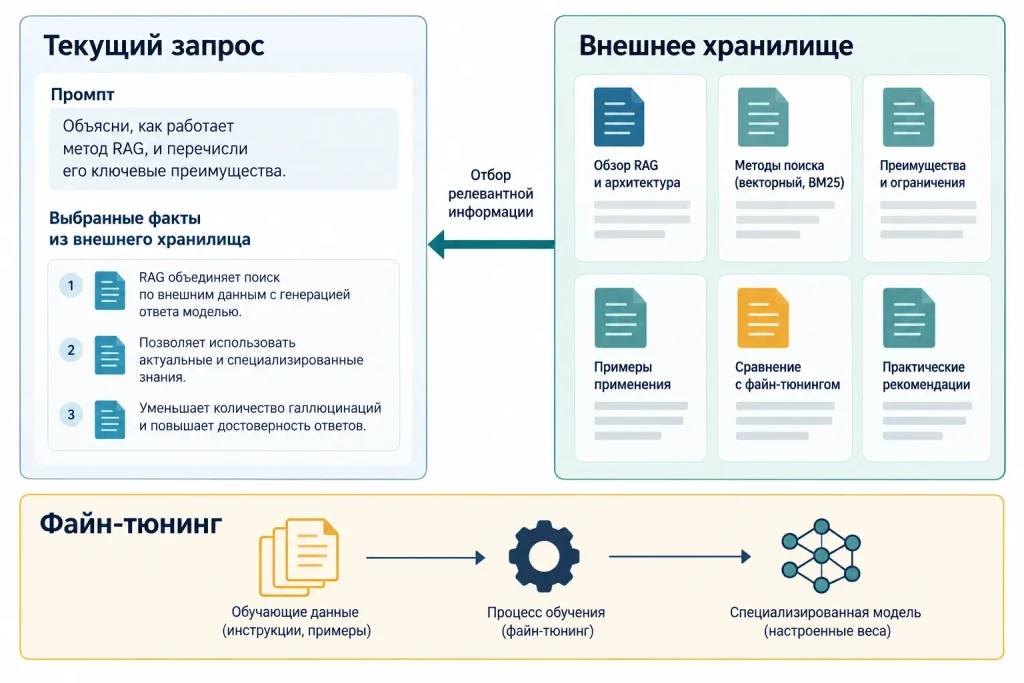
Способы предоставления и сохранения информации:
| Механизм | Что хранит |
| Контекст | Данные текущего запроса |
| RAG | Документы и записи во внешнем хранилище |
| Файн-тюнинг (fine-tuning) | Изменения параметров модели в результате дополнительного обучения |
| Внешняя память | Сохранённые факты, настройки и историю пользователя |
Файн-тюнинг не подходит для оперативного хранения постоянно меняющихся документов. Для этого лучше использовать внешнюю базу знаний. RAG тоже не гарантирует сохранение всех сведений: качество зависит от индексации и поиска.
Безопасность и очистка контекста
История переписки может содержать персональные данные, ключи API, внутренние документы и коммерческую информацию. Перед отправкой данных во внешнюю модель нужно учитывать политику хранения провайдера, условия обработки и требования организации.
Очистка контекста (context clearing) подразумевает удаление или исключение ненужных данных из последующих запросов. Она не гарантирует удаления информации из логов, резервных копий или истории сервиса.
Отдельный риск представляет инъекция промпта (prompt injection). Злоумышленник может разместить в документе инструкции, которые попытаются изменить поведение модели. Поэтому найденный текст нужно считать недоверенными данными, ограничивать права инструментов и проверять операции с чувствительной информацией.
Будущее длинного контекста
Развитие длинных последовательностей связано с несколькими направлениями:
- распределённые вычисления внимания, включая Ring Attention;
- ускорители с большей пропускной способностью памяти;
- оптимизация KV cache и позиционного кодирования;
- гибридные архитектуры, сочетающие внимание с более экономичными механизмами обработки последовательностей.
Бесконечный контекст остаётся исследовательской целью, а не стандартной возможностью существующих моделей. Даже если технические ограничения длины будут сняты, стоимость обработки, задержки и качество извлечения информации сохранят значение.
FAQ
Нет. Увеличение окна расширяет доступный объём информации, но не гарантирует точного извлечения фактов. На результат влияют качество данных, положение нужного фрагмента и способность модели работать с длинными последовательностями.
Иногда диапазон поддерживаемых позиций расширяют с помощью масштабирования позиционного кодирования или дополнительного обучения. Простое изменение параметра максимальной длины не гарантирует корректную работу на новых размерах.
Да. Длинный вход увеличивает время предварительной обработки (prefill) и расход памяти. Во время генерации модель также использует накопленный KV cache. Скорость зависит от архитектуры, оборудования и длины ответа.
Это зависит от приложения. Само контекстное окно не обеспечивает постоянное хранение переписки. Сервис может отдельно сохранять историю и добавлять её в последующие запросы.
Да, если модель и API поддерживают соответствующий формат. Изображения, страницы PDF и другие мультимодальные данные могут учитываться по собственным правилам преобразования в токены. Поэтому размер исходного файла в мегабайтах не показывает точный расход контекста.
Максимальный контекст ограничивает совокупный объём данных, доступных в рамках запроса и генерации. Максимальная длина ответа задаёт отдельный предел выходных токенов. Даже при большом контекстном окне модель может иметь меньший лимит генерации.