Локальный ИИ запускает языковую модель на компьютере и после загрузки может работать без интернета. Он пригодится для текстов, документов и кода, если вы хотите реже передавать данные внешним сервисам. Дальше покажем, какой компьютер нужен, как выбрать модель и запустить первый чат через LM Studio или Ollama.
Что называют локальным ИИ
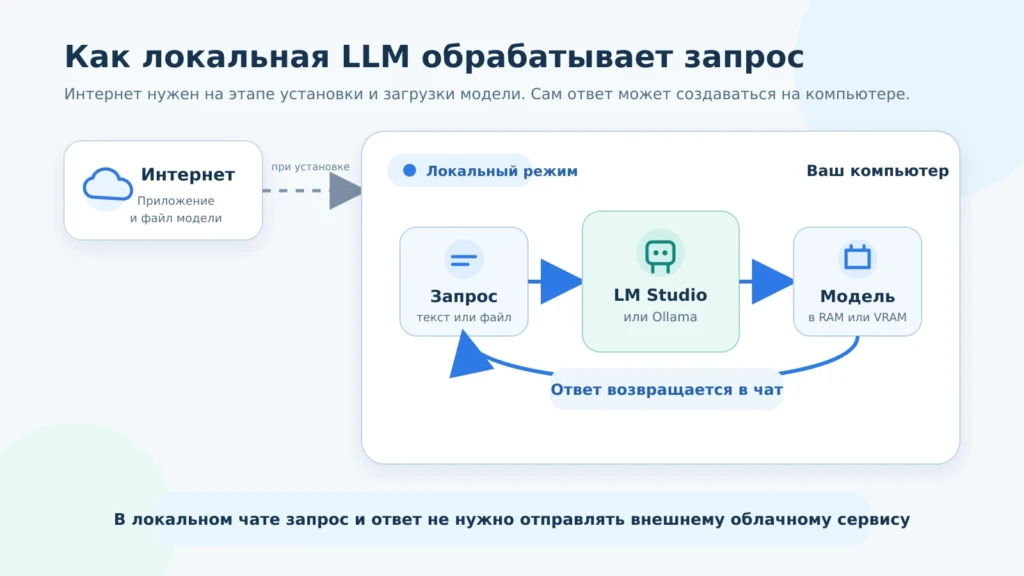
Локальный ИИ — это программа с нейросетевой моделью, которая выполняет вычисления на вашем компьютере. Запрос обрабатывают процессор, видеокарта и оперативная память устройства, а ответ возвращается в локальное приложение. После установки программы и загрузки модели такой чат может работать без интернета.
В этом сценарии вы запускаете уже обученную модель, например Qwen или Gemma. Создание нейросети с нуля устроено иначе: для него нужны данные, код, обучение и проверка качества. Если интересует именно разработка собственной модели или ассистента, в AffTimes есть отдельный материал о том, как создать свой ИИ.
Чем локальная LLM отличается от облачного чат-бота
Облачный чат-бот выполняет вычисления на серверах провайдера. Локальная большая языковая модель, или LLM, загружается на ваш компьютер и использует его ресурсы. Разница становится заметна при работе без сети, обработке внутренних материалов и выборе модели под конкретное устройство.
| Критерий | Локальная модель | Облачный сервис |
| Где создаётся ответ | На компьютере пользователя | На серверах провайдера |
| Нужен ли интернет | Для установки и загрузки модели; локальный чат затем работает без сети | Обычно нужен для каждого запроса |
| Что требуется от компьютера | Достаточно RAM, места на диске и подходящего процессора; видеокарта ускоряет работу | Подходит даже слабое устройство с браузером |
| Выбор моделей | Пользователь сам скачивает совместимые модели и версии | Набор определяет сервис и тариф |
| Расходы | Нет оплаты за каждый локальный запрос, но остаются затраты на устройство и электричество | Возможны подписка, лимиты или оплата токенов через API |
| Работа с данными | Локальные запросы не нужно передавать внешней модели | Данные обрабатывает провайдер по своим условиям |
Локальный запуск сам по себе не даёт абсолютной конфиденциальности. Файлы могут попадать в резервные копии, историю приложения или журналы системы, а дополнительные облачные функции используют сеть. На рабочем компьютере сначала проверьте правила компании и права на обработку документов.
Какой компьютер нужен для локальной нейросети
Для первого знакомства удобно ориентироваться на 16 ГБ оперативной памяти, или RAM. Небольшая модель запустится и на 8 ГБ, но системе останется мало свободной памяти, поэтому ответы будут медленнее, а длинные документы могут не поместиться в контекст. Дискретная видеокарта ускоряет генерацию, хотя небольшие модели умеют работать на процессоре. Память видеокарты обычно обозначают как VRAM.
Практический ориентир для текстового чата выглядит так:
| Оперативная память | С чего начать | Для каких задач хватит |
| 8 ГБ | Модель около 1–2 млрд параметров | Короткие вопросы, небольшие фрагменты текста, знакомство с интерфейсом |
| 16 ГБ | Квантованная модель около 4 млрд параметров | Черновики, резюме, классификация, диалоги средней длины |
| 32 ГБ и больше | Модели 8–14 млрд параметров | Более сложные запросы и больший контекст, если модель помещается в память |
Параметры — это числовые настройки, которые модель получила во время обучения. Их количество помогает оценить размер модели, но не равно расходу памяти при запуске. На загрузку также влияют квантование, длина контекста и дополнительные компоненты. Файл модели Qwen3 4B в четырёхбитной версии занимает около 2,5 ГБ, однако приложению понадобится больше оперативной памяти для работы.
LM Studio или Ollama: что выбрать
LM Studio подходит для первого запуска: в нём есть поиск моделей, загрузка, чат и локальный сервер. Ollama удобна для терминала и интеграций, поскольку может принимать запросы от скрипта, сайта или другого приложения.
| Инструмент | Когда удобнее | Что потребуется |
| LM Studio | Нужен графический интерфейс и быстрый запуск без кода | Скачать приложение, выбрать модель и открыть чат |
| Ollama | Нужны команды, локальный API и подключение к другим программам | Установить приложение и выполнить одну команду в терминале |
Оба приложения доступны для Windows, macOS и Linux. LM Studio на Mac требует Apple Silicon и macOS 14 или новее; компьютеры Mac с Intel не поддерживаются. Для Windows x64 нужен процессор с AVX2, а официальная Linux-версия рассчитана на Ubuntu 20.04 или новее. Для обычного чата достаточно графического интерфейса LM Studio, а локальный API проще запустить через Ollama.
Как установить локальный ИИ через LM Studio
LM Studio позволяет скачать совместимую модель и запустить её в чате без ручной настройки Python. Для первого запуска откройте раздел Discover: там находятся поиск моделей и варианты файлов для загрузки.
- Скачайте LM Studio с официальной страницы и установите приложение для своей операционной системы.
- Откройте раздел Discover. На Windows и Linux можно нажать Ctrl + 2, на macOS — Cmd + 2.
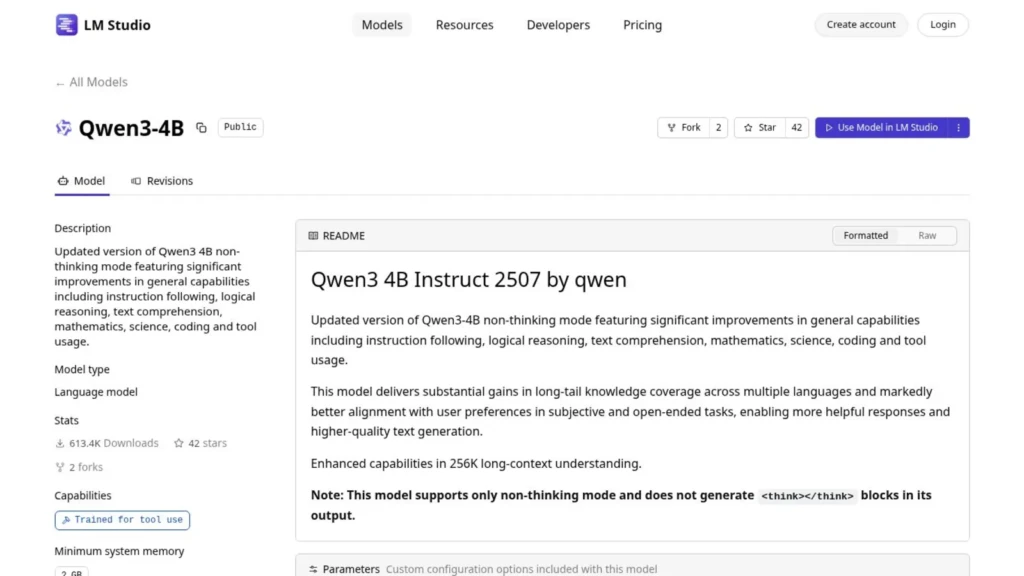
- Введите qwen/qwen3-4b-2507 и откройте карточку Qwen3-4B. Это многоязычная Instruct-модель: её настроили для диалога и выполнения инструкций, в том числе на русском языке.
- На экране загрузки оставьте четырёхбитный вариант, который LM Studio рекомендует для устройства. Для формата GGUF обычно подходит Q4_K_M: такой файл занимает меньше места и памяти, чем версия без квантования.
- Дождитесь загрузки, создайте новый чат и выберите скачанную модель. При первом запуске оставьте остальные параметры по умолчанию.
- Отправьте короткий тестовый запрос и проверьте, что модель отвечает по-русски и соблюдает указанный формат.
Модель можно открыть и через браузер. Перейдите на официальную карточку Qwen3-4B и нажмите Use Model in LM Studio: установленное приложение откроет выбранную модель и предложит загрузку.
Для первого теста подойдёт запрос, в котором легко заметить выдуманные детали:
Сократи текст до пяти тезисов. Используй только факты из исходника. Если в тексте нет ответа на важный вопрос, укажи, каких данных не хватает. Исходный текст: [вставьте небольшой фрагмент].
Сравните тезисы с исходником. Хороший результат сохраняет факты, не добавляет имён и цифр и соблюдает заданное количество пунктов. Если ответ получился слишком общим, добавьте аудиторию, цель и желаемый формат, а затем повторите запрос.
Где локальная модель пригодится читателям AffTimes
Вебмастер, маркетолог или автор может использовать локальную LLM как помощника для черновой обработки материалов. Модель умеет сокращать брифы, группировать отзывы, выделять тезисы из интервью, приводить заголовки к одному формату и искать повторяющиеся темы в текстовой выгрузке. Внутренние документы стоит передавать модели только в пределах правил компании, даже если вычисления идут на вашем устройстве.
Для стабильного результата задайте модели четыре вещи: задачу, исходные данные, ограничения и формат ответа. Например, вместо просьбы «проанализируй отзывы» укажите категории, запретите додумывать причины и попросите вернуть таблицу с цитатой для каждого вывода. Навыки работы с запросами пригодятся и в локальных, и в облачных нейросетях: меняется место вычислений, а требования к постановке задачи и проверке ответа остаются.
Курс «Практикум по нейросетям» в Академии IT DMS
Цифровой сертификат после итогового теста.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Локальная модель тоже может придумывать факты и уверенно ошибаться. Для дат, характеристик продукта, юридических условий и статистики нужен первоисточник. Причины таких ошибок и способы снизить их число разобраны в статье про галлюцинации нейросетей.
Как запустить локальную LLM через Ollama
Ollama удобна, если вы нормально относитесь к терминалу или планируете подключить модель к другой программе. Команда ollama run сама скачивает выбранную модель при первом запуске и затем открывает диалог.
- Установите Ollama с официальной страницы.
- Откройте PowerShell, Windows Terminal или обычный терминал.
- Запустите компактную многоязычную модель:
ollama run qwen3:4b-instruct- После загрузки введите вопрос прямо в терминале. Чтобы закончить диалог, наберите /bye.
При следующем запуске Ollama возьмёт модель с диска и не станет скачивать её заново. Команда ollama list показывает установленные модели, а ollama ps — куда загружена активная модель: в системную память, видеопамять или частично в обе.
Можно ли пользоваться локальным ИИ без интернета
Да, локальная нейросеть работает без интернета после установки приложения, движка и файла модели. В LM Studio без сети доступны чат с загруженной моделью, обработка документов и локальный сервер. Поиск новых моделей, загрузка файлов модели и обновление программы требуют подключения.
Проверить режим можно сразу после первого ответа: отключите сеть и отправьте ещё один короткий запрос. Если выбран именно локальный файл, генерация продолжится. Облачная модель, веб-поиск и внешние инструменты при таком тесте работать не будут.
Как подключить локальную модель к сайту или скрипту
Ollama запускает локальный API по адресу http://localhost:11434. Скрипт отправляет туда текст, модель обрабатывает его на компьютере и возвращает ответ в JSON. Так можно собрать внутренний помощник для сортировки обращений, подготовки сводок или черновой разметки контента.
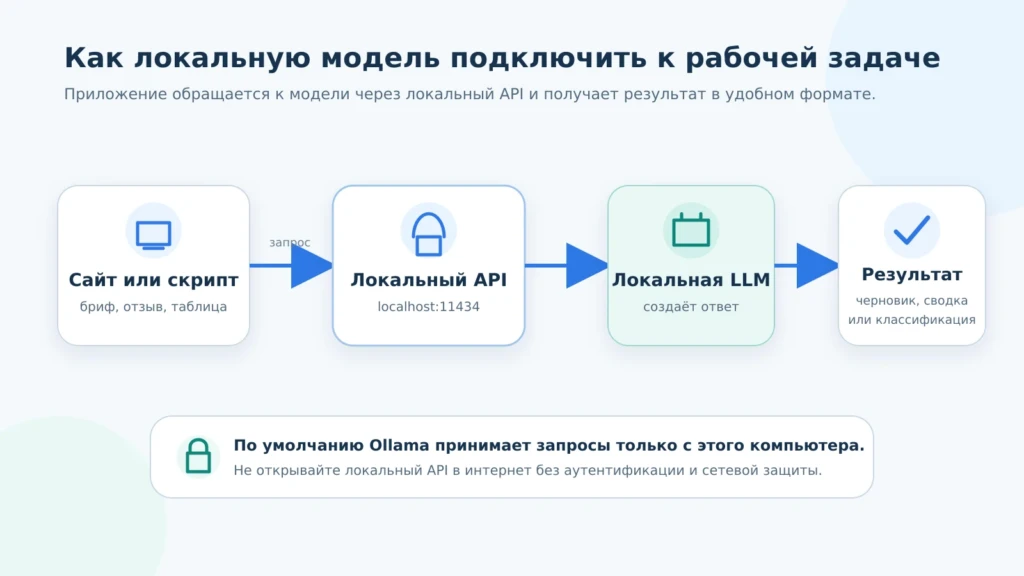
По умолчанию API Ollama доступен только на том компьютере, где запущена модель. Для первого запуска оставьте эту настройку. Если к модели должны обращаться другие устройства, серверу понадобятся защита входа и сетевые ограничения; открывать его напрямую в интернет не следует.
Чат можно подключить к сайту или внутренним документам. Для этого разработчик настраивает API, задаёт правила ответа и проверяет модель на типичных запросах. Если ассистент должен искать сведения в базе знаний, к нему добавляют RAG: система находит подходящие фрагменты и передаёт их модели вместе с вопросом. Эмбеддинги помогают находить похожие по смыслу фрагменты, а векторное хранилище сохраняет их для поиска.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Что делать, если локальная модель не запускается
Большинство проблем связано с нехваткой памяти, слишком большой моделью или тем, что приложение не запущено. Начните с наблюдаемого симптома и меняйте один параметр за раз.
| Что происходит | Возможная причина | Что попробовать |
| Модель не загружается, появляется ошибка памяти | Модель и контекст не помещаются в RAM или VRAM | Закрыть тяжёлые программы, выбрать модель меньшего размера или вариант Q4 |
| Ответ создаётся очень медленно | Вычисления идут на процессоре или модель слишком велика | В Ollama выполнить ollama ps, затем выбрать меньшую модель; в LM Studio проверить оценку памяти перед загрузкой |
| Модель плохо отвечает по-русски | Выбрана модель без достаточной языковой поддержки или базовая версия без настройки на диалог | Взять многоязычную Instruct-модель и явно указать язык ответа |
| Ответ обрывается или забывает начало текста | Документ длиннее доступного контекста | Разделить материал на части или увеличить контекст, если хватает памяти |
| Модели не находятся без сети | Каталог и загрузка требуют интернета | Подключиться, скачать нужный файл и затем вернуться к локальной работе |
| API не отвечает | Ollama или локальный сервер LM Studio не запущен | Запустить приложение и повторить обращение к localhost |
Длина контекста определяет, сколько токенов модель видит в одном запросе вместе с историей диалога. Увеличение контекста требует дополнительной памяти, поэтому максимальное значение из карточки модели не всегда подходит конкретному компьютеру. Подробнее о токенах и лимитах можно прочитать в отдельном разборе AffTimes.
Когда локальный ИИ подходит лучше облачного
Локальный запуск удобен для регулярной работы с небольшими текстами, офлайн-доступа, экспериментов с моделями, у которых доступны веса, и сценариев, где данные желательно оставить на устройстве. Он также позволяет обращаться к модели через локальный API без оплаты каждого запроса.
На обычном компьютере облачный сервис обычно даёт доступ к более крупным моделям, готовому веб-поиску, генерации изображений и другим инструментам без требований к вашему устройству. Если на устройстве меньше 8 ГБ RAM, нужна большая модель или приходится обрабатывать много запросов одновременно, облачный вариант окажется практичнее.
Для первого запуска достаточно проверить объём памяти, установить LM Studio и скачать небольшую многоязычную модель. Начните с короткого текста, задайте проверяемый формат ответа и сравните результат с исходником. После этого станет понятно, хватает ли компьютера и нужна ли вам интеграция через Ollama.
FAQ
Да, небольшую локальную LLM можно запустить на обычном компьютере. Для комфортного первого опыта желательно 16 ГБ RAM, а на 8 ГБ лучше выбирать модели около 1–2 млрд параметров и короткие запросы.
Видеокарта не обязательна для небольших моделей: они умеют работать на процессоре и использовать системную память. GPU заметно ускоряет ответы, если модель помещается в видеопамять и приложение поддерживает эту видеокарту.
Для первого запуска подойдёт многоязычная Instruct-модель, например Qwen3 4B. Перед рабочим использованием проверьте её на своих текстах: качество русского языка и точность зависят от задачи, размера модели и формулировки запроса.
За генерацию на собственном устройстве обычно не взимается плата за каждый запрос. Пользователь оплачивает компьютер, электричество и хранение файлов, а лицензия конкретной модели может ограничивать отдельные способы применения.
При работе с загруженной локальной моделью LM Studio или Ollama не нужно отправлять текст внешней модели. Облачные модели, веб-поиск, обновления и сторонние интеграции используют сеть, поэтому перед конфиденциальной задачей проверьте выбранный режим и настройки приложения.