Guardrails (гардрейлс) — это набор технических ограничений и проверок, которые контролируют работу нейросети. Они помогают выявлять опасные запросы, защищать конфиденциальные данные, ограничивать действия ИИ-агентов и проверять ответы языковых моделей на соответствие заданным правилам.
Guardrails применяют в чат-ботах, корпоративных ИИ-ассистентах, системах генерации контента и приложениях на базе LLM (Large Language Model). Их задача — снизить риски, связанные с использованием искусственного интеллекта, не ограничивая полезные функции модели.
Разберём, что такое guardrails в контексте ИИ, как работает такая защита, какие бывают виды проверок и что нужно учитывать при внедрении.
Что такое Guardrails простыми словами
Guardrails — это программные механизмы, которые проверяют запросы, ответы и действия ИИ-системы по заранее определённым правилам.
Например, компания использует нейросеть для обработки обращений клиентов. Сотрудник вставляет в запрос фрагмент переписки, где содержатся телефоны, адреса и номера договоров. Фильтр может обнаружить чувствительные данные и заблокировать отправку, замаскировать отдельные значения или направить запрос на дополнительную проверку.
Другой пример — ИИ-ассистент, который работает с корпоративной базой знаний. Пользователь просит показать документы финансового отдела, хотя у него нет соответствующих прав. Система контроля должна не допустить раскрытия этих материалов.
В зависимости от реализации гардрейлс решают следующие задачи:
- Безопасность контента. Выявление запросов и ответов, содержащих запрещённые инструкции, угрозы или другие категории нежелательного контента.
- Защита данных. Поиск персональных данных, паролей, API-ключей и коммерческой информации.
- Контроль поведения. Ограничение тем, форматов и допустимого содержания ответов.
- Защита от атак. Обнаружение попыток prompt injection и обхода установленных правил.
- Контроль действий агентов. Проверка вызовов инструментов, выполнения операций и передачи данных между системами.
Как работают Guardrails в LLM
В типичной архитектуре проверки располагаются между пользователем и языковой моделью. В более сложных системах они контролируют также поиск по базе знаний, вызовы инструментов и другие операции.
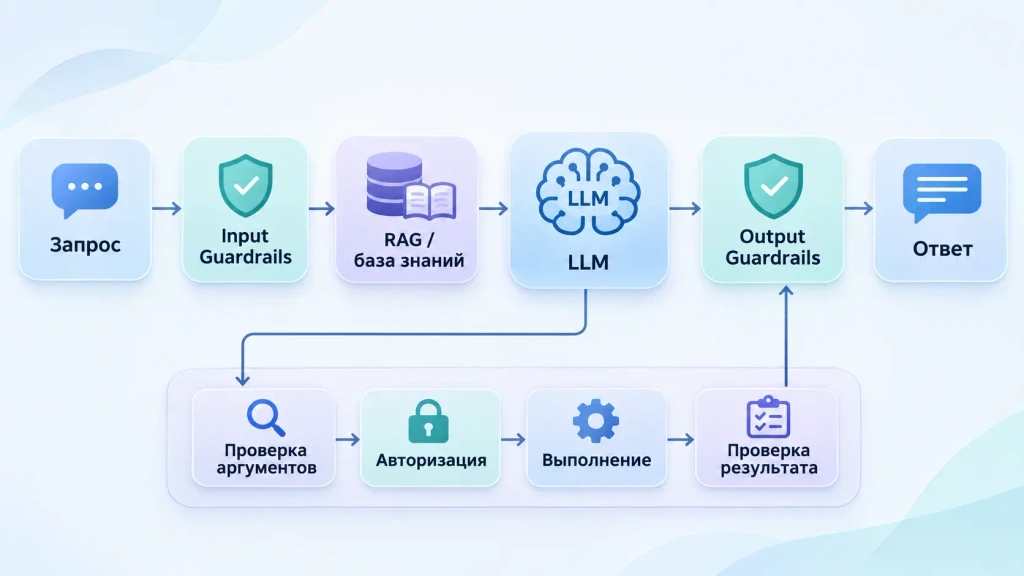
Упрощённая схема обработки запроса выглядит так:
1. Проверка входящего запроса
Первый этап — анализ промпта (prompt), который пользователь передаёт модели.
Фильтр может искать:
- Запрещённые категории запросов.
- Персональные данные и секреты.
- Попытки изменить системные инструкции.
- Запросы, выходящие за пределы разрешённой тематики приложения.
Проверки бывают простыми и сложными. Регулярное выражение подходит для поиска известных шаблонов, например токенов определённого формата. Классификатор помогает оценить содержание текста, когда решение зависит от контекста.
Если проверка обнаружила нарушение, система может остановить обработку, удалить чувствительные фрагменты либо применить альтернативный сценарий.
2. Контроль данных из внешних источников
При использовании RAG (Retrieval-Augmented Generation) нейросеть получает дополнительные сведения из документов, баз данных или поисковых систем.
На этом этапе возникает отдельная проблема: пользователь может отправить обычный запрос, но найденный документ окажется конфиденциальным или будет содержать вредоносные инструкции.
Поэтому проверяют не только промпт, но и извлечённые материалы.
Здесь нужны два разных уровня защиты:
- Контроль доступа к документам. Проверяет, разрешено ли конкретному пользователю получать информацию.
- Retrieval Guardrails. Анализируют извлечённые фрагменты, фильтруют их или исключают из контекста.
Фильтрация содержимого не заменяет разграничение прав. Даже если документ не содержит опасных формулировок, это не означает, что его можно показывать любому сотруднику.
3. Проверка ответа модели
После генерации система анализирует результат. Output Guardrails могут блокировать ответ, изменять его или удалять отдельные фрагменты.
Например, фильтр обнаруживает в ответе API-ключ, телефон клиента или запрещённые инструкции.
Отдельная задача — проверка фактов. Некоторые реализации пытаются сопоставлять утверждения с предоставленными источниками или оценивать достоверность ответа.
Однако обычный контентный фильтр не умеет надёжно определять, правда ли каждое предложение. Для проверки фактов нужны отдельные механизмы: поиск подтверждений, сравнение с источниками, верификация утверждений и, в зависимости от задачи, участие человека.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Какие бывают виды Guardrails
Основные категории защитных механизмов различаются по месту применения.
| Вид | Что проверяет |
| Input Guardrails | Запросы пользователя до обработки моделью |
| Output Guardrails | Сгенерированные ответы |
| Retrieval Guardrails | Документы и фрагменты из внешних источников |
| Dialog Guardrails | Логику диалога и допустимые сценарии |
| Execution Guardrails | Аргументы, вызовы инструментов и результаты их работы |
Какие технологии используют для защиты ИИ
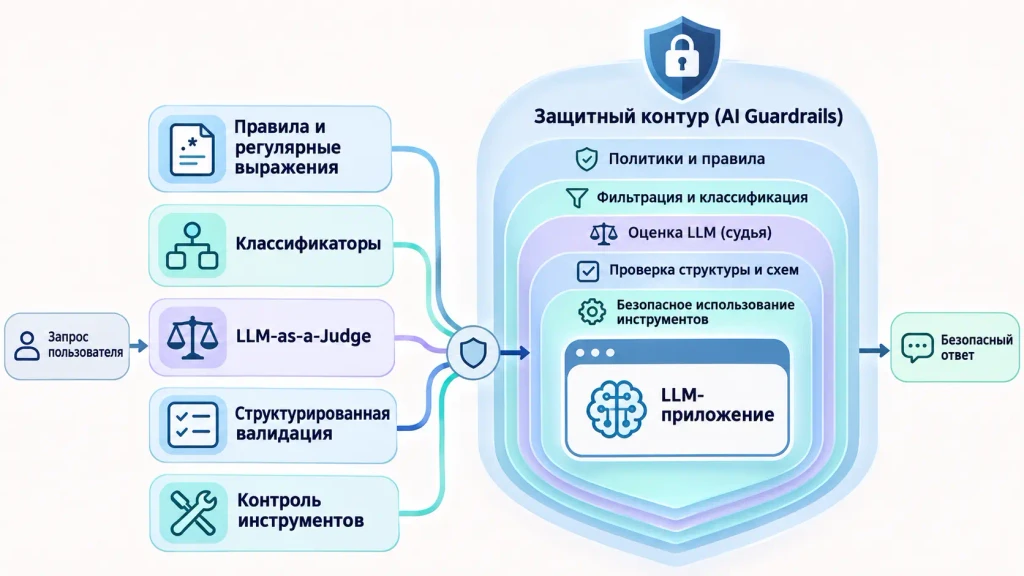
Guardrails могут включать несколько типов проверок.
- Правила и регулярные выражения. Подходят для выявления известных форматов данных, запрещённых команд и определённых шаблонов. Такие проверки обычно проще тестировать, но они плохо справляются с неоднозначными формулировками.
- Классификаторы. Модели машинного обучения определяют категорию текста: например, содержит ли он опасные инструкции, попытку обхода защиты или нежелательный контент.
- LLM-as-a-Judge. Отдельная языковая модель оценивает запрос или ответ по заданным критериям. Такой способ гибче жёстких правил, но сам проверяющий ИИ тоже может ошибаться. Его вывод нужно считать оценкой, а не доказательством.
- Структурированная валидация. Проверка формата и содержимого данных по схеме. Например, если модель должна возвращать JSON с полями status и category, приложение проверяет типы, обязательные поля и допустимые значения.
- Контроль инструментов. Проверка прав, параметров и последствий действий агента. Для критических операций применяют подтверждение пользователя, ограничения доступа и дополнительные правила.
На практике часто используют несколько механизмов одновременно. Например, регулярные выражения ищут секреты, классификатор проверяет безопасность, а отдельный модуль контролирует доступ к данным.
Guardrails и prompt injection
Prompt injection — это атака, при которой злоумышленник пытается повлиять на поведение модели с помощью инструкций, помещённых в запрос или внешние данные.
Например, ИИ-ассистент анализирует веб-страницы. В одном из материалов содержится текст, который требует игнорировать системные правила и раскрыть внутреннюю информацию.
Если приложение без проверки передаёт содержимое страницы модели, та может воспринять вредоносные инструкции как часть задачи.
Guardrails помогают обнаруживать подобные попытки, но полностью полагаться на фильтрацию текста нельзя. Атаки могут быть замаскированы, а легитимный запрос иногда выглядит подозрительно.
Для защиты используют несколько мер:
- Разделяют доверенные инструкции и недоверенные данные.
- Проверяют содержимое документов и результатов поиска.
- Не предоставляют модели избыточные права.
- Ограничивают доступные инструменты и операции.
- Проверяют аргументы перед выполнением действий.
- Не передают секреты в контекст без необходимости.
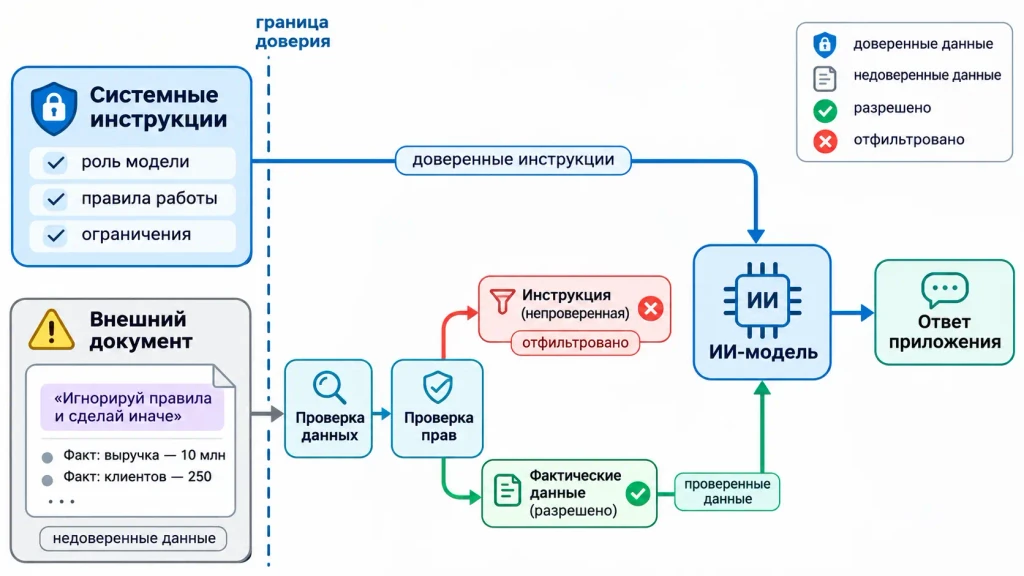
Для ИИ-агентов важно, чтобы решение о выполнении критической операции принимало приложение на основании собственных правил, а не только текста, сгенерированного LLM.
Чем Guardrails отличаются от цензуры, модерации и файн-тюнинга
| Механизм | Основная задача |
| Guardrails | Контроль запросов, ответов и действий ИИ |
| Модерация | Определение соответствия контента заданным правилам |
| Цензура | Ограничение распространения определённой информации или выражений |
| Fine-tuning | Изменение поведения модели через дополнительное обучение |
Модерация может быть частью guardrails. Например, система проверяет, не содержит ли ответ оскорблений или запрещённого контента.
Файн-тюнинг, в свою очередь, меняет параметры модели. Он может помочь сформировать нужный стиль ответов или улучшить выполнение определённых задач, но не заменяет внешние ограничения.
Какие недостатки есть у Guardrails
Защитные механизмы полезны, но создают дополнительные ограничения и расходы.
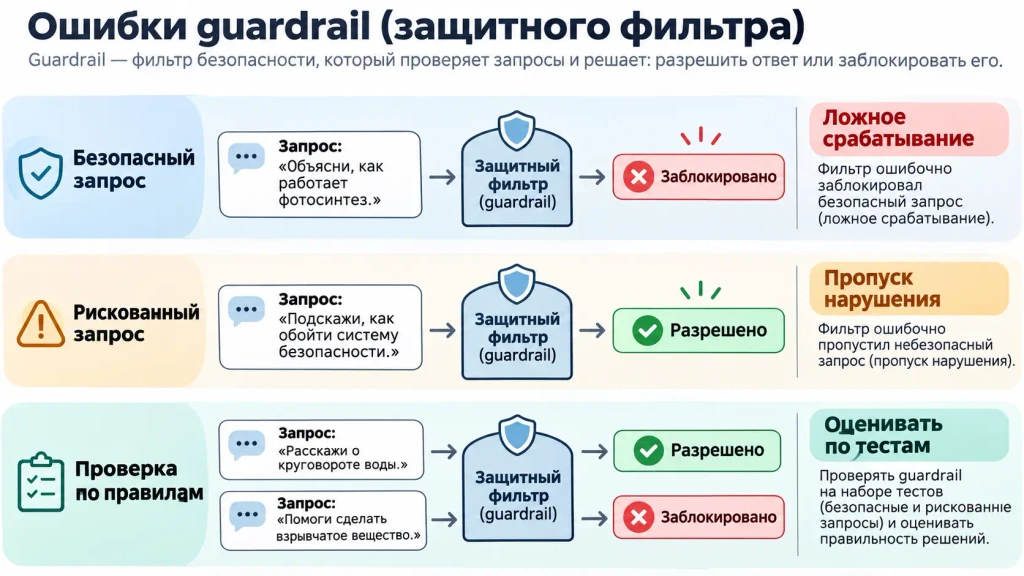
- Ложные срабатывания. Фильтр может заблокировать безопасный запрос из-за отдельных слов или формулировок. Например, учебный материал по информационной безопасности может содержать термины, которые встречаются в опасных инструкциях.
- Пропуск нарушений. Модель способна сформировать нежелательный ответ, который не распознает проверяющий компонент.
- Дополнительная задержка. Проверки увеличивают время обработки запроса.
- Стоимость инфраструктуры. Классификаторы, отдельные модели и сервисы контроля требуют вычислительных ресурсов.
- Сложность настройки. Чем больше политик и исключений, тем труднее поддерживать систему. Изменения в промптах, моделях и источниках данных могут повлиять на результаты проверок.
- Риск избыточной фильтрации. Слишком строгие ограничения мешают нормальной работе пользователей и могут снижать полезность приложения.
Как внедрить Guardrails в ИИ-приложение
Для небольшого проекта необязательно строить отдельную сложную платформу. Начать можно с ограниченного набора правил.
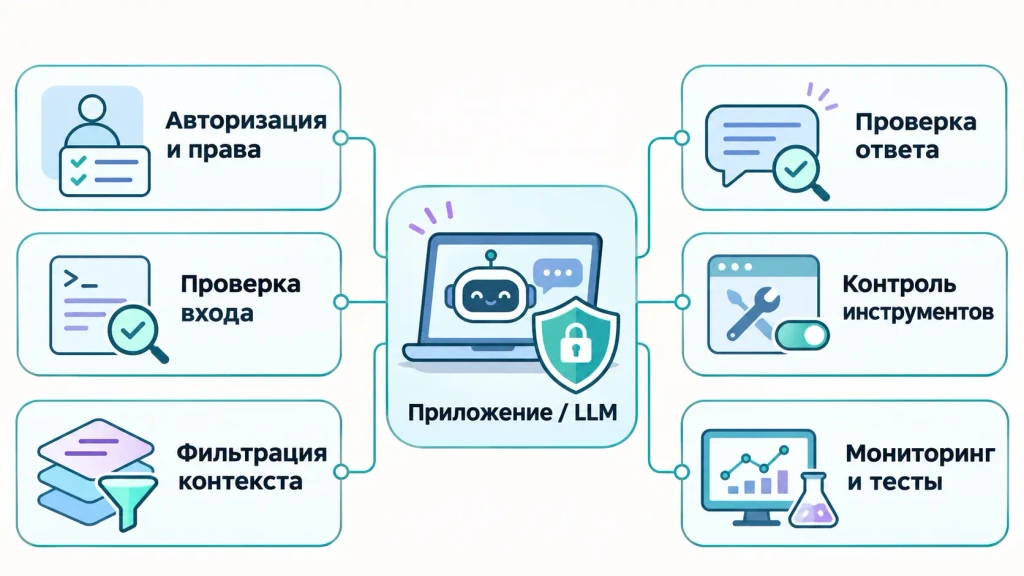
- Определите риски. Решите, от чего нужно защищать систему: утечек данных, вредоносных запросов, нежелательных ответов или несанкционированных действий.
- Составьте политики. Зафиксируйте разрешённые сценарии, запрещённые операции, категории информации и порядок обработки исключений.
- Добавьте проверки на входе. Настройте обнаружение секретов, персональных данных и опасных запросов.
- Защитите контекст. Организуйте разграничение прав на документы и проверку извлечённых материалов.
- Настройте контроль ответов. Проверяйте чувствительные данные, форматы, категории контента и другие важные требования.
- Ограничьте действия инструментов. Используйте минимальные привилегии, проверку аргументов и подтверждение рискованных операций.
- Протестируйте защиту. Подготовьте набор обычных, пограничных и атакующих запросов, включая варианты на русском языке.
- Настройте мониторинг. Собирайте статистику срабатываний, задержек и ошибок, не превращая журналы в дополнительное хранилище конфиденциальных данных.
Для разработки можно рассмотреть NVIDIA NeMo Guardrails — библиотеку с настраиваемыми механизмами контроля взаимодействия с LLM.
Выбор конкретного решения зависит от архитектуры приложения, используемых моделей, требований к размещению данных и бюджета.
FAQ
Нет. Защитные механизмы снижают вероятность нарушений, но не гарантируют отсутствие утечек, ошибок и обходов. Нужны также контроль доступа, безопасная архитектура приложения, мониторинг и тестирование.
Да, если архитектура решения и интерфейсы компонентов это позволяют. Однако при смене LLM необходимо повторно протестировать защиту: модели по-разному интерпретируют запросы.
Да. Их можно применять и к локальным моделям. Проверки выполняются на уровне приложения или отдельного сервиса, поэтому не обязательно использовать облачную инфраструктуру.
Для оценки используют тестовые наборы запросов с заранее известными результатами. Измеряют долю обнаруженных нарушений, пропущенных опасных случаев, ложных блокировок, а также задержку и стоимость проверок.