В рекламной статистике полно привычных обозначений: поиск, Telegram, соцсети, смартфон, компьютер. Для человека всё понятно, но многие алгоритмы машинного обучения не умеют работать с такими значениями напрямую. Чтобы модель могла учитывать их при прогнозах, данные нужно подготовить. Разбираемся, что такое категориальные признаки, зачем их кодируют и как это сделать на Python.
Что такое категориальные признаки простыми словами
Категориальные признаки — это характеристики, которые делят объекты на группы. Например, посетителей сайта можно разделить по источнику трафика, типу устройства или региону.
Допустим, вы хотите создать модель, которая оценивает вероятность заявки после перехода на сайт. Для этого у вас есть история посещений: откуда пришёл человек, какое устройство использовал и оставил ли заявку.
Часть информации представлена числами, а часть — названиями категорий.
| Признак | Пример | Тип данных |
| Время на сайте | 45 секунд | Числовой |
| Количество просмотренных страниц | 3 | Числовой |
| Источник трафика | Telegram | Категориальный |
| Устройство | Смартфон | Категориальный |
| Регион | Москва | Категориальный |
По числовым признакам можно выполнять расчёты. Например, узнать среднее время на сайте или количество просмотренных страниц.
С категориями всё иначе. Нельзя сложить Telegram и поисковый трафик или посчитать среднее между Москвой и Санкт-Петербургом. Но модель может использовать эти характеристики, чтобы искать связи между поведением посетителей и заявками.
Причём категория необязательно записывается словом. Если способы оплаты обозначены числами — 1 для карты, 2 для перевода и 3 для наличных, — это всё равно категориальный признак. Числа здесь заменяют названия, а не обозначают количество.
Какие бывают категориальные признаки
В машинном обучении выделяют два основных типа: номинальные и порядковые.
Номинальные признаки
Это категории, у которых нет определённого порядка. Например, источник трафика может быть поисковым, социальным или из Telegram. Нельзя сказать, что один источник больше другого. У каждого просто своё название.
К номинальным признакам также относятся браузеры, города, способы оплаты и типы устройств.
Порядковые признаки
Здесь категории можно расположить в определённой последовательности.
Например, приоритет обращения:
- Низкий
- Средний
- Высокий
Понятно, что высокий приоритет идёт после среднего, а средний — после низкого.
Для таких категорий можно использовать числовые коды: 0, 1 и 2. Но это не означает, что разница между низким и средним приоритетом обязательно равна разнице между средним и высоким. Это различие пригодится при выборе способа кодирования.
Зачем кодировать категориальные признаки
Представим, что у нас есть данные о посетителях сайта. Мы хотим научить модель учитывать источник перехода при прогнозировании заявки.
В таблице встречаются три значения: «Поиск», «Соцсети» и «Telegram». Для многих алгоритмов их нужно преобразовать в числа. Этот процесс называется кодированием категориальных признаков.
Самый очевидный вариант — заменить названия:
- Поиск — 1
- Соцсети — 2
- Telegram — 3
Но здесь возникает проблема. Некоторые алгоритмы могут решить, что Telegram с кодом 3 «больше» поиска с кодом 1. Хотя никакого такого порядка у источников трафика нет.
Поэтому категории часто кодируют другим способом — One-Hot Encoding.
One-Hot Encoding: как превратить категории в числа
One-Hot Encoding создаёт отдельный столбец для каждой категории. Вместо одного столбца «Источник трафика» получаются три: поиск, соцсети и Telegram.
В каждом ставится 1 или 0.
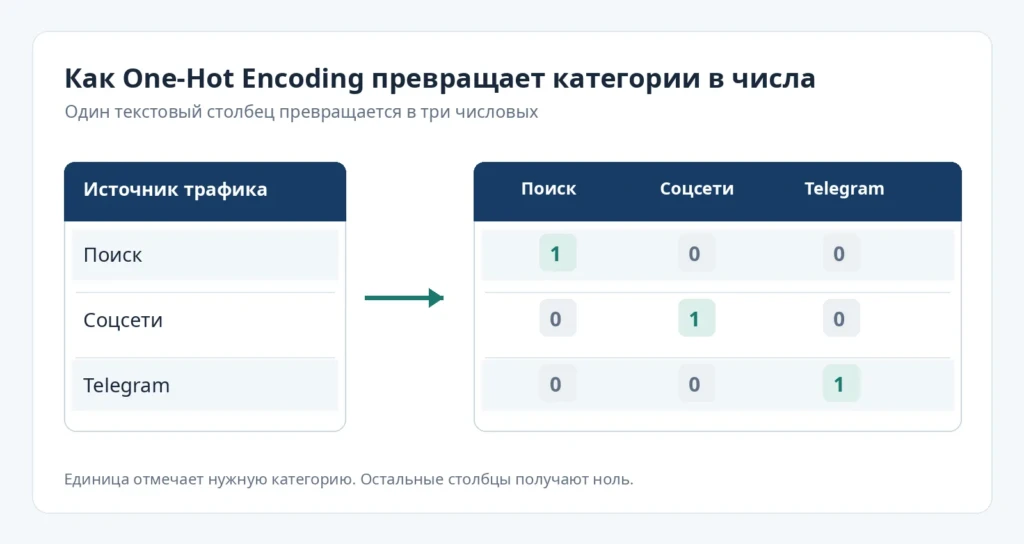
Если посетитель пришёл из Telegram, единица будет стоять в столбце Telegram. В остальных — нули.
Так модель получает числовые данные без искусственного порядка между категориями. Ей не нужно считать, что один источник больше или меньше другого.
Этот способ подходит для признаков с небольшим количеством значений. Например, для типа устройства или нескольких основных источников трафика.
А если в данных сотни рекламных площадок, One-Hot Encoding может создать сотни новых столбцов. Тогда стоит рассмотреть другие способы обработки.
Какие ещё способы кодирования существуют
One-Hot Encoding — не единственный вариант. В машинном обучении используются разные методы, и каждый подходит для своих задач.
Ordinal Encoding заменяет категории числами. Например, низкий приоритет становится 0, средний — 1, высокий — 2. Такой способ удобно использовать, когда у категорий действительно есть порядок.
Target Encoding учитывает связь категории с результатом, который модель должна предсказывать. Например, при прогнозировании заявки он может использовать сведения о доле заявок для разных источников трафика в обучающих данных.
С Target Encoding нужно быть внимательнее: если использовать информацию о правильных ответах при подготовке тех же примеров, модель получит подсказку и покажет завышенное качество. Поэтому для него применяют специальные способы разделения данных.
Есть и алгоритмы, которые умеют самостоятельно обрабатывать категории. Например, CatBoost может принимать категориальные признаки без предварительного One-Hot-кодирования. Более того, разработчики CatBoost рекомендуют не применять One-Hot Encoding вручную перед обучением этой модели.
Для первого знакомства достаточно понимать три варианта:
| Метод | Когда пригодится |
| One-Hot Encoding | Есть несколько категорий без порядка |
| Ordinal Encoding | У категорий есть естественный порядок |
| Target Encoding | Категорий много и нужна информация об их связи с прогнозируемым результатом |
Необязательно сразу изучать все методы. Начать проще с One-Hot Encoding: по получившейся таблице легко проверить, что произошло с данными.
Курс «Data Science и Machine Learning» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
Как закодировать категориальные признаки в Python
Попробуем One-Hot Encoding на небольшом примере. Для этого понадобится Python и библиотека Pandas, которая умеет работать с таблицами.
Установите её через терминал:
python -m pip install pandasТеперь создайте файл encoding.py и добавьте код:
import pandas as pd

data = pd.DataFrame({

    "source": ["Поиск", "Telegram", "Соцсети"]

})

result = pd.get_dummies(

    data,

    columns=["source"],

    dtype=int

)

print(result)
Здесь мы создали небольшой столбец с названиями источников трафика. Команда pd.get_dummies() преобразует его в несколько числовых столбцов.
Запустите программу:
python encoding.pyВ результате появятся столбцы с названиями категорий и значениями 0 или 1. Их порядок может отличаться от таблицы выше, но принцип останется тем же.
Попробуйте добавить ещё один источник трафика и запустить код повторно. Pandas создаст для него отдельный столбец.
Так можно быстро посмотреть, как работает кодирование, без обучения целой модели.
Если хотите применить метод к собственной выгрузке, загрузите CSV-файл через pd.read_csv() и укажите нужный категориальный столбец. Например, источник трафика или устройство посетителя.
Подробнее о работе с таблицами на Python читайте в статье «NumPy и Pandas: в чём разница простыми словами».
А как использовать эти данные для обучения модели?
После кодирования таблицу можно передать алгоритму машинного обучения. Например, попробовать предсказать, оставит ли новый посетитель заявку.
Для обучения понадобятся исторические данные, в которых уже известно, кто оставил заявку, а кто нет. Модель будет искать связи между характеристиками посетителей и результатом, а затем её качество нужно проверить на новых примерах.
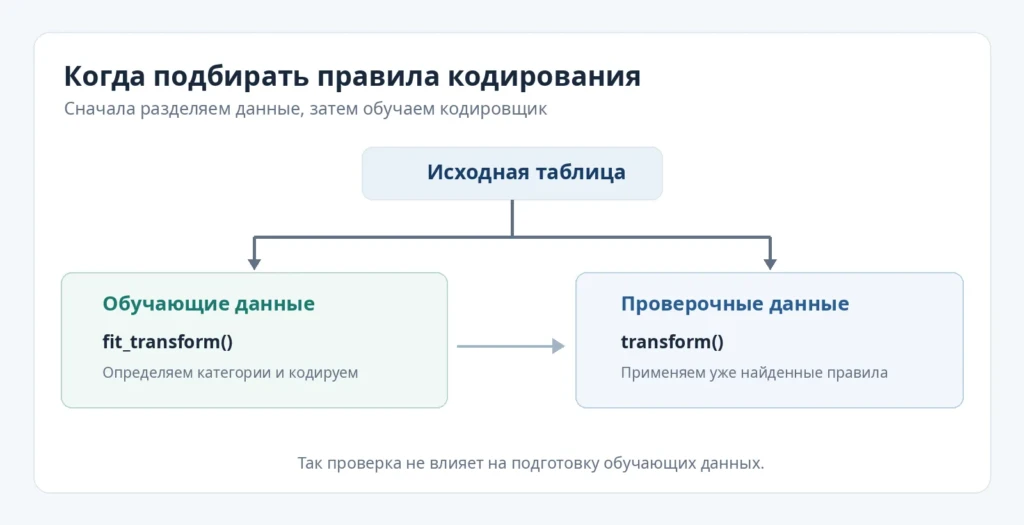
Здесь появляется ещё одно правило: данные для проверки нельзя использовать при настройке кодировщика.
Обычно исходную таблицу сначала делят на обучающую и проверочную части. Кодировщик изучает категории по обучающим данным, а потом применяет те же правила к проверочным.
В scikit-learn для этого используют OneHotEncoder вместе с Pipeline. Такой подход помогает сохранять одинаковую структуру признаков и не подмешивать информацию из проверки в подготовку модели.
Какие ошибки чаще всего допускают при кодировании
Большинство проблем возникает не из-за сложных алгоритмов, а из-за неправильного понимания самих данных.
Присваивают случайные числа категориям. Например, записывают источники трафика как 1, 2 и 3, хотя между ними нет порядка. Для некоторых моделей это приводит к неправильной интерпретации признака.
Создают слишком много столбцов. Если использовать One-Hot Encoding для ID клиентов или номеров заказов, почти каждое значение может превратиться в отдельный признак. Такие данные сначала стоит проверить: возможно, сам идентификатор вообще не нужен модели.
Не учитывают новые категории. Допустим, модель обучали на поиске и соцсетях, а позже появился трафик из нового источника. Кодировщик должен уметь обработать незнакомое значение. В OneHotEncoder для этого есть параметр handle_unknown=»ignore».
Проверяют модель на данных, которые уже использовали для настройки. Из-за этого качество прогноза может казаться выше реального. Особенно опасны такие ошибки при использовании Target Encoding.
Чтобы понять, какой метод подходит лучше, недостаточно посмотреть на готовую таблицу. Нужно обучить модель и проверить, насколько хорошо она работает с новыми данными.
Если модель отлично справляется с примерами, которые уже видела, но ошибается на новых, возможно, возникло переобучение. Мы подробно разбирали эту проблему в статье «Переобучение нейросети: почему возникает и как с ним бороться».
Где категориальные признаки используются на практике
Категориальные признаки встречаются почти везде, где компании работают с данными.
В интернет-магазине модель может учитывать категорию товара и способ оплаты. В службе поддержки — тип обращения и его приоритет. В рекламной аналитике — источник трафика, устройство или регион пользователя.
Например, компания хочет оценивать вероятность покупки по входящим заявкам. Для этого можно использовать источник обращения, категорию товара и другую информацию, известную в момент получения заявки. Модель изучит историю прошлых обращений и попробует найти закономерности.
Но качество прогноза зависит не только от кодирования. Нужны подходящие данные, правильно выбранные признаки и проверка результатов. Если модель знает лишь источник трафика, этого может оказаться недостаточно для полезного прогноза.
Работа с такими задачами входит в машинное обучение — одно из направлений искусственного интеллекта. ML-инженеры готовят данные, обучают модели и подключают их к приложениям. Чем эта работа отличается от разработки сервисов на готовых нейросетях, мы рассказывали в статье «AI/ML-инженер: кто это и чем занимается».
Для первых экспериментов достаточно освоить Python и научиться работать с таблицами. Затем можно переходить к созданию собственных моделей и ИИ-приложений, разбираться в их устройстве и проверять, насколько хорошо они решают реальные задачи.
Курс «Инженер генеративного ИИ» в Академии IT DMS
Сертификат, диплом о переподготовке или удостоверение о повышении квалификации.
AFFTIMES−5 % на первую покупку. Скидка суммируется с любыми акциями школы. Если оплачиваете через менеджера в чате, назовите ему промокод.
FAQ
Категориальные признаки — это характеристики, которые относят объект к определённой группе. Например, источник трафика, тип устройства, регион или способ оплаты.
Основные типы — номинальные и порядковые. У номинальных категорий нет естественного порядка, а порядковые можно расположить в определённой последовательности.
Многим алгоритмам машинного обучения нужны числовые данные. Кодирование преобразует категории в подходящий формат, например в набор столбцов с нулями и единицами.
One-Hot Encoding создаёт отдельный числовой столбец для каждой категории. Единица показывает принадлежность к категории, а ноль — её отсутствие.
Ordinal Encoding присваивает категориям числовые коды, а One-Hot Encoding создаёт отдельные столбцы. Ordinal Encoding особенно полезен для признаков с естественным порядком.
В Python можно использовать OneHotEncoder и OrdinalEncoder из scikit-learn или get_dummies из Pandas. Способ зависит от типа признака, количества категорий и выбранной модели.
Нет. Например, CatBoost и некоторые алгоритмы scikit-learn поддерживают работу с категориями напрямую. Для таких моделей предварительный One-Hot Encoding может быть не нужен.